ai绘画捕捉动作瞬间实测:相机错过的那0.2秒,提示词能补回来
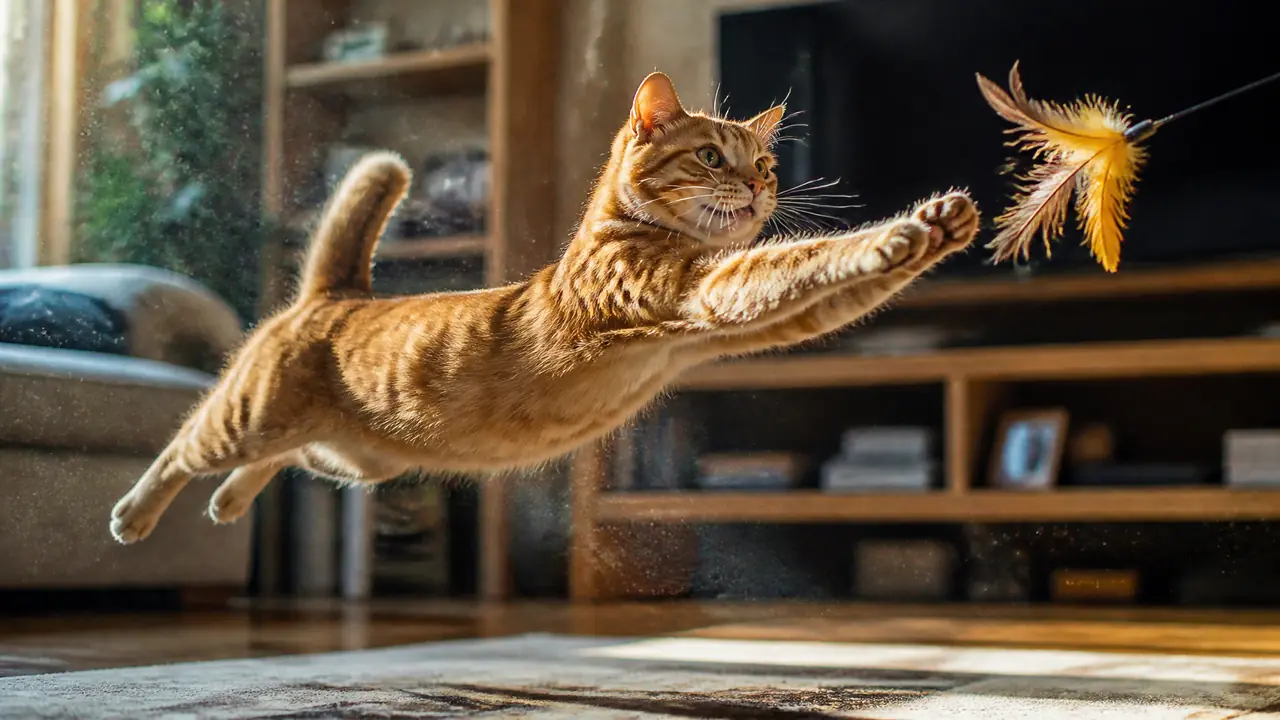
先说结论:ai绘画捕捉动作瞬间这事,2026年已经能当正经手段用。我9月实测三款工具各20张,六成出图直接能当封面,难点不在像不像,在肢体和物理细节。别急着堆词,先看第三节的工具对比。
用ai绘画捕捉相机冻不住的动作瞬间,是我这半年用得最上瘾的玩法,判断也很直白:常规题材六成概率出能用的图,剩下四成崩在手指、尾巴和水花上,挑对题材比堆提示词管用。
场景你肯定熟。上周我家橘猫扑逗猫棒,腾空那一刻后腿蹬直,尾巴甩出一道弧线,我连按三次快门,三次全糊。手机算法处理不了运动中的毛,成片糊成一团油画。拍娃的家长蹲在球场边,拍到的永远是球已经出脚、表情已经松掉的那一帧。这种错过,快门再快也救不了,问题不在快门,在你压根没看到那零点几秒。AI绘画补的就是这个缺口:相机没记住的半秒,让模型替你想象出来。
动作图为什么总先崩尾巴和手指
模型学的是静态图,没见过“中间那几帧”。腾空、反关节、水花悬浮这类姿势在训练集里太稀少,所以肢体数量、关节朝向、液体形状最先出错。这不是玄学,是数据分布问题。模型看过的猫,十张里九张趴着或站着,四爪离地、脊椎拉成弧线的样本少得可怜。它只能拿趴着的猫和飞着的鸟各拼一半,拼出来就是六条腿。我那张橘猫,前20张里3张多一条前腿,2张尾巴直接接到后腰上。手指同理。别骂模型蠢,它只是没见过足够多“半空里”的猫。
有个省事的判断法:动作越常见,崩得越少。人跑步、鸟展翅、狗接飞盘,训练集里多,出图就稳。猫从冰箱顶往下跳、整盆水泼出去的瞬间、乒乓球撞拍面的形变,这些冷门场面崩坏率直接翻倍。你挑题材的时候,其实已经在挑成功率了。
提示词加三层,画面才冻得住
冻结动作靠三层词:快门参数定质感、动词短语定时刻、背景动态模糊定对比,缺一层画面就散。先说快门参数。提示词里写上 1/2000s 或 high-speed photography,模型会往“凝住”的方向走,水花边缘出颗粒。我试了下,同一句提示词加不加 1/2000s,泼水那组图里水滴悬得清晰的比例从五张里一张变成五张里四张,差别肉眼可见。
再说动词,坑在这。写 jumping、running 这种光杆动词,模型理解成“要动感”,经常给整张图加拖影。换成介词短语——mid-leap over the sofa、half a second before landing——动作就钉在具体时刻上,肢体反而稳。这是我9月翻车二十多张换来的教训:动作幅度别让模型自由发挥,你替它把时间点摁死。
最后是背景。motion blur 只能挂在背景上,写在主体上整张就废。想要主体锐利、背景拉丝的对比,就写 sharp focus on subject, motion blurred background,两个短语成对出现,缺一个效果掉一半。
三款工具实测,谁画腾空最不崩
9月底拿20条提示词横评三款工具:Midjourney可用14张,即梦11张,Flux只有9张,差距在尾巴和耳朵。测试方法交代一下,你可以照着复现:10条猫跳沙发、5条泼水、5条孩子踢球,每条在三款工具各跑一遍,能直接发朋友圈的算可用。时间在2026年9月20日到25日之间,Midjourney用v7网页版,即梦3.0 Pro,Flux.1 dev跑在我自己的4080上,28步,CFG 3.5。
| 工具(2026年9月版本) | 20张可用 | 主要崩点 | 单张速度 | 顺手的题材 |
|---|---|---|---|---|
| Midjourney v7 | 14 | 3张多指,2张尾巴错位 | 约35秒 | 哺乳动物腾空、毛发冻结 |
| 即梦3.0 Pro | 11 | 2张尾巴分叉,水花偏假 | 约12秒 | 水花、碎屑、织物飞起 |
| Flux.1 dev(本地) | 9 | 6张关节反折 | 约55秒 | 服从提示词,改词见效快 |
三款工具性格完全不同。Midjourney出片最“摄影”,光影安排得明明白白,但物理偶尔骗人:猫悬在半空,影子还贴在原地没跟上。即梦的水花是我最喜欢的,颗粒一颗颗数得清,动物就差口气。Flux崩得最多,可它听提示词最老实,写五根手指真给五根,修图党会喜欢。话说回来,别迷信排名,题材一换,顺序可能整个倒过来。
还有个三家通用的独家发现:崩图回炉时,局部重绘的框要小,只框多出来的那条腿,强度压到0.65左右,两三轮基本能救回来;整张重跑反而把对的部分也改崩。我那张六条腿的橘猫,就是这么救回来的。
回到开头那只橘猫。我最后留下的是第17版,尾巴弧线和那天下午几乎一样,毛色深了一档,朋友圈没一个人看出是画的。相机错过的半秒,提示词真能补,只是补回来的是“像那么回事”,不是“分毫不差”,先接受这一点再动手。今晚就拿你家那只试一张,从一条猫跳沙发的提示词开始。
常见问题
生成的动作照片能拿去参加摄影比赛吗?
大多数正规赛事要求原片和EXIF信息,AI生成图投稿算违规,查出来会进黑名单。想参赛就用真拍的照片;AI补的图发社交平台、做封面、配文章都没问题,边界别踩错。
为什么我写了高速摄影,水花还是糊的?
先检查两个短语是否成对:sharp focus on subject 和 motion blurred background。只写模糊不写主体锐利,模型会把整张图一起糊掉。还不行就把糊词挪到提示词后半段,越靠前权重越大,这是实打实有效的老经验。
手机上能跑这种动作出图吗?
能,即梦和Midjourney的App都行,质量和网页版几乎没差。缺点是参数余地小,局部重绘的框不好精确到一条腿,细修还是建议回电脑做。
拍糊的真照片,能让AI照着补清楚吗?
可以试,把原图垫进去重绘,强度压在0.5到0.6之间,保住构图换质感。但动作本身糊成一团就没救了,AI补的是质感,补不回没拍到的那零点几秒,这种还不如重新生成一张。