ai绘画clip起什么作用?搞懂文图匹配,提示词才不白写
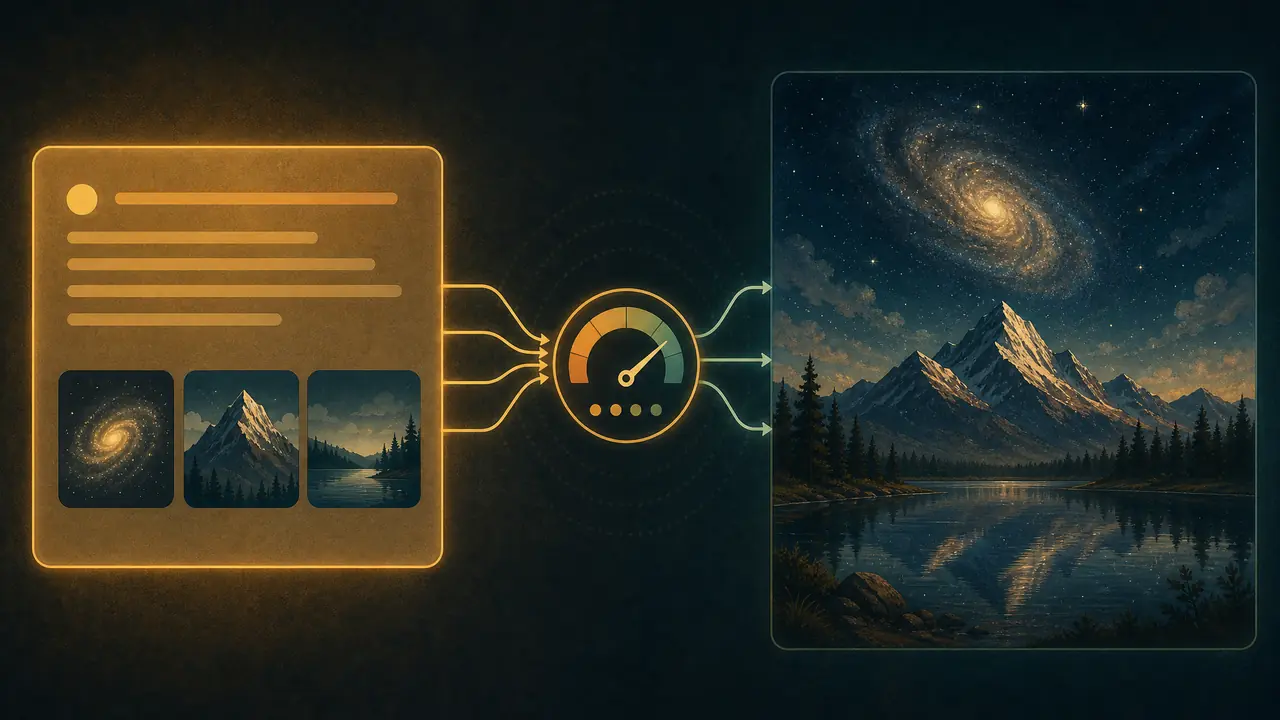
先给结论:CLIP是AI绘画模型里"听懂"提示词的那只耳朵,你把它熟悉的那类画面白描写给它,匹配就对得准。想少抽卡,先把形容词堆砌改成给画写说明文字。
在ai绘画clip这套机制里,文字和图片被压进同一个空间打相似度分,哪句提示词跟目标画面匹配度高,模型就照着哪句画——这就是提示词越具体越准的根本原因。结论先放这,下面用大白话拆开讲。
事情从一位刚入坑的朋友说起。他2026年9月装好Stable Diffusion,兴冲冲输入"超美星空,8k,大师之作",出来一堆平庸的糊图;换成人话白描"夏夜山谷上空的银河,紫蓝色星光洒在湖面,长曝光照片质感",十二张里能挑出九张。他以为碰上玄学。其实每一步背后都是CLIP在干活。
CLIP在出图流程里到底干什么活
CLIP像一个读过几亿条图注的图书管理员,把你的文字翻译成画图模型能懂的坐标,出图时文和图全靠它对号。CLIP全称Contrastive Language-Image Pretraining,OpenAI在2021年发布,训练素材是大约四亿对从网上收集的图文配对。
它的训练方式说白了就是做连线题:把一堆图和一堆描述混在一起,猜哪句配哪张图。猜对加分,猜错扣分。四亿道连线题做下来,它学会了把"一句话的意思"和"一张画的长相"放进同一个坐标系里衡量。就像相亲角的红娘看了几亿份登记表,一句"喜欢安静"能对上哪张脸,她心里门儿清。
放到AI绘画流程里,它的位置在很前面。你敲下提示词,先由CLIP的文本编码器把每个词变成一串数字,画图模型再拿这串数字当导航,从噪点里一点点捞出图来。Stable Diffusion 1.5用的文本编码器就是CLIP的ViT-L/14,一次最多吞77个token。我试了下写一大段,发现后半句完全没生效,排查半天才知道token超了被拦腰切掉。中文在这套分词器里还比较吃亏,几个字就能吃掉好几个token,所以提示词压在50个token以内更稳。
为什么提示词写得越像图越准
CLIP学过的配文是"画面里有什么"的平实描述,你把提示词写成这样的白描它才对得上号;形容词堆出来的句子,它找不到抓手。道理藏在训练数据里。
CLIP见过的四亿对图文,大多是网页配图那种说明文字:"一只橘猫坐在窗台上""雨后的街道倒映着霓虹"。它几乎没见过"神作、8k、光影大师"这类词跟图成对出现。你堆这种词,等于问一个只读过菜谱的人健身餐怎么配,他只能瞎蒙。
换个场景讲:CLIP比对像给客服报修,你喊"急急急在线等"没用,报清订单号和故障现象才解决得快。名词、位置、光线、材质,这些才是它认识的锚点。但它的边界也要心里有数——CLIP是整句对整图地打分,数数能力很差,写"三只猫"它未必真数出三只。数量当参考可以,当保证不行。
同图三版提示词,36张图的对照实测
同一模型同一参数,2026年9月我用三版提示词各出12张,画面白描版留下9张可用,形容词堆砌版只留下1张,差距全出在匹配环节。实验细节如下。
实验设置:SD 1.5本地跑,采样步数28,CFG 7.0,尺寸512×768,主体统一是"山谷银河夜景",每版12张共36张,2026年9月10日晚一口气跑完。可用标准是我自己定的:主体对、构图不崩、能直接拿去配文。
| 版本 | 提示词写法 | 12张可用 | 主要毛病 |
|---|---|---|---|
| A版 | 超美星空,8k,大师之作,光影震撼 | 1张 | 主体飘,银河位置随机 |
| B版 | 星空,夜晚,山脉 | 3张 | 没错但太笼统,像模板图 |
| C版 | 夏夜山谷上空的银河,紫蓝色星光洒在湖面,长曝光照片质感 | 9张 | 偶有山体糊,局部重绘可救 |
跑完还有个意外发现:A版偶尔蹦出构图很炸的图,十几次才一次,当彩票可以,当生产力不行。C版稳,稳里带点平庸,靠后续局部重绘补细节。要效率的话,我宁可要C版这种"九张里挑一张惊艳",也不要A版"十二张里赌一张"。
顺着CLIP的脾气写词,三个顺手做法
把提示词当成给闭眼的朋友讲画面来写:先主体和动作,再环境和光线,最后才轮到风格词,总量控制在三行以内。具体拆开是这样。
第一件事,白描优先。落笔前先问自己:这句话像不像网页配图下面那行说明?把主体、动作、环境、光线一层层填进去,CLIP认识的锚点越多,画面被拉偏的可能越小。
第二件事,排位有讲究。提示词按顺序编码,排在前面的词天然占更多注意力权重,最重要的主体往最左放。我习惯只给关键名词加一点权重,比如给"银河"微调一下,山和湖面保持原样,画面重心立刻就正了。
第三件事,画质词降级。8k、高清这些放句尾当调味,两三个封顶。说实话,它们对构图和主体的贡献远没有名词实在,堆多了反而把匹配拉偏。
回头看开头那位朋友,他不是运气差,是说话方式跟CLIP对不上。把它当成读过上亿条图注的图书管理员,你的描述越像一条图注,它越找得到那本书。下次出图前先默念一遍:这句提示词,像不像给一幅画写的说明文字?像,就对了。
常见问题
CLIP分数高的图一定更好看吗?
不一定。它衡量的是文字和图对不对得上,审美是另一码事。一张匹配分很高但构图平平的图很常见,所以这个分数当体检指标用,别当艺术评分。
用中文写提示词CLIP能听懂吗?
原版CLIP主要吃英文,中文模型一般是另训的多语版本。我自己实测下来英文出图稳定度更高,中文提示词建议先翻成英文再丢进去,翻译时保住具体名词,别翻成抽象词。
负面提示词也走CLIP这一关吗?
走。负面词同样过文本编码器,模型会拉着画面往它的反方向去。负面提示词也照白描的写法来,写清你不想要的具体画面,比一句笼统的"模糊、低质量"管用得多。
CLIP都出来五年了,学这些还有用吗?
有用。后面新模型换了架构,底层的文图对齐思路没变,SDXL甚至同时用两个文本编码器配合干活。"提示词写成画面白描"这个习惯,短期内都吃香。