ai绘画比比才知谁行:固定种子+同词对照+盲评打分的公平实测法
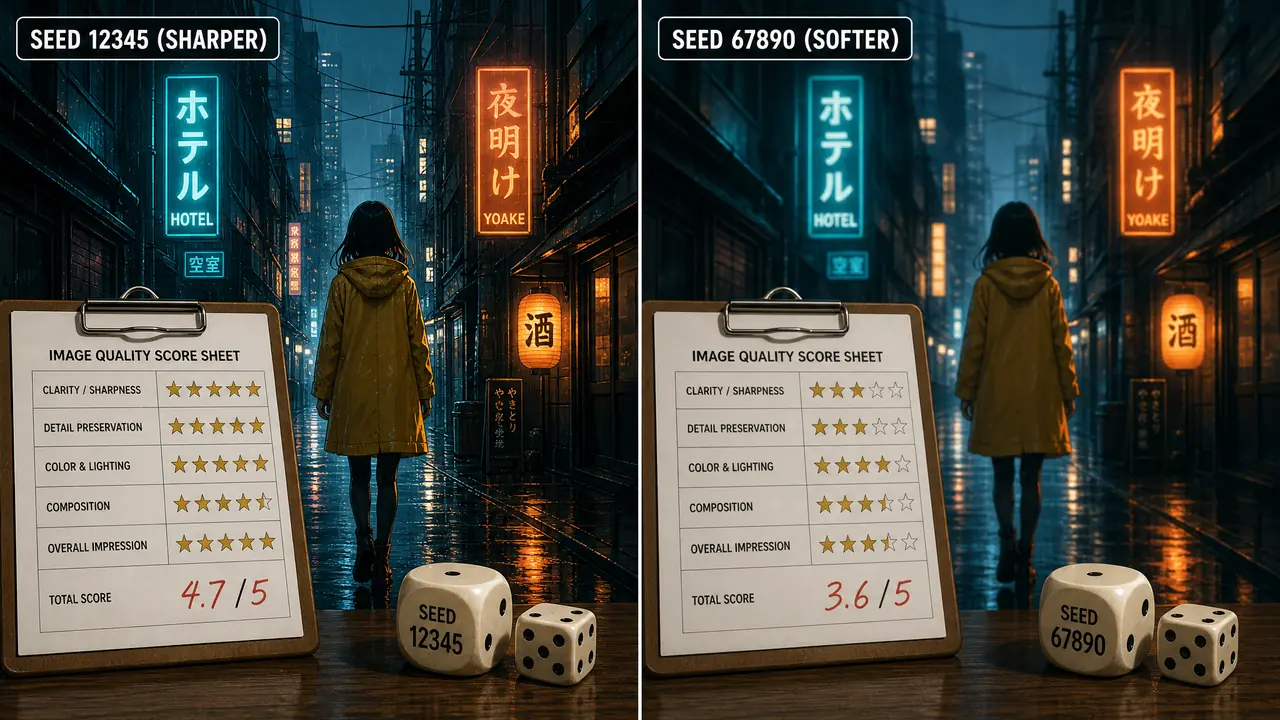
先定规则:ai绘画比比想比得公平,必须锁死种子和采样参数、用同一句提示词各跑三轮、最后靠盲评打分说话,缺一步结论都会跑偏。依据是我自己踩过坑又重跑过的一组对照数据。你现在要做的,是把下面这套流程抄走,先比一次试试。
ai绘画比比这件事,我一开始也是两头抽卡、哪张顺眼夸哪张,结果同一个工具今天神明天菜昨天像坏了。后来才想明白:变量没锁住,比出来的全是运气。结论先给——固定种子、同词对照、盲评打分,三步缺一个,比比就是玄学。下面这套方法我跑过完整一轮,数据也一并放上。
为什么这么较真?你花十分钟出的图,和工具官方首页那张精修样品,根本不是一个赛道。不立规矩,比比十次有九次在自欺。
先锁什么,才够格开比?
开比之前必须锁四样:种子、模型版本、出图尺寸、采样步数,提示词逐字复制不许改标点。这四样有一个在飘,两张图的差异就说不清是工具的功劳还是抽卡的运气。我在笔记里专门记过一次翻车:拿同一句提示词比两个工具,A工具我随手点了张新图,种子变成随机,跑出来的效果差异全记在了B工具头上——复盘时发现A那张根本是另一颗种子,整轮作废,重跑。
具体怎么锁,我的习惯是建一张"锁定卡":
- 种子:固定写死,比如 seed=8862347,两边都用同一颗,别让工具自己随机。
- 尺寸:统一 1024×1024 或 768×1280,比例不同,构图评分根本没得比。
- 采样步数:20步起步,两边一致。有的工具默认12步,有的默认30步,直接比等于让短跑选手穿拖鞋。
- 模型与版本号:记下模型名和日期。模型悄悄更新这事我碰过两次,隔一周再跑,同一颗种子出图完全不一样了。
还有个容易漏的:负面提示词也要逐字一致。有回我只给一边加了"低画质"负面词,那边纯净度肉眼可见地好,我差点就把结论写反。
另外提醒一句,提示词语法在两边不一样时(比如权重写法一个用括号一个用数字),尽量选两边都能原样理解的中性写法,实在不行就在记录里注明换算方式。权重类变量的控制思路,可以参考ai绘画劳拉怎么用才不翻车?权重与触发词实测笔记里那套逐步加减的做法,移植过来就能用。
同词对照怎么排,三轮起步
同词对照的正确排法:一句提示词、一颗固定种子,在两个工具里各跑三轮,三轮全用同一套参数,逐张记录耗时和出图结果。跑一轮不算数——单轮是抽样,三轮才看得出稳定度。一个工具偶发一张神图谁都碰得到,稳定产出才说明实力。
上个月我自己排了一组对照,提示词是"雨夜霓虹小巷,穿黄色雨衣的女孩,胶片颗粒感",种子 8862347,1024×1024,20步。两个工具各跑三轮,然后让三个朋友盲评(后面细说怎么盲),取平均分。数据长这样:
| 轮次 | 工具A均分(5分制) | 工具B均分(5分制) | A耗时 | B耗时 |
|---|---|---|---|---|
| 第1轮 | 4.2 | 3.7 | 约14秒 | 约22秒 |
| 第2轮 | 3.8 | 3.6 | 约13秒 | 约20秒 |
| 第3轮 | 3.9 | 4.1 | 约15秒 | 约21秒 |
| 三轮总均分 | 3.97 | 3.80 | — | — |
看出门道没?A前两轮领先,第三轮反被B追上,总分只差0.17。要是只跑第一轮,我会武断地说"A碾压";跑到第三轮才发现,B在雨天氛围这类题材上波动小、下限稳,A是上限高但看脸。这个差别,一轮根本照不出来。
耗时也值得记。A快是真快,13到15秒一张;B平均21秒上下,差了快一半。速度分要不要折进总分,我个人的偏法是单列一栏,不混进画质分——画质是画质,快慢是快慢,混在一起说不清。
同词对照还有个隐藏好处:提示词的兼容性会被照出来。我试过同一句词在B那边人物总往镜头外偏,排查下来是它对"小巷"这个词的空间理解不同。这种发现比单纯比美丑值钱多了。
盲评打分怎么防自欺?
盲评的做法:把两边出图统一改名成IMG_001这种无特征文件名、打乱顺序,再让不知情的评委按固定维度打1到5分,收卷后才对号入座。你自己知道哪张是哪个工具出的,手就会不自觉偏。这步偷懒,前面锁种子全白锁。
别笑,这真不是矫情。我第一次做对比时,自己给"心头好"那边平均多打了0.6分,让朋友盲评后差距直接缩到0.2。人对自己的选择是有辩护本能的,工具A是我充了会员的,我当然希望它赢。
打分维度建议定死三条,别让人自由发挥:
- 结构完整度:人物肢体、手部、场景透视有没有崩。
- 提示词还原:说好的黄雨衣、雨夜、霓虹,各到位几分。
- 氛围质感:胶片颗粒、光影层次,凑近看糊不糊。
每条1到5分,总分15,除以3换算成5分制。评委找两三个没参与过你日常吐槽的人最理想——被你天天念叨"这工具不行"的朋友,打分也会被带节奏。分差在0.3以内,我的判定就是平局,别硬分胜负。
问一句:找不到人盲评怎么办?自己评也行,但加一道冷却——出完图先去干别的,两小时后忘了哪张是哪张再回来打分(文件名改掉是前提)。冷却法我用了半年,比当场评靠谱得多。
回到开篇那句话:ai绘画比比,比的从来不是谁抽到好卡,是谁把变量锁得死。锁定卡建好、三轮跑完、盲评收卷,十分钟到半小时就能拿到一份自己信得过的结论。方法就这套,抄走改改参数,今晚就能比出你的答案。
常见问题
两个工具的提示词语法不一样,还算是同词对照吗?
算,但要留痕。尽量选两边都能直译的中性提示词,语法差异处(括号权重、逗号断句)在记录表里单独列一列注明。换算方式固定下来,比别的题材时沿用同一套写法,横向结果依然可比。
种子锁死了,是不是就没法体现工具的真实水平?
恰恰相反。固定种子比的是"同起点下的处理能力",比随机抽卡更能暴露底层差距。想测上限,可以另开一轮"每组各抽5张取最高分"的宽松赛,但那是第二轮实验,别和严格赛混在一张表里。
比几轮才有说服力?三轮会不会太少?
日常选型三轮够用,能滤掉大部分运气。要是结论要用于付费决策,我会加到五轮并换两个不同题材的提示词各跑一遍——我那组0.17分的差距就是提醒,分数咬得越紧,越要多跑几轮再下结论。
盲评分数每次都不一样,这方法还有意义吗?
单个人的分数会漂,多个评委取平均就是为了摊平这种漂移。分差小于0.3判平局、大于0.8判明显差距,中间地带标注"弱优势"。规则先写在纸上,比完只看数字,不现场解释。
新手该先比哪两个工具?
先比你手头正在用的两个,哪怕一个是免费网页版。对比方法跟工具档次无关,练熟流程比选对象重要。等你会锁变量了,再去比开源模型和在线平台这种跨量级的局,那时看到的差异才有分析价值。