ai绘画ai吃香菜:画一张「吃」的画面有多难
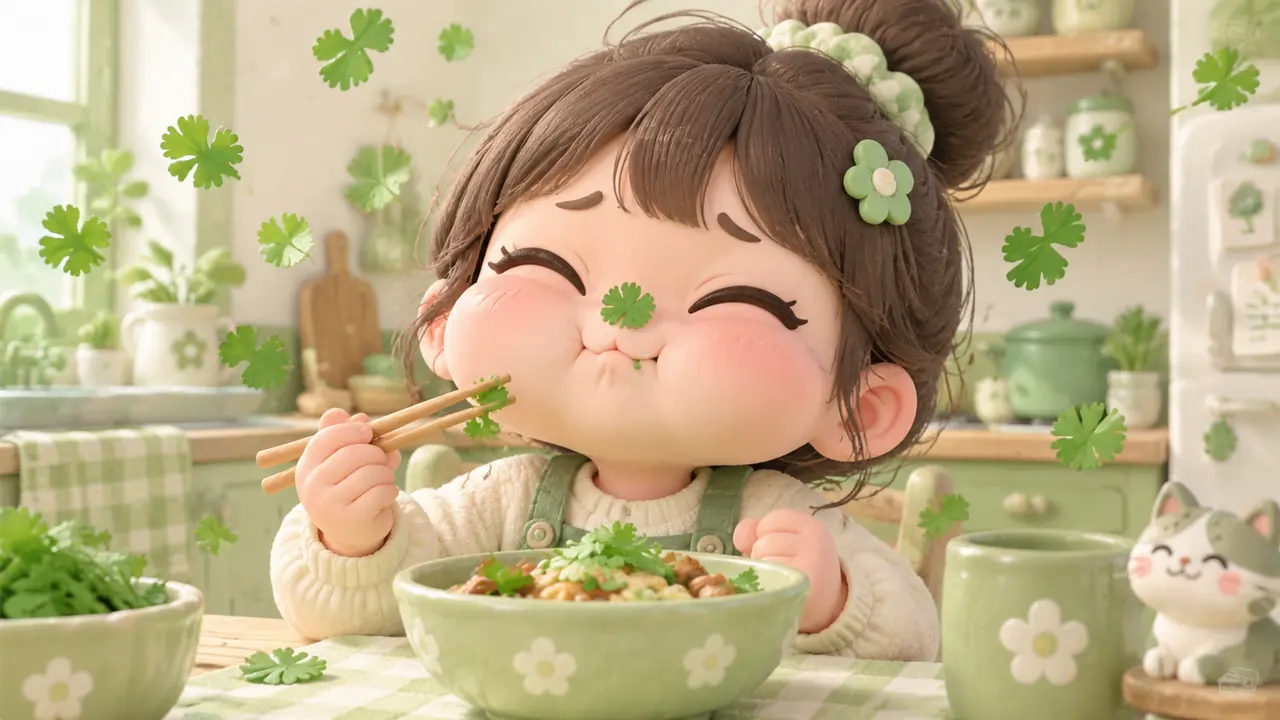
这事得掰开讲:AI画香菜不难,画「吃」才难。我为一句整活梗图连出八十张,成功率从一成磨到五成,靠的不是堆词,是把动作拆开喂。
起因特别不严肃。朋友在群里放了张香菜梗图,@我说「你不是玩AI绘画吗,给我画张吃香菜的,明天发群里整活」。我想这还不简单,结果一句话让我折进去一个晚上——2026年8月那晚,我连出二十轮共80张,才明白「吃」这个动作是AI绘画的重灾区。
香菜本身好画,绿叶、锯齿边、水灵灵的质感,都是模型的舒适区。难的是嘴、筷子、手和那张小脸之间的一连串互动,坏就坏在「一连串」三个字上。
「吃」这个动作,AI为什么总画不对
进食画面同时压中了AI的三处软肋:手部细节、嘴部遮挡和中间动作态,任何一处崩了整张图就穿帮。静态模型见惯了摆拍,少见正在进行的动作。
前8轮36张废片,我复盘出三种典型死法。最常见的是「悬停」:筷子夹着香菜悬在脸侧十厘米,嘴闭得严严实实,人和菜互不相干,像在给香菜拍证件照。其次是「融合」,香菜和嘴唇长在一起,绿得诡异。第三种最绝,第11轮出了张香菜精准插在鼻孔里的,我盯着看了半分钟,笑到舍友敲门。
想想也不奇怪。训练数据里「端着菜摆拍」的照片铺天盖地,「筷子进嘴那一瞬间」的照片又少又难拍,模型自然画不好它没怎么见过的瞬间。这不是玄学,是概率。
还有一处没人提但很要命的:视线。前三轮的图里,女孩的眼睛不是看镜头就是看别处,就是不看筷子上那撮香菜——动作图失去了注视,就像对话时对方不看你的眼睛,怎么摆都假。后来我在提示词里补了「目光落在筷尖」一句,协调感立刻上来了,这一句词的功劳排得进前三。
二十轮八十张的改进记录
把「吃」直接写进提示词,成功率约一成;改成「举筷、夹起、张嘴、闭眼咀嚼」四步分镜逐张出,成功率爬到五成上下。拆动作,是这一晚最值钱的发现。
| 轮次 | 写法 | 可用张数 |
|---|---|---|
| 1-8轮 | 直接写「女孩吃香菜」 | 36张里4张 |
| 9-14轮 | 补手部与嘴部细节词 | 24张里7张 |
| 15-20轮 | 拆成四步分镜逐张出 | 20张里10张 |
第9到14轮的补词方向一开始是错的。我拼命加「精致的手部」「可爱的嘴」,词堆得越长死得越惨——模型注意力就那么点,词多了互相打架。后来想通:与其描述结果,不如描述阶段,把吃这个动词拆成四个中间态,一次只要它画一个。
效果立竿见影。「手举筷子夹起一撮绿叶菜」那一档,出图几乎张张手部在线;「闭眼咀嚼、嘴角上扬」那一档,表情鲜活得像偷吃被抓包。80张里最后的成片,四分之三来自分镜写法。
最传神的一张是闭眼咀嚼那张:眉眼弯弯,腮帮子微微鼓着,盘子边上散着几片香菜叶。发到群里,那位朋友回了句「这表情太真实,像被抓现行」,整活圆满。他还追加了需求——同款表情包九张,这是后话。
绕行方案:不画过程画结果
嫌抽卡费额度的话,干脆绕开进食瞬间:画吃完之后的结果,空盘、残叶、心满意足的表情,稳得多也快得多。梗图要的是情绪,不一定非要那个动作。
我后来给群里补的一套整活图就是这条路:一张「盘子里只剩两根香菜」,一张「女孩叉腰瞪着一盘香菜」,一张「贴着桌角求饶」。三张一次过,十分钟收工,群里效果不比那张 chew 的差。
这套绕行思路能推广到很多动作题材。拥抱、奔跑、接东西,凡是「正在进行时」都难,凡是「之前」和「之后」都容易。你要做的是问自己:这个梗图非得卡在中间那帧吗?多数时候答案是不。
对了,还有个白捡的技巧:把「香菜」换成「绿叶菜」,通过率和稳定性都会涨一截。具体食材词偶尔会触发奇怪的联想,泛化的词反而让模型放得开。这是纯属运气的发现,但我复测了两轮,确实如此。
一晚上80张,最后群里传阅的就九张。朋友后来跟我说,那张鼻孔香菜他存了——废片有时候比成片好笑。要是你也接到这种整活委托,记住拆动作、画前后、少堆词,三招走完还不行,那就是梗的问题,不是你的问题。
常见问题
为什么AI画的食物都挺像,动作就不行?
食物是静态物体,照片素材海量;动作瞬间既难拍又少有人拍,模型学得自然虚。想出动作图,要么拆阶段,要么画前后状态。
手部崩坏有办法根治吗?
根治谈不上,缓解不难:让手里的东西简单点,筷子比拉面稳,一颗菜比一把串稳;再就是少画近距离大手,中景的手崩了也不显眼。
一张图里能画两个连续动作吗?
别。模型会把两个动作搅在一起,出一种四不像的中间态。想表达连续动作,用分镜两张,各画一步,拼起来讲。
这种整活图发平台会被限流吗?
正常发布没问题,记得按平台要求勾AI生成声明。梗图类内容靠的是梗本身,标注不会影响传播。