ai绘画内涵怎么调?给画面加故事感与耐看层次的一手实测
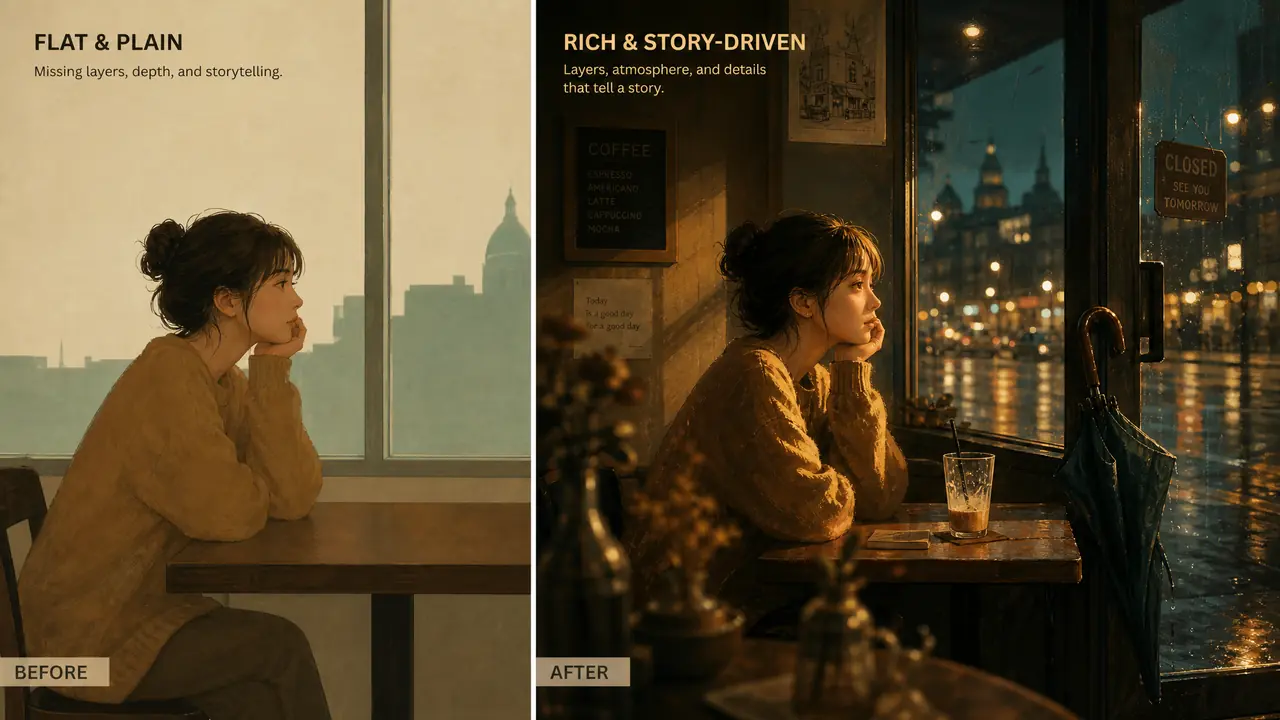
答案不难猜:ai绘画内涵就是画面里能被读出来的故事和层次,它决定一张图是扫一眼就划走,还是值得多看两秒。依据来自一组20张图的对比实测——只写主体的提示词,10张里只有3张耐看;补上叙事小物和前中后景分工后,耐看率拉到8张。想改,先从给画面加一件正在发生的小事开始。
很多人把ai绘画内涵理解成细节堆得多,这个方向一开始就偏了。内涵是画面能讲出一件事:谁、在做什么、刚发生过什么、接下来会怎样。一张图有了这层信息,观众才会停下来。
我做过一组对比。同一个清晨咖啡店的场景,A组提示词只写「一个女孩坐在窗边喝咖啡」,B组在此基础上加了「桌上半杯凉掉的拿铁、门口立着一把还在滴水的伞」,每组跑10张。A组出图干净漂亮,但10张里只有3张能让我多看一会儿;B组8张都有可读的东西。说实话,差距不在画质,在信息量。
ai绘画内涵到底是什么:不是细节多,是有话可读
ai绘画内涵指画面承载的可读信息:人物关系、时间痕迹、情绪暗示,这三样凑齐,图就有了内在层次。它不是加细节,是加「能被解读的细节」。
细节分两种。装饰性的:花纹、光斑、飘着的花瓣,好看,但第一眼看完就没了。叙事性的:湿伞、凉咖啡、磨破的鞋尖,它们暗示了雨、等待、走了很远的路。观众看到后者会自动脑补前因后果,停留时间自然变长。
模型默认不会给你叙事细节。不写,它就按训练数据里最常见的路子走——把画面填漂亮。个人觉得这挺合理,毕竟「好看」在数据里出现的频率远高于「有故事」。所以内涵这件事,得你在提示词里亲手动笔,它不会从天上掉下来。
判断标准很简单。看图五秒,问自己能不能说出「这张图里正在发生什么」。说得出,就有内涵;只能说「挺好看的」,那就是一张空图。这个标准我自己用了小半年,比任何玄学理论都好使。
故事感从哪来:给画面留一件正在发生的小事
给画面留一件正在发生的小事,故事感就有了支点。写提示词时用一个进行时动词加一件状态异常的物品,比堆十个形容词都管用。
具体三个抓手。第一,动词用进行时:「正要推门」「刚放下伞」「伸手去够书架顶层」,画面里就有了动作的中间态,观众会好奇前一秒和后一秒。第二,放一件状态异常的物品:半杯凉茶暗示坐了很久,翻开的信暗示刚被读过,缺了一角的杯子暗示旧物。第三,让人物的视线离开镜头看向画外某处,观众会顺着视线去脑补画框外的世界。
视线这条我翻过车。有一张图我想要「她望着窗外」,结果模型给了个直勾勾看镜头的眼神,整张图瞬间变证件照,特别出戏。改法是在提示词里加「侧脸朝向画面右侧,目光落在远处」这类明确的方位描述,重跑3张里2张救了回来。剩下的1张还是盯着镜头,直接扔。
还有一点,留白比塞满更高级。叙事元素一到两件就够,画面里的「空」给观众留了想象的位置。填得太满,故事反而被挤没了。
耐看的层次:前中后景和光各干各的活
耐看靠前中后景分工:前景给故事线索,中景给主体动作,背景给时间和地点。光再分层,侧光比平光更有戏,画面的信息量能翻倍。
把画面想成三个工位。前景放虚化的小物件,或者用门框、雨伞边缘做半遮挡,纵深立刻出来。中景是主体和动作的主舞台。背景不抢戏,但要交代信息:远处的霓虹灯说明是城里,晾着的衣服说明有人生活。三层都有内容,图才经得起看第二眼。
光是另一个维度的层次。主光打方向,环境光补氛围,侧光在脸上留一半阴影,人物马上有情绪;平光则像证件照,信息全给,味道全无。我统计过B组那10张:带明确光方向的7张被我留下,剩下3张全是平光,一张都没入选。这个结果挺一边倒的。
两组实测数据放一张表里,对比更直观:
| 维度 | A组(只写主体) | B组(主体+叙事小物+层次) |
|---|---|---|
| 跑图数量 | 10张 | 10张 |
| 愿意多看两秒的图 | 3张 | 8张 |
| 主要短板 | 画面漂亮但没有内容 | 偶尔小物喧宾夺主 |
| 修改成本 | 几乎要重写提示词 | 补两三个词就能调 |
B组也不是稳赢。有一张图里我同时塞了湿伞、凉咖啡和翻开的信,模型把信画到了墙上,位置莫名其妙。删掉「信」重跑才正常。小物超过两件,互相就开始抢戏,这是我交的学费。
顺带一提,层次词和画质词不冲突,但顺序有讲究。我的习惯是层次词放前半段,画质词收尾。有一次反过来排,模型把「特写镜头」理解成了构图指令,整张图只剩一张大脸,前中后景全没了。顺序本身也是信息。
回到开头那句话:内涵不是细节多,是有话可读。下次出图别急着加画质词,先问自己这张图里正在发生什么。一件带时间痕迹的小物,一层有方向的光,一个不看向镜头的眼神。三样凑齐,图就开始留人了。
常见问题
叙事细节加多了画面会不会乱?
会。我试过一张图里同时放三件叙事物,模型直接把其中一件画到了墙上。一个画面一到两件就够了,多了互相抢戏,删到只剩最关键的那件反而稳。
写实图才谈内涵,二次元画风适用吗?
照样适用。二次元的内涵靠表情、视线方向和背景符号来扛,比如窗台上打盹的猫加一本没写完的作业,故事感一点不输写实图。方法通用,只是载体换了。
加这些描述词会拖慢出图速度吗?
基本不会。叙事词不增加多少计算量,出一张图的时间几乎没变化。真正费时间的是反复抽卡等那张眼神对的,我的经验是步数20起步,眼神不对先改提示词,别急着调步数。
手机端或者在线工具也能用这套思路吗?
能,方法层面和设备无关。前中后景分工、叙事小物、光的方向,这些写在提示词里哪里都认。差别只在本地能调的参数更多,但思路一模一样。