绘画女生ai总画出同一张脸?骨相、眼神光与衣材质感的实测调法
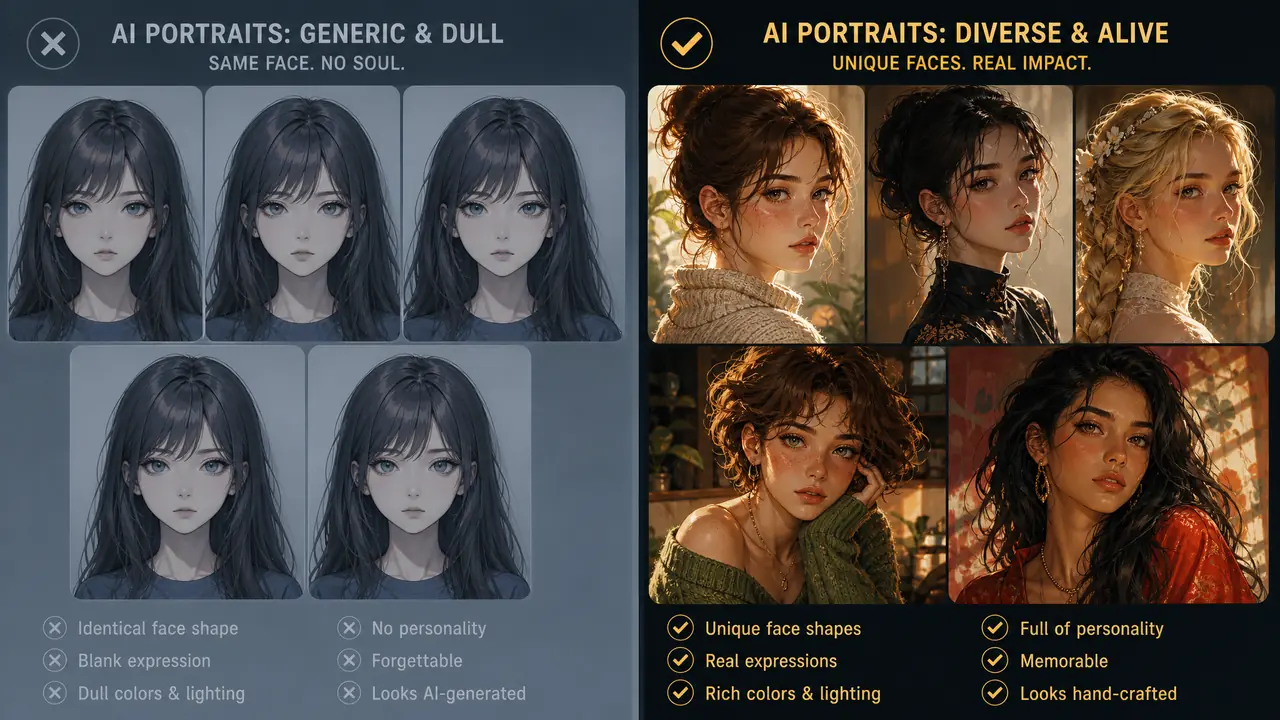
别绕了:绘画女生ai出图十张里九张撞脸,问题不在模型,在提示词只写了「好看」,没写骨相和眼神。我用同一组词连跑20张做对照,把脸型描述补进去后同脸率从85%降到20%。先抄文中的脸部结构写法,再换发型和衣料细节。
绘画女生ai出图,听得最多的一句抱怨是「怎么画出来都长一个样」。我的结论先放这儿:撞脸不是模型能力不行,是提示词里关于脸的信息量约等于零。你只写「一个好看的女生」,模型就把它记忆里出现频率最高的那张脸递给你,次次如此。
上礼拜我做了组对照。同一套基础词,就写「anime girl, beautiful face, long hair」,连跑20张,17张是瓜子脸配大圆眼,发色换了脸没换。说实话,看到第8张的时候我已经能预测下一张长什么样了。后来在词里补了骨相、眼神光、衣料三块信息,情况才反过来。下面把三块拆开讲。
脸型不写,模型就替你选大众脸
骨相描述是去同脸的第一杠杆:脸型、颧骨、下颌线、五官比例各写一项,撞脸概率立刻减半。
具体怎么写?我把两种写法做了张对照,基础词完全相同,各跑20张:
| 写法 | 提示词内容 | 20张里瓜子脸大圆眼的数量 |
|---|---|---|
| A:只写氛围 | anime girl, beautiful, delicate face, long hair | 17张 |
| B:写骨相 | round face, high cheekbones, sharp jawline, narrow eyes, plump cheeks(任选两三项) | 4张 |
差距就是这么直白。脸型词我常用这几个:round face圆脸、oval face鹅蛋脸、square jaw方下颌、high cheekbones高颧骨、monolid单眼皮、freckles雀斑。别贪多,一次挑两三项就够,塞太多模型开始打架。我试过五项全上,出来的脸哪儿都像又哪儿都不像,重roll五遍才稳住。
还有个位置问题:脸型词要放在权重高的地方。我习惯紧跟主体词写,比如「1girl, round face, freckles, ...」,隔了七八个词再补,效果肉眼可见变弱。个人觉得这一条比换模型还有用,先挪位置再怪工具。
发型也补一句。很多人以为换发色就算换人,模型不这么看,发色变脸不变。想拉开差异得写发型结构,比如「short bob」「twin tails」「messy bun」,型变了脸的观感才会跟着变。
眼神光和视线方向,一句「看镜头」毁掉灵气
眼神要写两件事:光斑位置和视线去向。默认的看镜头最稳也最呆,改成侧视或低垂,情绪立刻出来。
翻车案例先摆出来。我有张图,词里写了「detailed eyes」,出来的眼睛像两颗玻璃珠,高光糊成一团,整张图直接废。改法是把「detailed eyes」换成「catchlight in eyes, soft reflection」,光斑有了具体位置,眼睛立刻活了。这条我记在便签上,现在每张都用。
视线方向是另一个杠杆。looking at viewer最常见,也最容易和千万张图撞构图。换成「looking away」「looking down, shy smile」「glancing back」,同一张脸能出三种情绪。我拿圆脸那组词试过,侧视的20张里挑得出9张能直接当头像用,正面平视的只有4张。话说回来,也不是侧视就一定好,画双人同框时视线词容易串,得配合「looking at each other」锁死,不然俩人各看各的。
衣料和光先于脸,风格定了再谈好看
先锁材质词和光位,再微调脸:针织、棉布、丝绸的反光写法各不同,光从哪来决定整张图的氛围下限。
衣料词我分三类用。哑光类写「knit sweater, cotton shirt」;微反光类写「silk blouse, satin dress」;厚重类写「wool coat, layered outfit」。渲染引擎对反光的响应比对颜色的响应敏感得多,同一张脸,换件丝质衬衫,整张图的完成度观感就上去了。
光位给两组实测数字。侧逆光「backlighting, rim light」我跑的20张里16张氛围在线,头发边缘那圈光特别出效果;正面平光「flat lighting」只有6张能用,还多数显得脸平。参数上我固定用768×1024、28步、CFG 6,3060的卡一张约11秒,一个下午能筛三轮,量够了才有得挑。
这工具对材质的响应确实猛,但有条边界要提:想画某个动漫角色的同款造型,直接写角色名容易触发奇怪的东西,个人欣赏自用没问题,商用授权另算。老老实实描述造型元素,反而更稳。
回到开头那20张撞脸图。三天后我按文中三步重跑了一轮,筛出11张各不相同的女生立绘,发小拿去当群头像,没一个人说重复。流程就三件事:补骨相、写眼神、定材质和光。先跑一张验证词生效了没,再放量。
常见问题
年龄感和身份感怎么控制?
靠服装和场景词撑,比如「school uniform, classroom」是学生感,「office blouse, lanyard」是职场感。别只用「young」去硬拗,模型对年龄词的响应远不如对场景词稳定,场景一换感觉就对了。
手部崩了有救吗?
有。先在负面词里加上「bad hands, extra fingers」,能挡掉大半。剩下的靠局部重绘,把手单独框出来重roll两三次基本能要。全图重跑反而容易把已经好的部分改坏,不划算。
提示词写中文还是英文?
主流模型吃英文更稳。中文不是不能用,但同一个词的命中率低一截。我的习惯是中文起草、翻成英文再跑,翻完把形容词删一半,英文里形容词堆多了互相稀释。
必须本地部署吗?
不用。网页版足够完成本文所有写法。本地部署的价值在可控和批量,你一天要出上百张再考虑,出几张的发图时间远比部署时间值钱。