AI与我绘画协作实测:把自己画进画面的三种做法和翻车记录
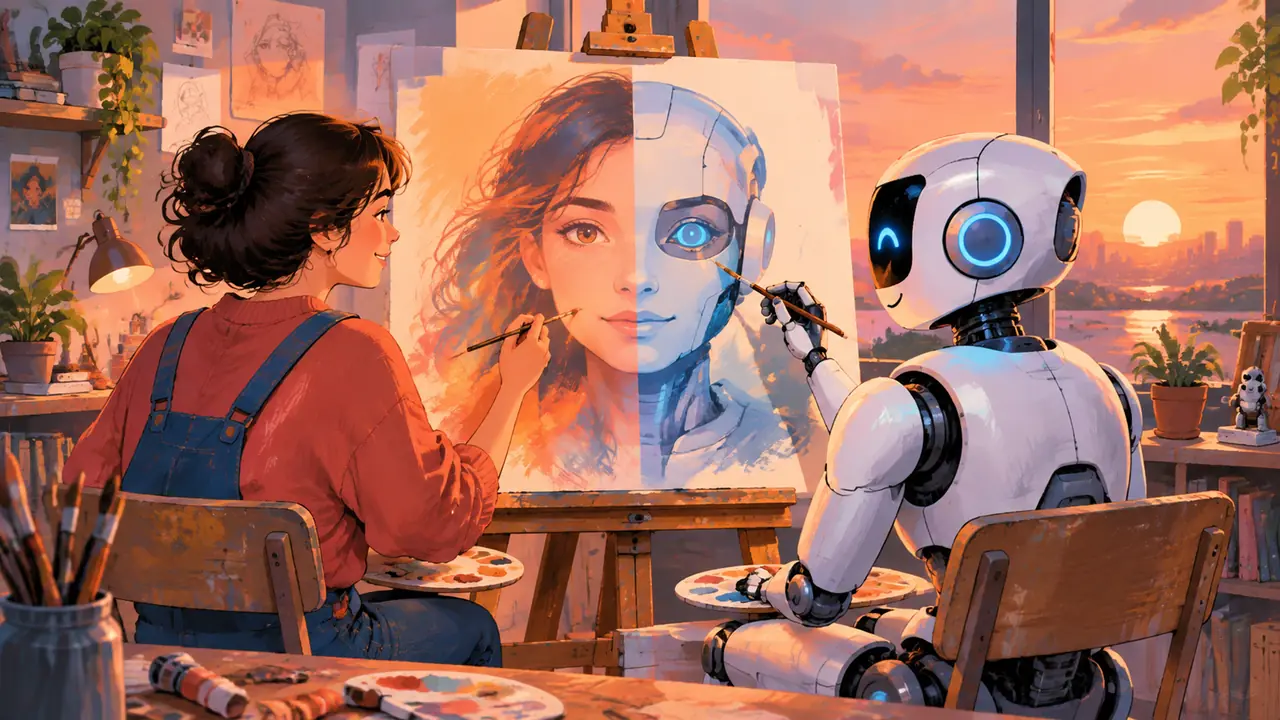
我的判断是:人机协作的关键不是让AI替你画,是把"你"变成画面的一部分。文生图像抽卡,垫图保五官,控骨架保姿势,想要"画的是我",垫图加控骨架双管齐下才稳。
有朋友问我,AI与我绘画到底算谁画的。我没直接答,甩给他一张我最近的自画像:画面里我在桌前画图,屏幕上是生成到一半的图,桌角放着我的数位笔。他看了半天说,这算你俩合影吧。我笑了,还真是。这两个月我一直在琢磨怎么把自己画进AI的画面里,试出三条路,一条比一条像"我"。
为什么非把自己画进去?说实在的,我一开始只是不服气。AI出的图再漂亮,里面没有一个认识的人,看久了像逛一个全是模特的商场。把自己放进去之后,图突然有了"归档"的意义——那天的心情、桌上的杯子、屏幕里的废图,都成了记号。
把自己画进去的三条路:文生图、垫图、控骨架
文生图像抽卡,垫图保得住五官,ControlNet保得住姿势,想要"是我"就垫图加控骨架一起上。
第一条路最省事也最碰运气:光靠文字描述"一个戴眼镜的中年男生在画画",出来的人像谁都像,就是不像我,一百张里能撞出一两张轮廓接近的,纯抽卡。第二条路垫图:拿我一张正面照当参考,五官立刻靠了谱,但姿势全听AI安排,让它低头画画就经常手部崩坏。第三条ControlNet控骨架:我摆好姿势拍一张骨架图,人物动作分毫不差,脸又回到随机分发。
所以我最后固定的流程是垫图加控骨架一起上:骨架定动作,垫图定脸,文字只负责场景和光线。这么说吧,文生图像买彩票,垫图是定妆照,控骨架是请了位替身演员,三个一起上才是一部完整的"我"。
脸不像这件事,我认了三分之一
垫图权重0.6到0.7最平衡,再高表情会僵,脸像了但眼神死了,得靠重绘微调找补。
垫图权重我试了一个区间。0.4以下,像度够呛,出来的还是那个"陌生的我";0.8以上,五官是像了,表情僵得像证件照,眼神一点内容没有。0.6到0.7是我实测下来最舒服的档位,像度打八折,但人还活着。剩下的两成像度我认了,AI画的我总比真人精神一点,眼袋没了,脸也瘦了,就当它给我美了颜,不跟它计较。
眼神这块我多提一句,它是"像"和"活"的分界线。盯着画面外看的版本,最接近真人抓拍;写"looking at viewer"就总有股直播感。自画像这种东西,我宁愿它像抓拍,不想让它像海报。
翻车最典型的是手。低头作画的姿势,握笔那只手十次里崩六次,多一根少一根指头是常事。局部重绘,幅度0.35以内,一次修不好就修两次,别贪一次到位。还有一版把我画成在签文件,笔变成了钢笔,场景词里老老实实写"holding a stylus, drawing on a tablet"才纠正过来。
人机同框的构图:让AI入镜反而最真实
画中画构图最诚实:屏幕里是生成中的图,桌前是正在等图的你,两个"作者"同框。
我试过三种同框方式。第一种把自己画成拿着画笔站在画架前,像文艺复兴工作室的学徒,AI隐身在画布后头——好看,但撒谎了,我明明在敲键盘。第二种直接画人和电脑,普通。第三种是画中画:镜头从我侧后方拍,屏幕上是生成到一半的图,进度条还剩一半,我端着杯子在等。我最偏心这张,因为它最诚实:这里没有人机对抗,就是两个人搭伙干活,一个出图,一个挑图。
这张图的参数给你们抄:1024×1024,步数32,CFG 6.5,垫图0.65,控骨架用openpose。屏幕内容我特意挑了一张之前生成失败的图放进去——失败的图当道具,比成功的更像真的,这个小心思你记下,比什么高级构图都好使。
光线也照着实拍来的。夜里画图的人,主光源是屏幕,冷光打在脸上,旁边台灯给一圈暖的补光,冷暖一撞,人物就从背景里站出来了。我头一版没管光,整张图平得像办公室宣传照,加了一句"screen glow on face, warm desk lamp rim light"才有了深夜赶图的味儿。
后来那位朋友又问了一遍开头的问题:这算谁画的。我现在会这么答:姿势是我的,脸是我的,等图的耐心也是我的;它出图比谁都快,挑图的活儿它干不了。一张人机同框的自画像挂在那,答案自己会说话。
常见问题
垫自己的照片当参考,有隐私顾虑怎么办?
本地部署的模型不出网,照片不离开电脑,顾虑会小很多。用在线服务的话,挑清楚条款里对上传素材的留存说明,或者干脆只垫侧脸、剪影这类弱特征图。
握笔的手总是画崩,有稳定点的办法吗?
把手的姿势简化:让手只握笔杆、笔尖不接触画面,复杂交互越少越不容易崩。配合局部重绘小幅度多修几次,比一次生成整张靠谱。
自画像想要固定的画风,怎么保持统一?
固定底模、固定垫图、固定一组风格词,参数一个都别动,只换场景词。风格稳定性靠的是"尽量少变",场景随便换,其余全锁死。