ai人工智能绘画多人为什么容易翻车?把人数和关系写明白再跑
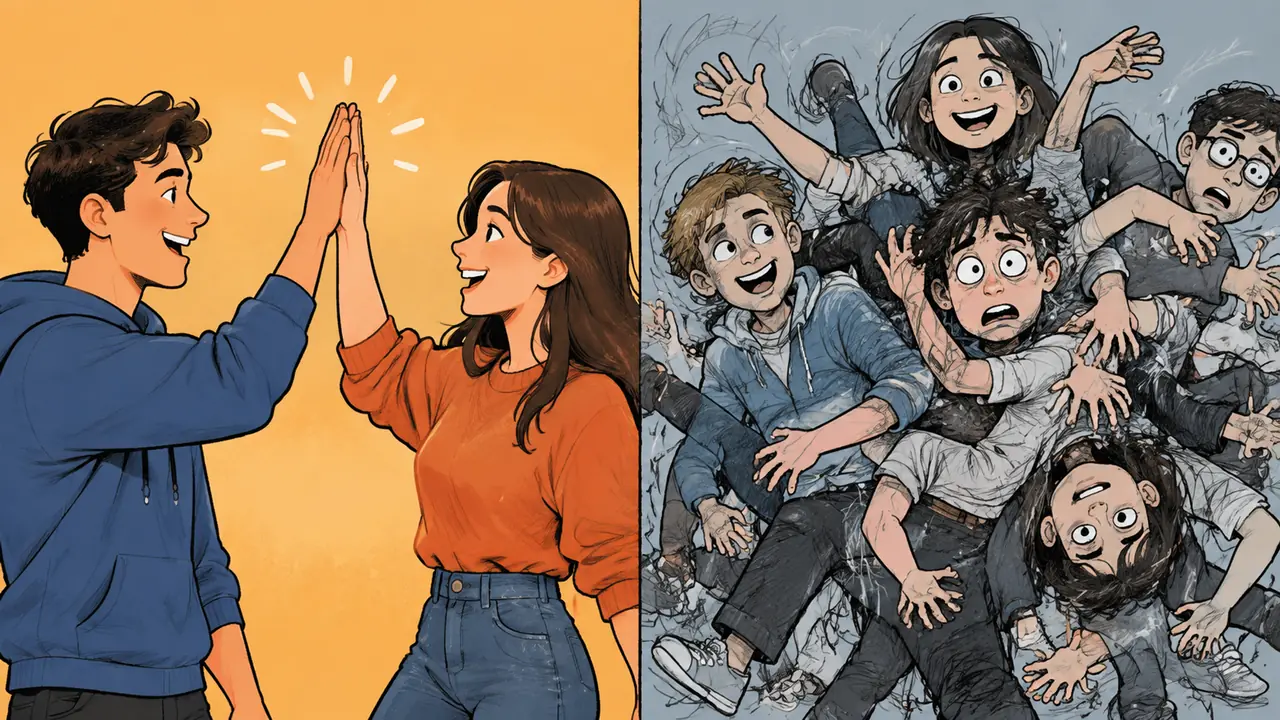
先泼盆冷水:多人图是ai绘画里翻车率最高的一类需求,人数、关系、脸,三道坎一道都躲不开。降预期、写数字、把关系翻译成动作,能做到这三点,废图率能砍掉一大半。方法如下。
ai人工智能绘画多人的图,翻车方式花样百出:三个人画出六只手,说好的双人对视变成了背对背,最离谱的一次,两个人的身体中间还长出了第三张脸。2026年5月我给部门做团建海报,头一晚跑了一百多张,能用的只有两张,那张一百多张的废图文件夹我到现在都留着,算是给自己上的一课。多人图不是不能做,是得多想一步再动手。
单人图的成功经验搬到多人图上会集体失灵,因为模型对"数数"和"关系"这两件事的理解,比你以为的要差得多。下面按三道坎拆开讲。
人数要写成具体数字,别指望模型自己数
直接写"两个人""三个人",比"一群朋友""好几个人"可控得多,人数越多成功率越低,超过四人就做好拼图的准备。
模糊的人数词是多人图的第一杀手。写"聚会场景",模型给三张脸还是五张脸全看心情,多出来的脸从哪长出来的都不知道。我的记录大概是这样:
| 人数写法 | 我的可用率记录 | 建议做法 |
|---|---|---|
| 一个人 | 八成左右 | 随便跑 |
| 两个人 | 三到四成 | 写清站位和朝向 |
| 三个人 | 一成半上下 | 减少动作幅度 |
| 四人及以上 | 几张难留一张 | 分层生成再合成 |
这张表是我2026年5月到8月做图攒下来的个人记录,样本有限,不同工具会有出入,但趋势是稳定的:人数每加一个,难度不是加一,是翻倍。所以四人以上的合影需求,我如今一律不硬跑,直接走分层,省下来的电费和时间够吃顿好的。
人物关系要翻译成动作和朝向,模型才懂谁是谁
"面对面击掌""并肩坐着看手机"这类具体动作,比"好朋友""同事"这种身份词管用,关系写在动作里,模型才能摆对位置。
身份词是多人图第二杀手。你写"老板和员工开会",模型根本分不清哪个是老板,出来俩人穿得差不多,谁是谁全靠脑补。但换成"穿西装的男人站着讲话,穿卫衣的年轻人坐着低头记笔记",画面立刻清楚。身份是抽象概念,动作、朝向、视线才是模型能执行的画面指令。
视线尤其好用。"两人对视"四个字,能把两张各画各的脸拼回一张有交流的图。我还常用"一人指着屏幕,另一人看向屏幕"这种三方关系,指针方向、看的地方都交代了,模型出错的空间就小了。多人各干各事的图也一样,每个人单独一小句描述,动作别超过一个,句子一长模型就开始自由组合。
给个对照实例。团建海报那句让我跑了一百多张废图的原始写法是"公司团队合影,气氛活跃,大家很开心"。拆完之后我改成:"五个年轻人,前排三人坐着比手势,后排两人站着,所有人都看向镜头,办公室背景,明亮配色"。人数、站位、朝向、视线一行交代完,第一轮就出了两张能用的。同一个需求,会写和不会写,差的是一百张废图的时间。
话说回来,也不用把提示词写成说明书。核心关系交代清楚,剩下的留给模型发挥,太长的描述反而互相踩脚,这点和单人图是一样的。
脸一多就糊,分层生成是笨但稳的路子
与其一张图硬塞几张脸,不如先出构图和整体氛围,再对每个人脸做局部重绘,慢是慢点,成图是真能用。
我实测过两条路的差距。团队合影那次,整图硬跑两个多小时,一百多张挑不出一张五官全对的;换成先出一张远景构图,再挨个把人脸框出来重绘,总共两个半小时,出了一张能直接发工作群的成品。多花的半小时,换来的是不用再大海捞针。
局部重绘修脸的时候,把重绘范围框小一点,只框脸,别把头发肩膀一起框进去,不然每次重绘全身都在变,修好一张脸毁了整个姿势。这个坑我踩过四五次才学乖。另外重绘一次只修一个人,修完确认再修下一个,贪快两个一起修,经常按下葫芦浮起瓢。
多人图的难度被太多教程轻描淡写了。记住三道坎:人数写数字、关系写动作、脸糊了走分层。预期降下来,方法用对,多人图从"碰运气"变成"有流程",也就是这么回事。我那张一百多张废图的文件夹还留着,就当是学费的收据。
常见问题
两个人牵手的图为什么手总是崩?
交叠的手部是模型的老大难,牵手、击掌、递东西都属于高危动作。写清"十指相扣"还是"手拉手"区别不大,真崩了就走局部重绘,别硬跑。
多人图提示词里,谁写在前面有区别吗?
有。写在前面的人物通常得到的画面资源和细节更多,主角放前面,配角放后面,构图重心会更符合预期。
生成的多人合照能直接用吗?
看用途。发社交媒体当氛围图,小尺寸看不清五官细节,能用;要印出来或者投屏展示,脸上的瑕疵藏不住,建议走一遍分层修脸再交。