佳佳AI绘画实测:给三个叫佳佳的朋友出图,性格全画对了
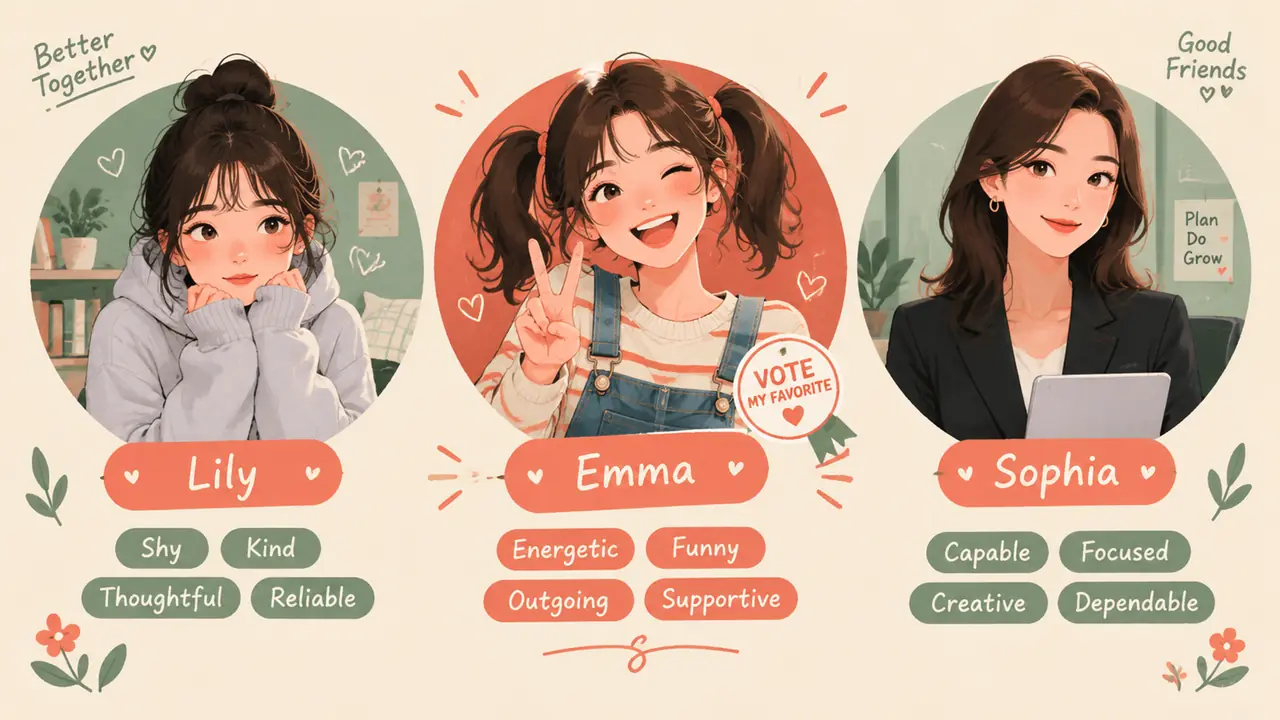
直接给结果:名字本身不带任何画面信息,把性格拆成视觉设定才是关键。我给三个叫佳佳的朋友各出一套头像,社恐配独居场景,闹腾配潮玩高饱和,干练走冷淡线条。十轮迭代后,三个人都说像自己。
事情的起头挺无聊。有天下意识在搜索框敲了「佳佳AI绘画」,想看看能出来什么。结果搜出来一堆不相关的图,还有一个爆款头像教程。老实讲这不难理解,佳佳是常见人名,搜索里叫佳佳的博主、店铺、网名一大把,名字本身没法锁定画面。但我转念一想,名字锁不了画面,人对得上号的东西多了:性格、习惯、常穿的颜色。我身边正好有三个佳佳,室友、表妹、办公室同事,性格南辕北辙。那就做个实验,把她们仨的性格翻译成提示词,各画一套头像,看像不像。
第一步:把性格翻译成视觉词,而不是直接写名字
AI 不认识佳佳是谁,直接写名字只会得到随机脸。正确做法是把性格拆成场景、色板、表情、构图四组视觉词再喂给模型。
先交代三个人的底。室友佳佳,重度社恐,周末能宅一天,养了只不让人碰的仓鼠。表妹佳佳,高一,班里最闹的那个,书包上挂满徽章。同事佳佳,项目经理,说话不带废字,全年黑白灰穿搭。
翻译过程我列个对照。室友佳佳:暖黄台灯光、低饱和、柔和的侧背影、怀里抱东西的姿势。表妹佳佳:高饱和撞色、贴纸元素、咧嘴大笑、正面怼脸构图。同事佳佳:冷灰蓝底、极简线条、眼神平视、留白多的居中构图。这三组词一写出来我就有底了,因为画面差异大到闭眼都能想象。
补充一个当时记在小本子上的细节:四组视觉词里,场景和色板管氛围,表情管神态,构图管气质,四个槽位填满,出图的随机性会小很多。只填一两格的话,模型会用它自己的默认审美把空位补上,补出来多半是影楼风,跟你要的人对不上。
翻车三连:出图和人对不上号的坑
最容易翻车的是把性格词写太抽象,比如「温柔」「活泼」,模型各自理解。改法是把抽象词换成看得见的物证:杯子、耳机、宠物、挂饰。
第一轮翻车在室友佳佳身上。我写了「安静温柔的女孩子」,出来五张,全是影楼写真风,笑得营业味十足。她本人十年没这么笑过。第二张问题出在表妹佳佳,「元气少女」这个词直接召唤出一套日系魔法少女设定,离她的大头贴审美差着十万八千里。
第三次翻车最冤:同事佳佳的图,冷淡风是出来了,但模型给她加了副圆框眼镜加围巾,一股文艺青年味。她本人不戴眼镜,看到图的原话是「这是谁」。三连翻车之后我悟了,抽象性格词是抽奖,物证才是锚点。仓鼠、徽章书包、黑白灰衣柜,把这些具体的东西写进去,出图立刻往人身上靠。第六轮开始,室友佳佳的图里出现了台灯和仓鼠剪影,她看完回了个「有点东西」。
顺便记一个负向词的用法。物证写进去之后,模型偶尔还是会手痒加戏,比如给同事佳佳添首饰、给表妹佳佳换发型。这时候在提示词里用负向提示拦掉,glasses、jewelry 这类词挨个试,拦一条干净一分。物证负责往对的方向拉,负向词负责把多余的手剁掉,两个一起用才省轮次。
定稿标准:本人不说话,让共同好友投票
像不像自己,本人眼睛会骗人,共同好友的直觉更准。每组出八张缩到三张,丢进朋友群盲选,得票最高的那张基本就是定稿。
我的做法是每组跑四十张左右,用固定种子微调提示词,先自己砍到八张。三张进群盲选,投票规则只有一条:别解释,凭第一直觉选「最像她」。结果挺有意思,同事佳佳那组得票最高的是一张侧光图,我自己偏爱的反而是另外一张,群友眼光和我分叉了。但从结果看,他们选中的那张被本人认了,我的备选被本人原话点评「太端庄」。
三套头像最后都定稿了。表妹佳佳把她的图设成了群头像,这是实验里意外的最高认可。整个流程走完我大概花了两个晚上,最大的心得反而是省钱:先写物证再出图,废图率比一开始直接抽低了至少一半。另外记一笔参数,固定种子之后每轮只改一个槽位的词,改表情就不动色板,这样每张图的差异能对应到具体原因,不会越调越糊涂。
回头想这个实验,「佳佳AI绘画」这个搜索词背后,找的多半不是某个固定风格,而是「怎么画出一个具体的人」。名字在提示词里没有分量,性格、习惯、随身物才有。你身边要是也有个叫佳佳的朋友想出头像,别急着堆质量词,先拿张纸把她的性格写成四组看得见的画面词,剩下的交给迭代次数。这套路数换个名字也一样用。
常见问题
把朋友真实长相喂进去画头像合适吗?
建议先问过本人。拿照片垫图出类似气质的插画比直接还原五官更自然,也少踩肖像边界。我们这次实验全程没喂真实照片,纯靠性格词。
两个人性格相近,出图会撞风格吗?
会,靠物证区分。同样内向的两个人,一个养猫一个养仓鼠,一个爱喝茶一个爱咖啡,画面立刻分开。性格词定基调,物证词定辨识度。
这种头像用什么尺寸和比例出图合适?
微信头像按一比一走,建议出 1024 见方再裁。想留出圆形裁切余量,主体别顶着画布边缘,四周留一成空白最稳。