ai形成绘画是怎么一步步发生的?一句话到成图的全过程拆解
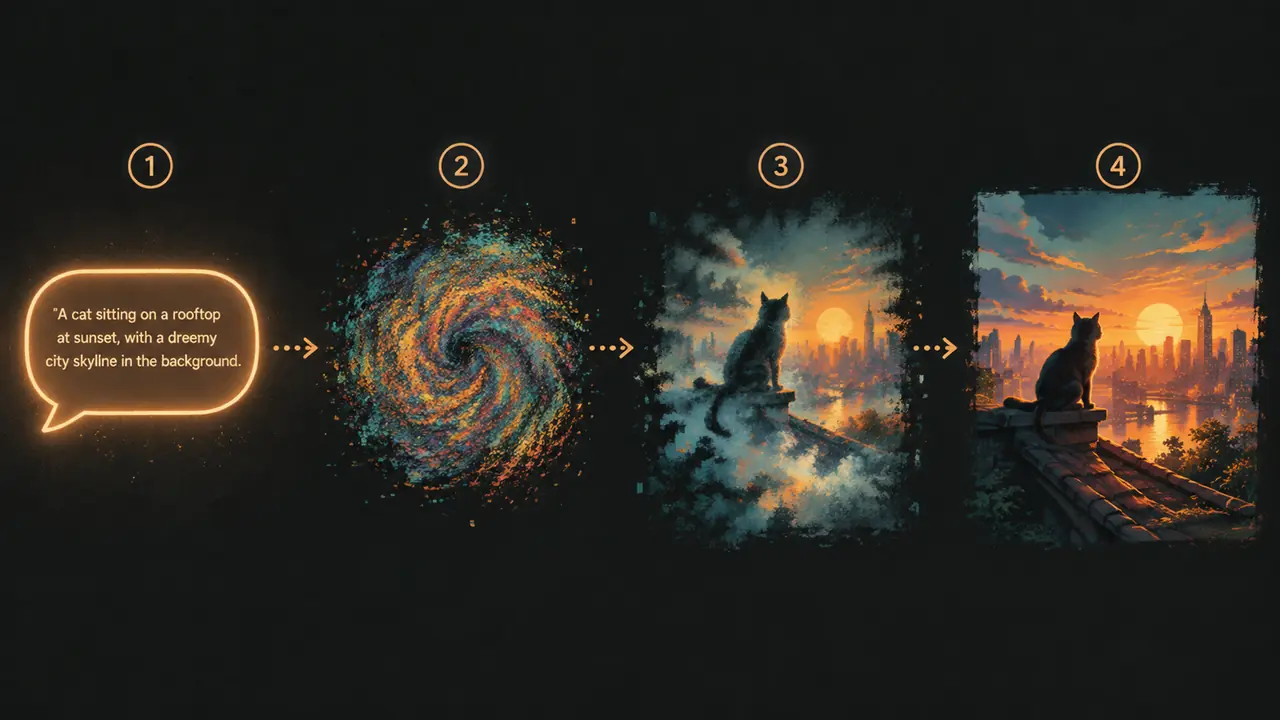
一句话定调:ai形成绘画不神秘,模型先把你的句子翻译成坐标,再从一团雪花噪点起步照着指引去噪,几十步后画面浮现,全程没有魔法。这条流水线每个环节都有对应参数可调,翻车能查出原因。先把你上次翻车的那句提示词翻出来,边读边对照。
ai形成绘画到底经历了什么?答案比多数人想的朴素:先把你敲的句子翻译成机器能懂的语义坐标,再抓一把随机噪点当毛坯,然后照着坐标一遍遍擦掉杂讯。几十步之后,画面就从雪花点里浮出来了。
我为什么劝你搞懂这套过程?因为出图翻车时,九成的锅不在模型:句子自相矛盾、步数没给够、引导强度拉飞,都会让结果崩掉。我本地跑文生图小半年,中间步骤的图存下来对比过好几轮,过程看明白之后,出图确实稳了。下面按流水线顺序拆开讲。
第一步:模型是怎么"听懂"你的句子的
你敲的句子会先被翻译成一串数字坐标,模型不认识汉字,只认语义位置。句子越具体,坐标落点越准,出图就越贴本意。
打个比方:像把中文菜谱交给一位不识中文、手艺却极好的外国厨师。你得先翻成他看得懂的图纸,标清主料、火候、摆盘,他才动得了手。文本编码器干的就这活,把"一只戴帽子的橘猫坐在雨天屋顶"变成一组数字向量。
这组坐标有个脾气:意思近的词,位置也挨得近。"猫"和"橘猫"几乎落在一处,"猫"和"卡车"隔得老远。所以写"橘猫"还是"猫咪",出图差别不大;写"屋顶"还是"草原",那就是两张画。
我在这里踩过一个实打实的坑。有次想画雨中屋顶,顺手补了句"正午阳光穿透雨幕",想着氛围更有戏剧性。结果地面是湿的,反着水光,影子却短得像正午,整张图精神分裂。模型不会替你取舍,它照单全收,两个矛盾的词各画一半。删掉一个,留"暴雨",重跑就顺了。
第二步:去噪循环,画面是怎么一点点长出来的
文生图的核心是去噪:从纯雪花点起步,每一步按句子指引擦掉一点杂讯,先定构图和大色块,细节和手指往往最后才定稿。
米开朗基罗那句老话在这里意外地贴切:雕像本来就在石头里,我只是凿掉多余的部分。去噪就是凿石头,凿掉的不是石屑,是噪点。
我干过件较真的事:把 20 步去噪的中间结果每 5 步存一张。第 1 步,纯雪花,跟老电视没信号一个样。第 5 步,隐约两块色斑,说不出是什么。第 10 步,能认出"一个人站在树下",构图已经稳住。第 15 步,五官和树叶成形。第 20 步收尾,变化最大的居然是手——前十几步那只手一直糊成一团,最后几步才把手指掰开。原来手难画不是玄学,它排在定稿队伍末尾。
那为什么同一句话,每次出的图都不一样?因为起始那把噪点是随机抓的。相当于每次开工换一块纹理不同的大理石,凿法一样,成品气质各异。想复现某一张,把种子固定住,石头不变,结果就不变。
步数给多少合适,我用同一句提示词各跑 5 张做了组对比:
| 步数 | 单张耗时 | 5 张里可用 | 主要问题 |
|---|---|---|---|
| 8 步 | 约 3 秒 | 1 张 | 构图没定住,像凿到一半就停工 |
| 20 步 | 约 6 秒 | 4 张 | 日常出图够用,性价比最高 |
| 40 步 | 约 12 秒 | 4 张 | 时间翻倍,细节提升肉眼难辨 |
结论直白:20 步上下就是拐点。40 步那档,说白了属于心里不踏实才多凿几下。
第三步:两个旋钮,决定出图的稳定度
步数管凿多久,太少画面定不了形;引导强度管模型多听你的话,拉太高颜色发脏、边缘发硬。两个旋钮都别拧到头。
引导强度,我个人的理解是"监工的严厉程度"。调低,模型自由发挥多,你顺嘴提的小细节它懒得管;拉到 15 以上,句句照办,可颜色开始发灰,物体边缘硬得像描了线。我各跑 5 张对比过,15 那组有 3 张颜色发脏,7 那组 4 张可用。我常年停在 7 附近,听话度和画面感刚好平衡。
最后还有一道解码工序:模型在一个压缩空间里凿完,得经过"冲印"才变成你看到的成品图,类比底片冲印照片,底片上影像早就定了,冲出来才算数。有些图看着糊,不一定是画错了,可能只是冲印的分辨率没给够,加一道超分就回来了。
话说回来,句子只能管个大概。想让人物摆出指定姿势,光靠形容词得写到天黑,骨骼控制是更省力的路子,这篇 ai绘画op多指OpenPose?骨骼控姿势从装插件到出图的实测笔记 把从装插件到出图的流程讲得很细。
下次再翻车,别急着怪模型,按流水线倒着查:句子有没有互相打架?步数够不够把形定住?监工是不是拧太狠?三个问题答完,八成"玄学"都有答案。我现在的习惯是先把提示词砍到不能再砍,再谈别的,这个顺序省钱又省卡。
常见问题
跑到一半想改提示词,能中途换吗?
换不了。这轮去噪是按开头那句定死的方向走的,中途换句子基本等于重跑。想半路介入,得走垫图或局部重绘那类玩法,从已有画面往回加点噪点再继续凿。
提示词写中文还是英文好?
多数模型的英文语料吃得多,英文通常更稳。但机器直译容易丢语境,与其堆形容词,不如把主体、动作、场景这几个具体名词写清楚。
为什么句子里写的颜色它经常不理?
一句里塞的元素太多,模型会丢小项。把颜色挪到句子前半段,分量会重一些;实在不行就少给几个要求,一张图别贪太多件事。
手和手指为什么老画崩?
细节排在去噪队伍的末尾,而手指姿态在训练图里千奇百怪,模型容易猜错。与其死磕提示词,出图后用局部重绘修手,快得多。
它会不会直接抄训练图里的某一张?
它记住的是概念的平均样貌,不是从图库里复印。不过画出特定动漫角色或明显 IP 形象时,个人欣赏自用没问题,商用授权另算,这条边界要记住。