语音ai绘画怎么玩才出图准?口播描述的断句、补词与返工实测
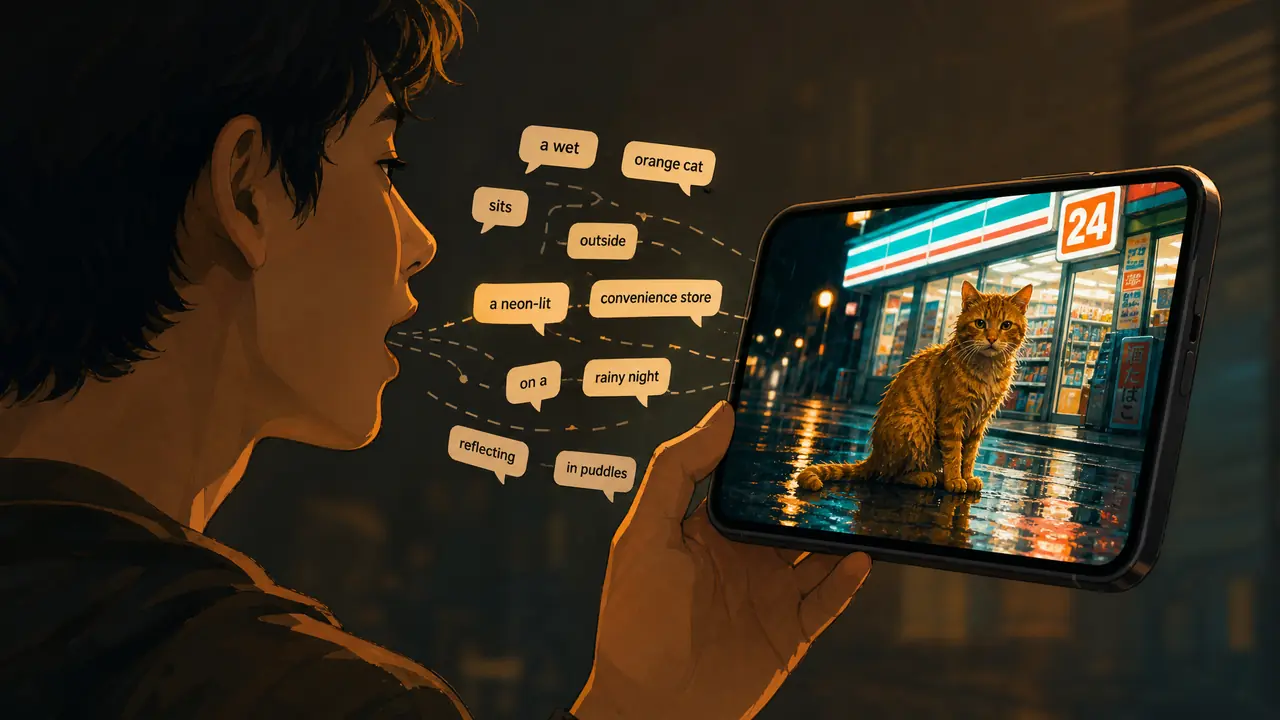
先亮态度:语音ai绘画值得上手,门槛确实比打字低,但像聊天一样念提示词是废片重灾区。胜负手在断句和关键词前置,念法改对,十张里能用的能从三成涨到七成。先照报菜名模板念一遍再出图,比出完图再骂模型有用得多。
语音ai绘画的核心玩法一句话讲完:对着麦克风把画面念出来,模型直接出图,全程不碰键盘。我的结论是这玩法靠谱,前提是你别用聊天腔念。口播省的是打字时间,费的是返工次数,两头的账要一起算。
场景很实际:做饭时手上有油、通勤单手握着手机、或者躺着想偷懒,这些时候打长段描述是折磨,张嘴念顺手多了。我试了一个星期,每晚用口播出二十来张图,翻车样本全存下来对比,才摸到下面这些门道。
口播和打字出图差在哪:同一段场景的十连拍实测
口播快在输入、输在啰嗦:同一段便利店雨夜场景,聊天腔念着跑十张只有三张能看,改成报菜名式短句后能看的有七张,单张返工时间也从两分钟压到二十秒上下。
实验设置说清楚。画面主体定成"雨夜便利店门口一只湿透的橘猫",打字版描述四十七个字,口播版直接对着手机说,两边各跑十张。打字那轮六张能用,口播第一轮只有三张能用,差距全在口水词上。念的时候我带了一堆"然后""旁边还有""就是那种",模型照单全收,画面里硬塞进两个路人加一把伞,橘猫被挤到角落。
说实话这结果有点出乎意料。我本来以为语音转文字之后模型会自己清洗一遍,实际根本不会,你念什么它画什么,连语气词"嗯"都可能变成画面里的杂物。后来我念之前先在心里过一遍稿子,废片率才压下来。
| 念法 | 十张能用 | 单条口播耗时 | 主要崩点 |
|---|---|---|---|
| 聊天腔,带然后、就是 | 约3张 | 12秒左右 | 主体多、构图乱 |
| 报菜名短句,关键词前置 | 约7张 | 9秒左右 | 偶尔光线不对 |
口播稿怎么念:断句、停顿和关键词前置的模板
念提示词要像报菜名:主体先行,风格、光线、构图各占一短句,句与句之间停半秒。别讲完整的故事句,模型分不清主次,会平均用力。
模板直接给。第一句只念主体:"湿透的橘猫,蹲在便利店门口"。第二句念环境和光线:"雨夜,玻璃门透出暖黄灯光"。第三句补风格:"写实照片感,浅景深"。三句念完停一秒再按出图。这个节奏念下来,识别准确度比连着念高一截,个人猜测是停顿帮语音引擎切好了分句。
关键词前置是另一条铁律。重要的词放每句开头,"湿透"比"一只猫浑身都淋湿了"好使,模型对句首的词权重更高。我拿同一张图试过,把"湿透"挪到句首后,毛发贴在身上的质感十张里出现了八张,放句尾只有四张。一手对比摆在这,信不信由你。
话说回来,口播也有打字比不了的地方。灵感上头时嘴里蹦出来的怪词,比如"霓虹灯在水洼里化开",这种形容打字时反而憋不出来。所以我现在的习惯是口播攒稿子,特别关键的图再切回键盘精修一遍。
出图翻车怎么救:一句话补丁的返工节奏
别推翻重念,用局部补丁改图:一句"只把背景换成黄昏"十到二十秒一轮,两张以内基本能救回。整段重念反而容易把已经对了的部分也改坏。
翻车案例照实说。有一次猫的姿态对了,画面右侧却多出来一只手,看着像旁边蹲了个人,渗人。我的补法是念"去掉画面右侧的人,只留猫",第一轮没去掉,第二轮在前面加了句"画面里只有一只猫",成了。补丁句要指名方位和对象,模糊的"清理一下画面"没用,模型不知道你嫌弃啥。
另一个常见崩点是爪子。猫爪搭在台阶边缘的那张,十张里有三张爪子会糊成一团。遇到就念"爪子清晰,趾头分开"这种短补丁,两轮内大概率修好。修不好就放弃,别跟一张图死磕,口播的效率优势本来就在量大筛选上。
补丁有个边界要记:每次只改一处。我贪心过一回,一句话里又改背景又改光线,结果两边全崩,退回单处修改才稳住。
回到开头那笔账:语音ai绘画省下打字的一分钟,代价可能是五分钟返工,念法不改这笔买卖就是亏的。报菜名断句、关键词前置、一句话补丁,三件事凑齐,口播出图的效率才真正反超键盘。晚上想偷懒出图的时候,先把这三句口诀过一遍再开工。
常见问题
语音ai绘画对口音有要求吗?
带口音不影响识别大意,但专有名词容易转错字,画风名称一转错就跑风格。遇到转不准的词,换成大白话描述,或者事后用文字补一句再出。
念多长一段描述合适?
三短句以内最稳,总时长控制在十秒上下。超过三十秒的口播,模型会自行取舍,重点词被稀释,画面反而平庸。
嘈杂环境能用语音出图吗?
地铁、街边这类环境背景音会混进描述,偶尔冒出莫名其妙的元素。安静室内效果最好,真要在外面用,把手机凑近嘴边放慢速度念。
口播出的图能商用吗?
日常商用可以,涉及真人长相或知名IP形象时要留意,个人欣赏自用没问题,商用授权另算,别拿这类图直接带货。
方言能不能用来念提示词?
主流识别引擎对普通话识别最稳,方言十句里总有几个词转偏。想用也行,出图前把转出来的文字检查一遍再提交。