AI技术AIGC AI绘画AI视频怎么串成一个工作流?出图到图生视频的入门路线
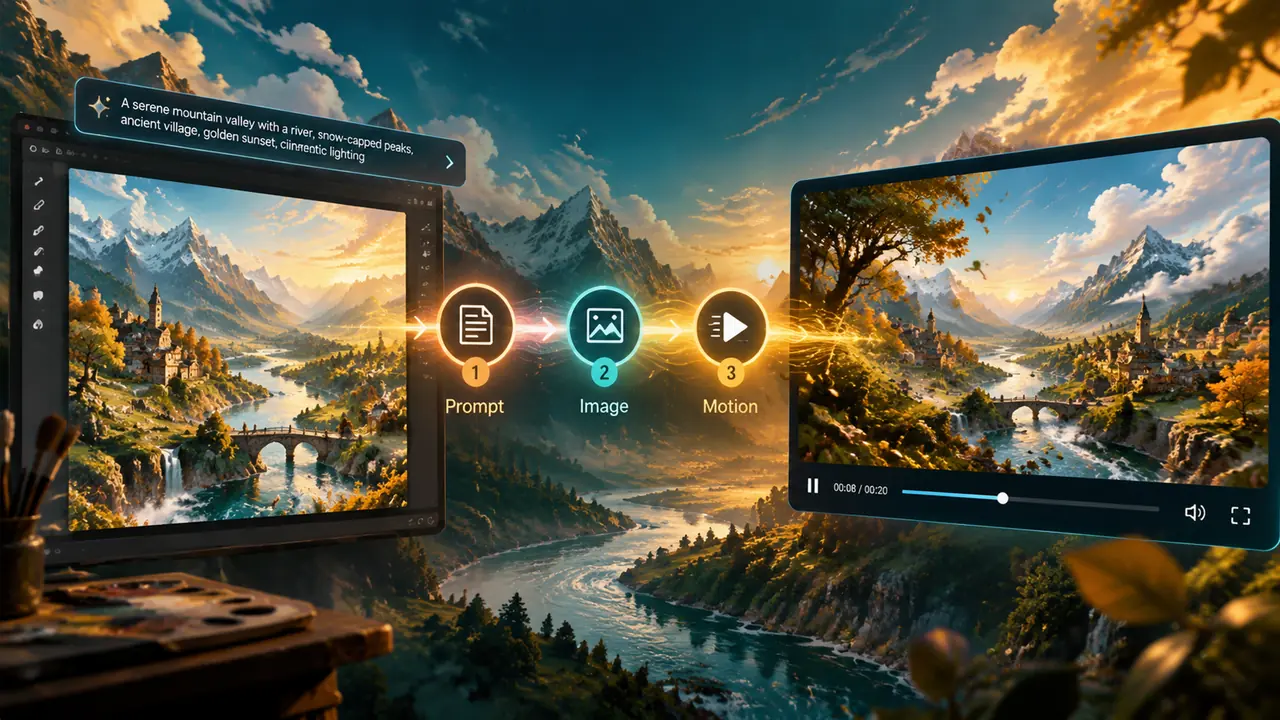
先把两个工具接起来:AI绘画负责出图,AI视频负责让这张图动起来,它们是同一条流水线的上下游,不是两门要分开修的手艺。顺序上先练出图,出图不过关,图生视频只会把瑕疵放大成动态崩坏。读者该做的第一件事,是把手头绘画端的单张质量稳定到十张能用八张,再去碰视频端。
AIGC 的工作流入门,最容易走弯路的地方就是把AI绘画和AI视频当成两个独立课程报班。我的结论很直接:把它看成一条线,文字出图是上游,图生视频是下游,中间只隔一张你挑出来的最好图。上游质量决定下游上限,这个关系定了,学习顺序就没得争。
为什么值得按这个思路学?我上个月帮朋友做一条 十五秒的产品短片,他先学了半个月视频端,结果每次生成完都要回过头改图。原因很简单:视频模型会忠实继承首帧的一切,构图歪、手部崩、光位乱,静态时还能修,一动起来五秒里全被放大。后来改成先出图后做视频,整条片子三天跑通。
先出图还是先学视频?顺序错了两头返工
先练AI绘画再碰AI视频:出图不过关,图生视频会把构图与手部瑕疵放大成动态崩坏,顺序对了能省近一半学习成本。后面细说这个判断怎么来的。
视频生成模型对首帧的继承是全盘的,好的坏的都收。我做过一组对照:同一张手指结构有问题的图,拿去生成五秒片段,五秒里有四秒能看清那只崩掉的手,还多了一截凭空出现的关节。换成构图干净的图,同一段动作提示词,一次就过。
这就是下游依赖上游的证据。静态图上的问题你还有重绘、局部修复这些手段兜底;视频一旦动了,修起来的成本是出图的几倍。所以入门路线应该是:先把出图这关过了,视频端只需要学参数和节奏,剩下的都是顺水推舟。
有人会问,纯文字直接生成视频不行吗?行,但可控性差很多。文生视频目前对细节的服从度远不如图生视频,你没法精确控制画面里每个元素的位置。个人觉得直接文生视频这条路,短期内对做正经内容的创作者都不算高效。
出图这关怎么过:稳定比灵感值钱
出图阶段目标是把单张质量稳定下来:固定提示词结构、固定参数,先追求十张里八张能用,再谈风格化。抽卡式碰运气是这阶段最大的坑。
我的做法是提示词三段式:主体描述、环境与光位、画质与镜头词,各占一块,中间不混。参数上,步数三十起步,CFG 控制在六到八,尺寸先固定一档别乱切。同一提示词我先跑十张,统计能用的张数,低于八张就回去改词,不改参数。
我试了下让一个新号直接「凭感觉写提示词」,十张里能用的两张,手指崩了六张,画面里还经常冒出乱码一样的伪文字。换成三段式之后,十张能用八张,光位正确的也有八张上下。差距不在灵感,在结构。
光线是出图阶段最常翻车的一项,室内外光混写会让整张图的质感发灰。这部分展开讲会很占篇幅,我之前专门整理过一篇户外光位的分档实操,正午顶光、黄昏侧逆光、阴天柔光各有一套写法,出图总画成室内光的朋友可以直接看ai外部绘画总画成室内光?正午顶光、黄昏侧逆光、阴天柔光三档户外光实操。
翻车修复也说一个。有张图主体很好,但背景里的人物手部糊成一块。我没整张重跑,用局部重绘只处理那块区域,蒙版开小一点,两次就修好了。整张重跑等于把前面八张的运气清零,能局部救就局部救。
图生视频怎么接:首帧挑最好的,动作做减法
图生视频的核心是给静态图加时间轴:首帧用你最好的那张,提示词只写一到两个动作,运镜宁小勿大。动作堆得越多,崩得越快。
选首帧别手软,十张里挑那一张最稳的,别心疼。我的标准是:主体结构无瑕疵、光位明确、背景没有会骗到视频模型的奇怪纹理。水面、网格、密密麻麻的字,都容易在动态里被解读成奇怪的形变源。
动作提示词做减法。五秒片段里写「头发被风吹动,镜头缓慢推进」,比写「转身、抬手、微笑、走过来再坐下」成功率高得多。我统计过自己最近的批次:单动作提示词十次能成四次,堆三个以上动作的十次成不了一次。抽卡是常态,按这个命中率预留时间就行。
运镜同理。大幅度环绕、快速推拉,目前模型驾驭得都很勉强,画面容易撕裂。小幅度推进、轻微横移,是成功率最高的两档。说实话,很多教程吹的复杂运镜,我实测下来观赏性还不如一个稳稳的缓慢推进。
片段时长也有讲究。五秒是最稳的一档,十秒开始出现主体漂移,人物脸部细节会悄悄变化。需要长片段就拆成多段五秒,首尾帧对上再接,比硬生成一段十五秒靠谱。
工具与参数搭配:一张表看懂上下游
绘画端和视频端分开选型即可,图片格式通用就能对接,不必强求同一家的全家桶。真正要盯的是每个环节的关键参数区间。
我自己的流程用一张表说清楚,数值是我在单张 4070 的机器上跑出来的经验值,供参考:
| 环节 | 干的事 | 关键参数 | 我的经验值 |
|---|---|---|---|
| 文字出图 | 提示词变画面 | 步数、CFG、尺寸 | 三十步起步,CFG 六到八,一档尺寸别乱切 |
| 筛选修复 | 挑首帧、局部救图 | 重绘幅度、蒙版范围 | 蒙版开小,重绘幅度零点四以内 |
| 图生视频 | 静态变动 | 时长、运动幅度 | 五秒一档,单动作,小幅运镜 |
| 串联成片 | 多段拼接配乐 | 首尾帧衔接 | 段间留半秒重叠,剪掉漂移帧 |
这套表的意义是把不确定的地方圈出来。出图和视频端工具换什么牌子都行,参数逻辑不变。你要是换了机器,只改时间预期,不用改流程。
回到开头那句:AIGC 入门真正的捷径是把AI绘画和AI视频接成一条线,上游出图稳了,下游图生视频就是顺水推舟。先花一两周把单张出图练到十张能用八张,再挑最好的首帧、写最短的动作词去接视频。整条路走通之后,你会发现两个工具学的其实是同一套审美:结构、光位、节奏,哪一环都躲不开。
常见问题
零基础一天能跑通整条工作流吗?
跑通可以,跑好不行。照着三段式提示词和五秒片段的参数,一个晚上能出第一条片子,质量大概率一般。给自己一周,前五天只练出图,后两天接视频,节奏最舒服。
显卡不行能玩图生视频吗?
本地跑确实吃显存,十二 G 以下会很挣扎。两条路:用在线平台的视频生成额度,按条付费,适合先验证流程;或者出图本地做、视频云端跑,混合着来,成本可控。
抽卡抽不出来怎么办?
先查首帧再查提示词。十次成不了一次,多半是首帧里藏着形变源,比如水面、网格、密集文字,换一张干净的图,命中率立刻不一样。别闷头改动作词。
生成的视频人物脸部会变,怎么压住?
首帧人脸占比别太大,特写最容易被漂移。中景以上开始,动作幅度收小,时长压在五秒内,脸稳得多。要特写就接受多抽几次卡,或者拆段分镜。