吊打ai绘画的说法靠谱吗?同题多工具实测,谁强谁弱数据说了算
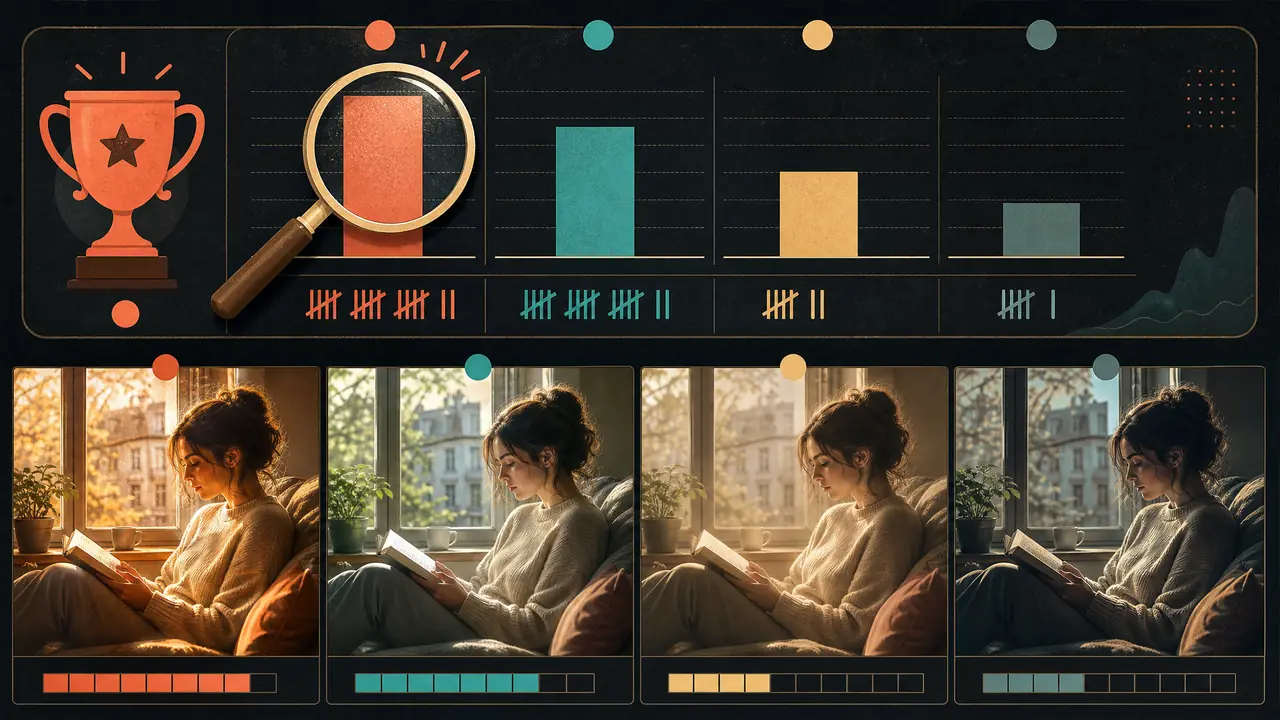
讲个明白:「吊打」十有八九是单张截图撑起来的说法,换一组提示词排名就会重排。我把同一条提示词丢给四款工具各跑十张,八十张图按四个硬指标逐项打分,没有一家全项领先。想自己下结论,先照文末的五步测法跑一轮同题。
「吊打ai绘画」这类说法,我刷到就先打个问号。这轮同题实测做完,结论更明确了:四款工具八十张图测下来,没有谁能全项碾压。所谓吊打,只在某个单项上短暂成立,拉到全局就是话术。
起因是朋友转来一张对比截图,配文写着「这就是代差」。图里左边的手崩了指头,右边完好无损。说实话,单看那张图我差点也信了。可我转头用同一条提示词在右边那款上重跑了十张,也有一张的手不对。样本从一张变成十张,故事立刻不一样。这事儿让我决定正经做一轮测试。
一张「吊打」截图,到底能说明什么
单张截图的样本量是一,对面那张恰好崩、你这张恰好好,运气占比说不清,它证明不了模型之间的真实差距。我翻过手头几十张流传很广的对比图,能站住脚的没几张。
第一种最好认:单题翻车截图。对面最崩的一张,配自己最漂亮的一张,中间被略过的九张没人追问。
第二种隐蔽些,任务错位。拿文字渲染强的工具去比光影,等于让短跑选手去游泳,还没起跑输赢就定了。反过来比拼写,光影强的那家照样被按在地上。
第三种最冤,参数不对等。一边默认设置一键出图,另一边调了半小时步数和权重,比的是调参功夫,不是模型底子。说白了,大多数「吊打」比的都不是两个模型,是两张截图各自的运气。
同题四工具实测:一条提示词,八十张图
同一条提示词原文不动,四款工具各跑十张,按服从度、手部、文字、光位四项数数打分,样本够大结论才站得住。下面是完整过程和全部数据。
测试对象是我订阅里的四个模型,按定位叫它们全能旗舰款A、艺术特化款B、开源自部署款C、写实特化款D。不点名的原因很实际:版本更新太快,今天的数据下个月就过期,点名反而容易被较真。提示词只用两条:一条人物半身,「穿米色毛衣的短发女生,坐在窗边看书,午后侧光」;一条咖啡馆海报,带英文大字 COFFEE 25。每款每题各十张,尺寸统一,参数能锁的全锁死。设置这块我没乱动,C 款的采样步数和 CFG 要么固定要么随手记录,哪些旋钮容易踩坑,之前写过一篇ai设置绘画别乱动:五项设置逐个吃透的避坑笔记,这里不重复。
评分全用能数的硬指标:服从度看指定元素齐不齐、数量对不对;手指看十张里指头数目和姿势没崩的张数;文字看 COFFEE 25 两个词完全拼对的张数;光位看侧光方向跟提示词一致的张数。四轮数完,结果是这样。
| 同题得分 | 服从度 | 手指正确 | 文字拼写 | 光位稳定 |
|---|---|---|---|---|
| 全能旗舰款A | 9/10 | 7/10 | 6/10 | 8/10 |
| 艺术特化款B | 6/10 | 9/10 | 2/10 | 9/10 |
| 开源自部署款C | 8/10 | 5/10 | 4/10 | 6/10 |
| 写实特化款D | 7/10 | 8/10 | 7/10 | 7/10 |
翻车最狠的是 B 款的文字。十张海报里,COFFEE 有六张要么少个 E、要么多个 E,最可惜的一张画面极好,25 却写反成了 52。C 款也有意外:三张人物把提示词里的米色毛衣画成了黑灰高领,我把颜色词单独提到句首重跑,十张里八张颜色就对上了。写法挪一个位置,结果翻一篇,这种细节恰恰是单张截图永远测不出来的。
顺带一提成本。C 款跑在我那块 3080 上,一张 9 秒,零订阅费;另外三款在云端排队,一张要等十几秒到一分钟不等。分数垫底不代表没人用,便宜和快本身就是竞争力。
四项加起来,谁也没有吊打谁
四项得分相加,A 款 30、D 款 29、B 款 26、C 款 23,最高与最低差七张图,选型该看你的主任务,别看谁被吊打。
谁被吊打了?测完我的答案是:谁都没有。总分最高的 A 款,优势也就是十张里多对一两张,换一组提示词未必保得住。真正的信息全在单项里。B 款总分不高,手和光双第一,画人物特写我第一个想到它;D 款各项都不冒尖,可文字 7/10 是四家最好,做带字海报它反而最稳;C 款分数垫底,胜在免费和快,批量出图的人照样离不开。
所以我的用法变成这样:先想清楚一周里出图最常干的三件事,哪件占时最多,就拿那件事的指标去对表。常挂文字选 D,画人物手部特写选 B,批量做素材选 C,什么都干一点的,A 这种全能款才划算。个人觉得,这不算和稀泥,算按需下单。
五步同题测法,今天就能照抄
固定提示词与参数,单组至少十张,先定评分项再出图,过程留档,最后换题复测,五步做完再谈强弱。步骤不复杂,难的是忍住不偷懒。
第一步,定题。挑你真实会用的场景当提示词,别用「一只猫」这种泛题,元素越具体越能拉开差距。第二步,锁变量。提示词原文复制粘贴,尺寸统一,采样步数、CFG 能固定就固定,动过的都记下来。第三步,批量跑。每款至少十张,一张不作数。我第一轮只跑了五张,B 款排名虚高了一截,加到十张立刻现形。第四步,数数打分。先挑能数的:元素齐不齐、单词拼没拼对、手指几根;「好不好看」这种主观分放最后,容易被第一眼带偏。第五步,换题复测。整套流程换个提示词再来一遍,两次排名对得上,结论才敢往外说。
对了,测到一半有人喜欢往里垫图,提醒一句:一旦喂了参考图,测的就不再是提示词能力了。垫图这条路本身有讲究,画稿拍得清不清楚直接影响出图,绘画ai拍摄怎么配合:画稿拍清楚再喂AI,图生图成功率高一半这篇讲得更细,想走图生图路线的可以先看。
回到开头那张让朋友信了半截的截图。放进我这轮数据里看,它顶多算某款工具十张里崩掉的那一两张,凑巧被截了图。工具之间确实有强弱,但强弱按任务、按单项算,谁也吊打不了谁的全部门面。下次再刷到吊打体标题,先别急着换装备,花一个晚上照五步跑一轮,你手里的数据比任何标题都硬。
常见问题
锁参数是什么意思,所有工具都能锁吗?
就是把采样步数、随机种子这类设置固定住,让各家尽量在同等条件下出图。有的云端工具不给锁种子,那就至少把提示词原文和尺寸钉死,其余设置截图留档,写结论时注明哪些没法对齐。
测多少张才有说服力?
我的底线是单项十张,十张里对七张和对两张,一眼就能看出来。预算紧可以先跑五张摸底,但要写成给别人看的结论,别低于十张。
免费工具和付费工具放一起测,公平吗?
公平,条件对等就行。付费的别开专属高清修复,免费的别手动加放大,大家裸跑同一组参数,比出来的才是模型本身的差距。
「吊打」的说法就完全不可信吗?
也不至于。单项碾压确实存在,比如文字渲染上 D 款对 B 款就是 7 比 2 的悬殊。不可信的是把单项战果说成全项胜利,句式一夸张,数据就变味。
测出来分差很小怎么办?
两三分的差距基本在噪声里。我的做法是加跑一组题,或者隔几天重测一轮,结果能复现才算数,复现不了就老实写「打平」。