跪着ai绘画为什么总崩?膝盖、重心、裙摆三个崩点和提示词写法
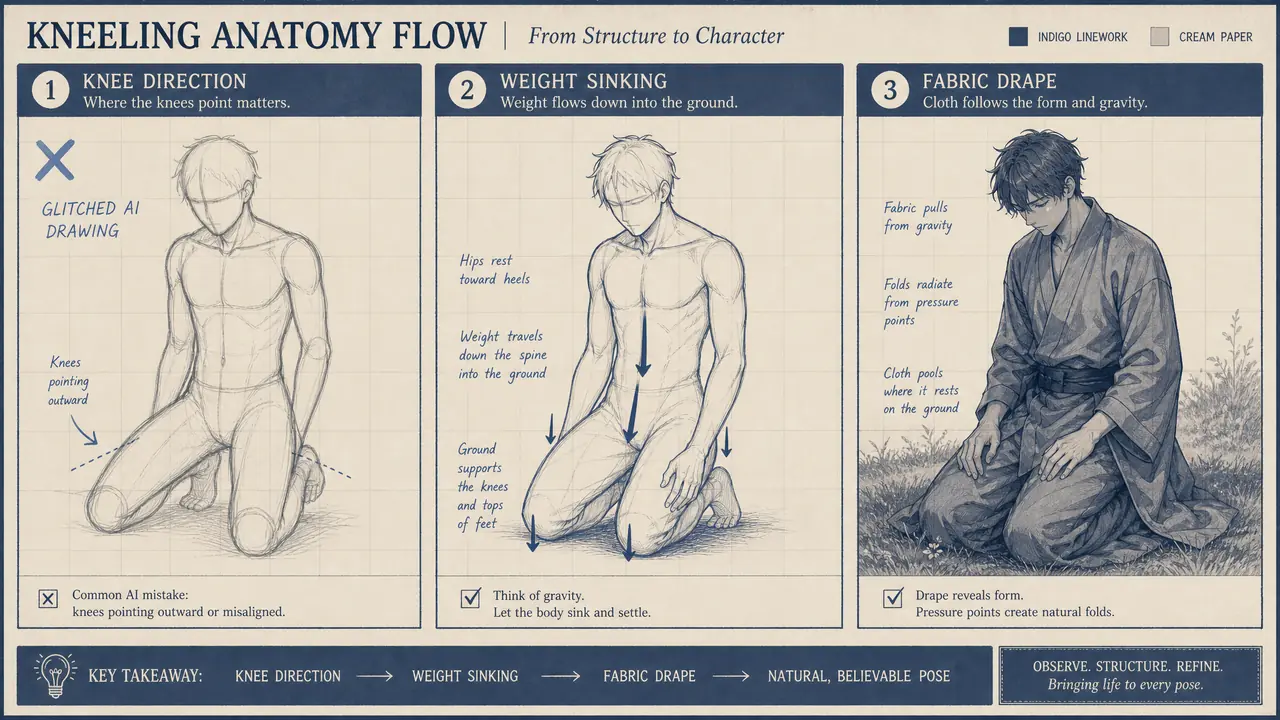
我的判断是:跪着ai绘画崩,九成崩在膝盖和重心,不在画质。AI对"跪"的理解是笼统的,正座、单膝跪、蹲跪在它那是一锅粥。你现在能做的是把姿势词写死、给地面参照、开骨骼控制,成功率立刻不一样。
带学生用AI出图快一年了,被问得最多的问题里,跪姿稳进前三。明明脸画得挺好看,膝盖一出来就开始抽象:两个膝盖朝相反方向拐、人悬在半空、裙子和腿搅成一团。学生第一反应都是怪模型不行。真不怪模型,怪我们没把话说明白。
人画画的时候,画跪姿会先想重心压在哪条腿、膝盖窝卡没卡住脚踝。AI没这个思考过程,它只是从训练图里回忆"跪"长什么样。回忆得模糊,就画得离谱。所以解法也简单:你替它把模糊的地方说清楚。
跪姿最容易崩的三个地方,各有对策
跪姿崩点集中在膝盖朝向、重心落点和裙摆接触:正座要写sitting on heels,单膝跪要写清哪条腿跪,裙装要给裙摆铺开的方向。逐个钉死,崩点少一大半。
先说膝盖朝向。日本正座这种姿势,AI的理解意外地稳,写"seiza"或者"sitting on heels, knees together"基本能对。崩得多的是单膝跪——求婚、系鞋带、骑士礼都算。我学生的原话提示词是"kneeling",模型随机选一种跪法,出六条腿的概率大概三成。后来改成"one knee on the ground, other leg bent in front, hands clasped",20张里能挑3张。再叠加骨骼图之后,12张能挑5张,这才算能交付的水平。
重心是最隐蔽的崩点。看起来四肢都对,人却像漂在地上,因为AI没画体重。对策是加接触参照:"weight sinking into the ground""pressure on the knee visible on the fabric"。布料受压的凹陷一出来,人就"坐"进画面里了。这招对厚裙装尤其灵。
裙摆是重灾区。跪姿会让裙子的褶皱逻辑变得很复杂,AI经常让裙子直接穿过膝盖。我的笨办法是负面词伺候:把"cloth intersecting legs, deformed knees, extra limbs"全塞进负面,再把采样步数从25提到30,让细节有足够的步数去理顺。别嫌慢,重跑一轮的时间比修图便宜。
地面材质也挑人。同一套提示词换三种地面我全试过:草地跪姿最稳,草叶本身就把接触的地方糊掉了;木地板其次;大理石最惨,倒影里六条腿看得清清楚楚。碰上反光地面,记得把"reflection"写进负面,能少掉一半怪图。
提示词之外,骨骼控制才是跪姿的保险栓
提示词定姿势类型,OpenPose骨骼图定精确角度,两者配合跪姿才稳:骨骼图自己摆一个,重绘幅度压到0.35以内。只堆词不锁骨,等于赌运气。
我自己用的组合是OpenPose加深度图。OpenPose管四肢位置,深度图管前后关系,双开之后跪姿的"架势"基本不会错。骨骼图哪来的?两个途径,一是找真人参考照片自动提取,二是直接在骨骼编辑器里摆。跪姿的骨骼挺好摆,就几个关节点的事。
重绘幅度是另一道保险。跪姿属于结构性内容,幅度高于0.5,骨骼图等于白摆,模型会把你的膝盖再掰回它喜欢的样子。我固定用0.3到0.35,采样器DPM++ 2M Karras,28步。这套参数跑出来的跪姿,骨骼忠实度挺高,细节让高清修复阶段去补。
岔开说一句,别指望姿势一次到位。我见过最执着的学生,同一个跪姿跑了六十多张才满意。其实跑到二十张还没对,问题多半不在运气,在骨骼图本身摆得别扭——关节角度超出了真人能做出的范围,模型硬凹就会畸变。摆完自己照着做一遍那个动作,你做不出来,它也画不出来。
回到学生问我的那个问题:跪着ai绘画为什么总崩?答案就一句,你没把"跪"拆开讲给它听。膝盖、重心、裙摆,一处一处交代清楚,配上骨骼图,这姿势的出图成功率能从碰运气变成十拿九稳。
常见问题
为什么跪姿比站姿坐姿更容易崩?
训练图里跪姿占比少,而且变化多——正座、单膝跪、跪坐后仰,各是各的样子。样本杂,模型记得就糊。站姿它见得多,闭着眼也不会错到哪去。
不用ControlNet,纯提示词能画对跪姿吗?
正座这类常见姿势可以,加上sitting on heels就稳。单膝跪、回眸跪这类刁钻角度,纯词很难,建议还是上骨骼图,省下的跑图电费都值回功夫。
跪姿的手怎么老出问题?
手撑地、手扶膝这些动作会把手和地面、腿部贴在一起,AI分不清边界。把手部单独框蒙版重绘,或者让手拿个道具隔开,都管用。