ai绘画无敌气场怎么画:低机位仰视+逆光剪影,碾压感一次到位
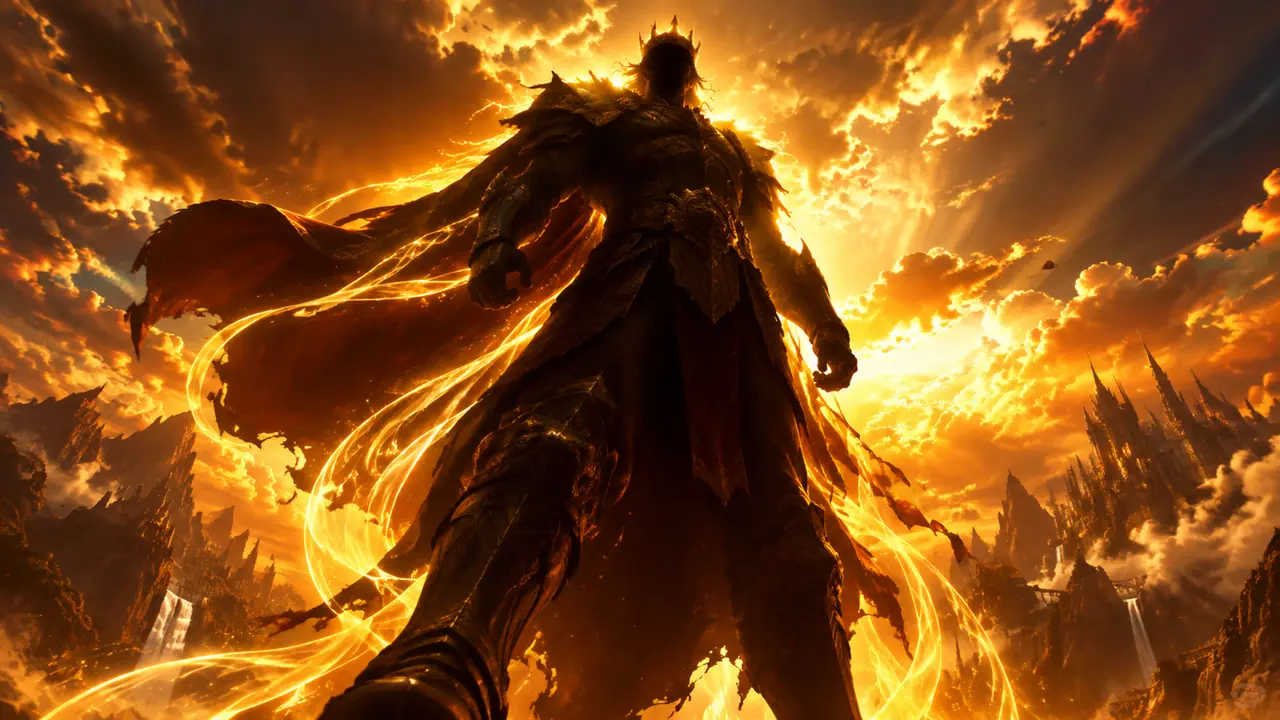
先把判断放这:ai绘画无敌感的关键在镜头姿态,不在特效数量,低机位仰视加逆光剪影是成图率最高的组合。依据是我拿同一个角色设定抽了二十张卡的对比,元素最少的那版成图率翻了近四倍。你现在就可以把提示词里的特效词砍到一条,先出一张试试水。
想让ai绘画无敌感一次成图,诀窍不在特效词堆多少,而在三件事:镜头放低、光挪到人物背后、画面里的杂物全删掉。同一个王者角色设定,我做过一组对照:特效拉满的十张只成了两张,做减法的那组十张成了六张。差距就是这么直白。
无敌气场有点像舞台追光。观众其实看不见灯,只看得见被照亮的那个人——光越集中,人越"大"。你往画面里塞的东西越多,追光就越散,人也就越小。先记住这一点,后面所有操作都围着它转。
低机位仰视:整张图的"身高差"是这么压出来的
把镜头压到人物膝盖以下,让头顶顶破画面上沿,人物占竖构图七成以上高度,无敌感就完成了一半。剩下的一半交给光,下一节再说。机位是地基,地基歪了,后面全白搭。
最直观的理解方式:蹲下来拍一只大狗,狗都显得像狮子。AI同理。low angle shot 这个词我最初直接写进提示词,十张里七八张还是平视,模型对它的执行相当敷衍。后来换了两个思路,命中率才上来:一是加 foreshortening(透视缩短),强迫模型把近大远小做出来;二是把视角词的权重拉到1.3左右,平视立刻少了一大半。
| 视角写法 | 仰视强度 | 二十张成图 | 适合的画面 |
|---|---|---|---|
| low angle shot | 温和 | 9张 | 日常向的强势感 |
| from below + foreshortening | 狠 | 13张 | 王者俯视众生 |
| worm's eye view | 极端 | 7张 | 极限气场,脚容易崩 |
| 低机位 + dutch angle | 歪斜但不稳 | 5张 | 战斗定格瞬间 |
人物占比我固定在竖构图的70%-85%。低于这个数,角色像站在远处摆拍;超过85%,头顶裁掉太多,气场反而泄了。脚是重灾区——仰视越狠,脚崩得越勤,我的土办法是把膝盖以下直接裁出画面。省事,而且裁切本身自带一种"逼近感",像是他正朝你走过来。
有一张成图我至今留着:机位几乎贴地,镜头前虚掉几根草,人物从画面顶端压下来。朋友看到的第一反应是"这人得有两米五吧"——实际设定身高一米八八。低机位就是这么不讲道理。
逆光和气场特效,提示词的顺序比数量重要?
先写光,再写人,最后写气场,光带只留一条:剪影词放最前段时,画面干净得像换了个模型。顺序颠倒、特效翻倍,出来的就是一团发光的糊,这是我最贵的一次教训。
我的模板现在长这样:backlit silhouette 放最前面,接着一句 rim light on shoulders,然后才是角色本体的描述,气场词只保留一个 glowing aura trail。单张出图约15秒,步数28,CFG给到7。抽卡二十张,成图率从3张涨到11张——改的不是模型,是词的排布顺序。
之前那版失败的写法,我把 glowing aura、energy particles、divine light rays、floating embers 四个特效词全塞了进去。结果人物被光吞了,五官糊成一团油彩,气势没出来,倒像一锅烧糊的糖。删到只剩一条光带之后,人物轮廓反而立住了。无敌感这东西,原来靠的是"藏",不是"秀"。
翻车实录:我以为封神的那组图,像景区cos合影
画面信息过载是无敌感的头号杀手:王座、披风、士兵、烟花一起上,气场直接被稀释成影楼写真。我翻车最惨的一次就栽在这,二十张废卡换来一条铁律——每张画面只允许一个"最"。
那天我觉得自己无敌了。王座、披风、跪地士兵、漫天金色粒子,词全写上了,心想这组不得封神?结果出来一看,像景区里凑数的cos活动合影:人挤人,光乱飞,主角杵在中间毫无存在感。二十张卡,成图两张,还是勉强能看的那种。
复盘的办法笨但有用:把元素逐个删掉重抽。删掉士兵,画面喘过气了;删掉烟花,逆光终于显形;删到只剩人物、逆光和一条光带时,那张图成了整组唯一能当封面的。无敌感是减法做出来的,跟熬汤一个道理——料越多,越喝不出主料的味。
回过头看,ai绘画无敌感的公式不复杂:低机位负责"大",逆光负责"神秘",减法负责"稳"。机位错了,再多的光也救不回来;光散了,再低的机位也白蹲。下次抽卡前,先把提示词里的特效词数一遍——超过两个,砍到一条再抽。这一步不花一分钱,能省下大半废卡。
常见问题
完全不会画画,能靠这套思路出图吗?
能,这套东西本来就是给不拿画笔的人准备的。你只需要管三件事:机位词放哪、光词放哪个位置、特效词留几个。画工为零反而有优势,不会被"手痒再加点东西"的冲动绑架。
横图和竖图,哪个更适合无敌气场?
竖图。人物占画面高度七成以上才有顶天立地的感觉,横图里同样的占比会显得矮一截。横图适合表现场面,竖图适合表现人——无敌感归根结底是关于人的。
气场特效用中文提示词,效果会差吗?
主流模型对中文词的理解已经够用,"逆光""剪影""轮廓光"都能正常执行。真要抠细节,英文词的粒度还是细一些,比如 rim light 和 backlight 打出来的光位置不一样,中文容易混成一个意思。
仰视角出图脚总崩,除了裁切还有什么办法?
给脚一个简单明确的描述,比如黑色军靴,模型有具体参照就不容易乱编。还不行就降低仰视强度,从 worm's eye view 退回 from below,稳定性会回来不少。