ai多人绘画老是脸融手多?30张废图试出来的分区构图路子
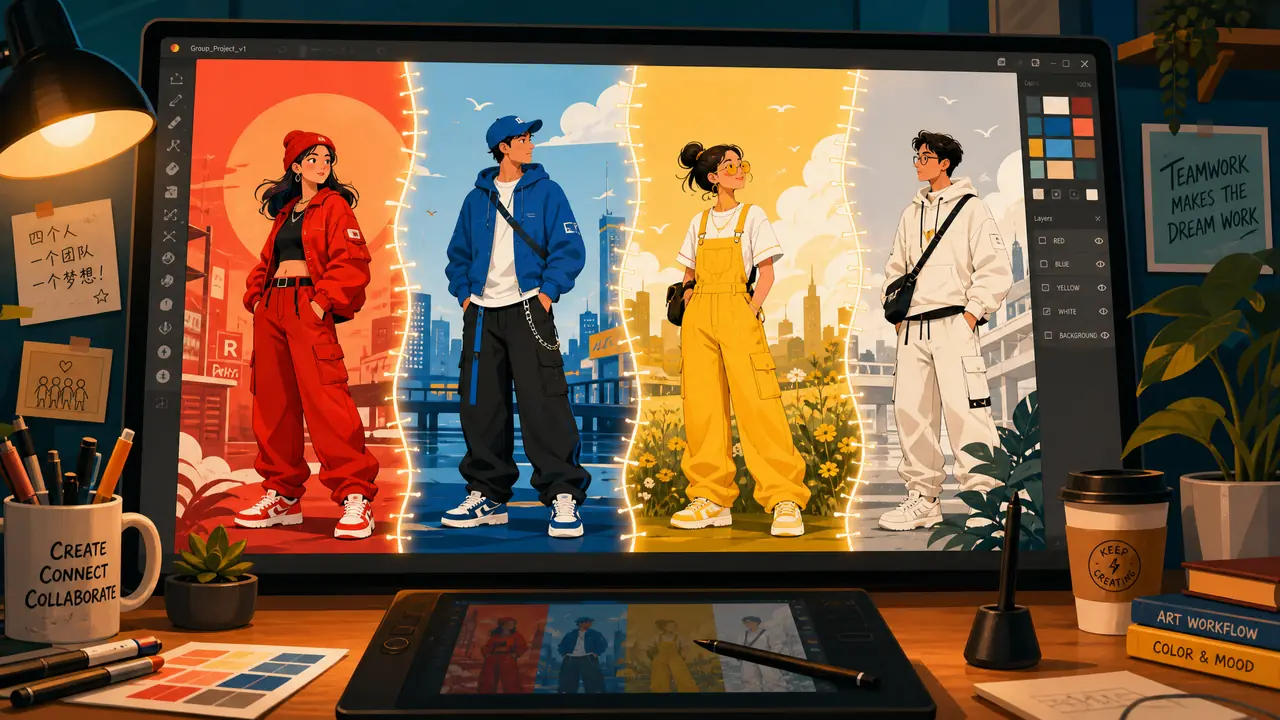
开门见山:ai多人绘画想出能看的图,靠的不是堆提示词,而是把人数、脸、手拆开各管一段。多人场景的翻车点差不多是单人图的三倍,模型自己根本顾不过来。你先要做的只有一件事:把每个人的描述拆成独立短句,人数单独加权。
用ai多人绘画最挫败的一幕:提示词里明明白白写三个人,出来五个人,其中俩还共用一张脸。我的第一张能看的多人图,是第31次跑出来的。之前那30张,全在删除键里安息了。摔过鼠标没有?摔过。
后来我不再迷信一句长提示词定天下,把流程拆成四步:先管人数,再管脸,然后管手,最后收拾人物交叠的边界。成功率从不到一成爬到六七成。这套办法不聪明,笨得很,但每次都能落到结果上。
为什么提示词写三个人,出来的是五个人
模型基本不会数数,它按训练数据里多人场景的统计规律自行补人,所以人数必须单独加权,再配合分区描述去硬性约束。不信可以把同一句提示词批量跑一遍试试,我试过了,数字很难看。
我做过一组小实验。同一句 a group of three people, standing in a park,连跑20张:3人及以下的只有2张;4到5人的13张;剩下5张干脆人叠人,数都数不清。模型数数的样子,像醉汉数酒瓶,数到一半就凭感觉报数。
改法有两个。第一个,把数词加权,比如 (three people:1.4),人数命中率立刻好看一些,但还不是百分百。第二个更好使:别写抽象的数词,写具象的身份组合。a man and a woman 就比 two people 稳得多,a father, a mother and their kid 也比 a family of three 靠谱。具象身份词在训练数据里成对出现得多,模型见惯了。
所以多人图的第一原则:人数这关别赌运气。每加一个人,翻车概率往上翻一截,两个人是及格线内的游戏,三个人就得开始动脑子了。
两张脸融成一张,怎么拆才有效
脸融的根源是两个人的描述在提示词里挨得太近、属性互相渗透,拆法是每人独立短句,再用服装颜色当锚点,最后局部重绘单独修脸。亲测这能把串脸率从六成压到两成出头。
先说原因。你写 a man in a red jacket and a woman in a blue dress talking,模型的注意力会把 red、blue 这些属性搅在一起分摊,分着分着就串了味。像两个人合租共用一个衣柜,穿到最后谁也说不清哪件是谁的。
我自己对比过:把人物描述写成两个独立短句、每人前面单独挂服装颜色锚点,前后各跑20张,脸串味的从12张降到5张。颜色是属性里最亮眼的标签,模型认颜色比认性别还准。发型偶尔也串,红头发染到旁边人头上,重抽就是了。
锚点救不回来的脸,交给局部重绘。蒙版只框五官,重绘幅度压在0.4左右——低于0.3基本纹丝不动,高于0.5就容易给我换个人,修完左边脸是A右边脸是B,更糟。修一次不满意就修第二次,别贪一步到位。深色衣服的人还容易跟背景黏在一起糊掉,这块的提亮门道我写在另一篇里:黑袍人物提亮的实测笔记,两件事经常一起发作。
还有个小经验:写站位关系用最土的词。facing each other、side by side、one behind the other,比那些花哨的构图术语管用。模型听得懂大白话,听不懂摄影杂志。
四种多人出图路子,我各跑了20张的账本
四人以内直出加修复最省时间,四人以上别硬抽,换分区提示词或姿态骨架,把位置一次钉死比反复抽卡划算得多。下面是同一个场景跑下来的实账。
测试场景固定为咖啡馆四人合影,人物数量对、脸不融、手不崩,三条全占才算可用。单张耗时按本地30系显卡测的秒数,供参考。
| 路子 | 适合人数 | 20张可用数 | 单张耗时 | 主要翻车点 |
|---|---|---|---|---|
| 纯提示词直出 | 1-2人 | 3张 | 8秒左右 | 人数失控、脸融 |
| 加权加服装锚点 | 2-3人 | 9张 | 8秒左右 | 手指看运气 |
| 分区提示词逐人格子 | 3-4人 | 13张 | 25秒上下 | 格子接缝处色差 |
| 姿态骨架控制 | 2-6人 | 14张 | 30秒上下 | 姿势偏僵、肢体穿模 |
账很清楚:三人以下我直接直出抽卡,反正一张才8秒,删着删着总能中。四人合影必上骨架,硬抽是把时间往火里扔。骨架也有坑——骨架里肩膀角度画太开,出图的人胳膊肘全往外拐;膝盖画成直角,人就端坐在空气上。骨架要照着真人坐姿描,别自创。
分区格子适合合影这种各站一块的排布,边界接缝处偶尔有色差,后期拉一下曲线就平了。对话场景就别分格了,两个人面对面还得互动,格子会把他们的视线锁死。
手和交叠边界,留到收尾再清场
多人图的手和人物交叠处别在构图阶段死磕,先把人数和脸定住,收尾阶段用低幅度局部重绘一轮一轮清。顺序反了,你会把前面修好的脸一起改崩。
挽手、递东西、勾肩搭背,是手部崩坏的重灾区。我统计过自己那批废图,多人互动姿势里手正常的不到四分之一,五根手指长成七根的次数多得我都不惊讶了。有一回我盯着一只手看了半分钟才认出不对劲,人对畸形手的容忍度比想象中高——这挺可怕的,拉回正题。
对策分两档。远景的手,模糊就模糊,别修,观众根本不看。近景特写的手,单独生成一只握杯子的手再合成,比在整图里反复重绘快得多。两个人肩膀前后关系错乱的时候,别玩花活,老老实实加 in front of、behind 这种方位词,然后局部重绘,幅度0.35上下,只框交叠那一小条。
一轮修不好就两轮。每一轮蒙框小一点、幅度低一点,慢慢蹭。贪一枪大改,多半是前功尽弃。
回头看开头那张三人群像,它最后能成片,靠的不是哪句玄学咒语,就是三板斧轮着来:人数加权、服装锚点、低幅度修脸修手。笨,但稳。你下一张多人图,先把每个人的描述拆成独立短句试试——光这一步,就能让你少删一半废图。
常见问题
两个人牵手的画面,为什么总出四只手叠在一起?
交互动作会把手部崩坏率拉到最高,两只手在接触点搅成一团。远景可以糊弄过去,近景建议把手单独生成再合成,或者干脆换成并肩站的姿势。别跟模型在牵手这事上较劲,不值得。
能指定每个人的服装颜色和发型吗?
能,颜色是最稳的锚点,直接写在每个人的独立短句开头。发型词偶尔串,一个金发能传染给全场,那就把发色也加权,或者重抽。越靠前的词越优先,这是提示词的基本脾气。
为什么加了 crowd 这个词,人反而变少了?
crowd 触发的是远景人海模板:镜头拉远,单个人形缩成一团模糊。想要清晰的少数几个人,用具体身份词加数量加权,别用 crowd、crowded 这类词,它们管的是另一类画面。
多人图要不要一上来就开高分辨率?
不建议。先小尺寸把构图和人数跑对,再放大或做高清修复。直接大图抽卡,废一张心疼一张,时间还翻倍。构图没定就开大图,等于装修还没画图纸先买了大理石。