AI幻术AI绘画实测:视错觉画面为什么看着对却经不起看
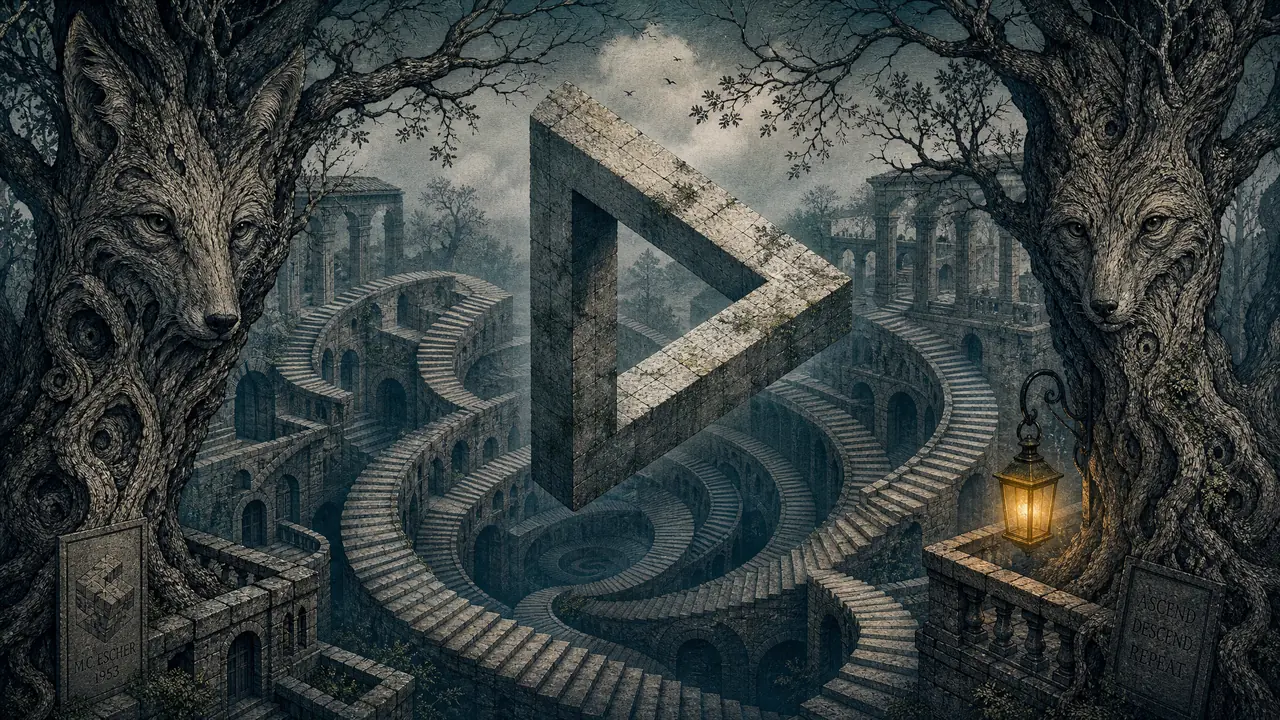
视错觉是AI绘画里最拧巴的题材:模型擅长把每块画对,错觉偏偏要求整体画错。我的实测是二十张里出三张能细看的。这篇讲四类错觉玩法的真实成功率、几个提高命中的土办法,以及发布时的分寸。
AI幻术AI绘画这个方向,我是被一张无限循环楼梯的图勾进来的。那图第一眼震撼,我把手机倒过来看——楼梯的透视对不上,踏步数目也数不通。当时不服气:这有啥难的?自己上手才知道,让AI画出「结构上真的不可能」的图,比画一百张美女难。这篇全是我这一个月错觉题材的实测账,包括那些数不通的踏步。
四类错觉玩法,翻车姿势各不同
视错觉图常见四类:不可能几何、图底双关、隐藏图案、矛盾建筑,AI对它们的驾驭难度依次升高。越依赖精确几何逻辑的,出图越看运气。
| 类型 | 典型画面 | 我的实测命中率 | 常见翻车 |
|---|---|---|---|
| 不可能几何 | 彭罗斯三角、无限阶梯 | 二十张出三张 | 近看每段都对,接缝处露馅 |
| 图底双关 | 正负形互藏,瓶人与脸 | 五张出两张 | 两形都含糊,谁也不像 |
| 隐藏图案 | 树丛里藏人脸、云里藏兽 | 十张出六七张 | 藏得太满,喧宾夺主 |
| 矛盾建筑 | 埃舍尔式错位空间 | 纯文字几乎为零 | 透视在第二层楼就崩 |
命中率最高的是隐藏图案,也是最适合新手起步的一类。它不要求几何严谨,只要求「藏」的分寸——这个分寸恰好是提示词能控制的,后面细说。
AI为什么画不出「真」的不可能
模型学的是大量「看起来合理」的图,拼出来的是局部合理的缝合;错觉要的恰是局部矛盾的全局自洽,两件事拧着。所以错觉图得靠人守结构,别指望模型替你守。
我拆过自己出的那十七张废彭罗斯三角,废法就两种。一种是「三根梁各自成立,交界处各画各的」,远看是三角形,凑近看三段梁根本没接上;另一种更气人——它给你画了个能成立的三角棱环,结构完全合法,那就不是错觉了,是普通几何体。你瞧,模型要么太守规矩,要么不够守规矩,就是到不了「表面守规矩、内核违规」那个微妙位置。
后来命中率提上来的办法土得很:借实物起手。我拍了一组乐高搭的彭罗斯三角——实物的错觉感靠拍摄角度硬凑,照片本身就带着「正确的接缝」。拿这照片垫图去生成,模型只需要在这个视角上做风格化,不用自己发明结构。二十张里能细看的从三张涨到九张。土办法,管用。
顺带一提,垫图照片的光线尽量选阴天或柔光。我第一回拍挑了正午,硬阴影把接缝的真实结构暴露得太清楚,模型把影子也一并学了去,生成的图错觉感反而更假。换阴天重拍,一次过。
矛盾建筑那类同理,纯文字几乎出不来,我最后是找了一组真实螺旋楼梯的照片垫图,再让AI在两层楼之间「加一层不存在的回廊」,出来的错位感至少撑住了画面内的一致。撑不到数踏步的程度,但社媒上够用了。
藏脸图的分寸,全在浓淡之间
隐藏图案的诀窍是控制「寻找成本」:三秒能看出的太直白,十秒找不到就没人找了。描述藏在哪、用什么材质藏,比描述藏什么管用。
我做过一张秋日树丛藏狐狸脸的图,第一版把狐狸的五官描述得太具体,出来的是树上浮着一张透明狐狸脸,恐怖片预警。改法是只写「树皮的纹理走向恰好构成狐狸侧影,不留独立五官」,让纹理去干这个活。第二版朋友花了五秒找出来,评价是「有点意思」。第三版我压到七秒——自测下来五到八秒是我这边的甜蜜区,因人而异,你自己拿人试。
分寸之外还有一条底线:错觉图别拿去当「实拍」唬人。尤其是长得像真实场景的矛盾空间图,发布时按平台要求标注AI生成,别搞那种「实拍惊现」的话术。图可以骗眼睛,发布者不能骗人。
一个月玩下来,我对错觉题材的感受是:AI把门槛从「画功」挪到了「结构判断」。模型负责把画面织得漂亮,哪里的接缝是假的、哪里的透视在撒谎,得你自己盯。那张最后改出来的彭罗斯三角,我印了张明信片寄给朋友——印刷厂出来颜色偏灰,错觉感弱了一半,你看,这题材连印个实体都得重新校一遍。
常见问题
为什么提示词里写埃舍尔效果几乎出不来?
因为矛盾空间需要跨区域的透视一致,模型逐块生成接不成整体。垫实物照片再局部改造,是目前最靠谱的路。
视错觉图可以商用吗?
错觉原理本身不受保护,但临摹某幅具体作品的结构和构图就有风险。做原创场景的错觉,别复刻名作的布局。
隐藏人脸图怎么让朋友更容易发现?
反向操作:把背景纹理的对比度调高一点、藏匿区域离画面中心近一点。每改一版就找没看过的人计时测,别用自己的眼睛测,你已经知道答案了。
错觉图上的细节印刷后变糊怎么办?
错觉靠细小结构撑着,网图分辨率直接印刷必丢细节。交印前把关键接缝区域放大检查,必要时手动重描。