ai虚拟绘画给虚拟主播做立绘:人设一致性锁不住?先出静帧再进Live2D
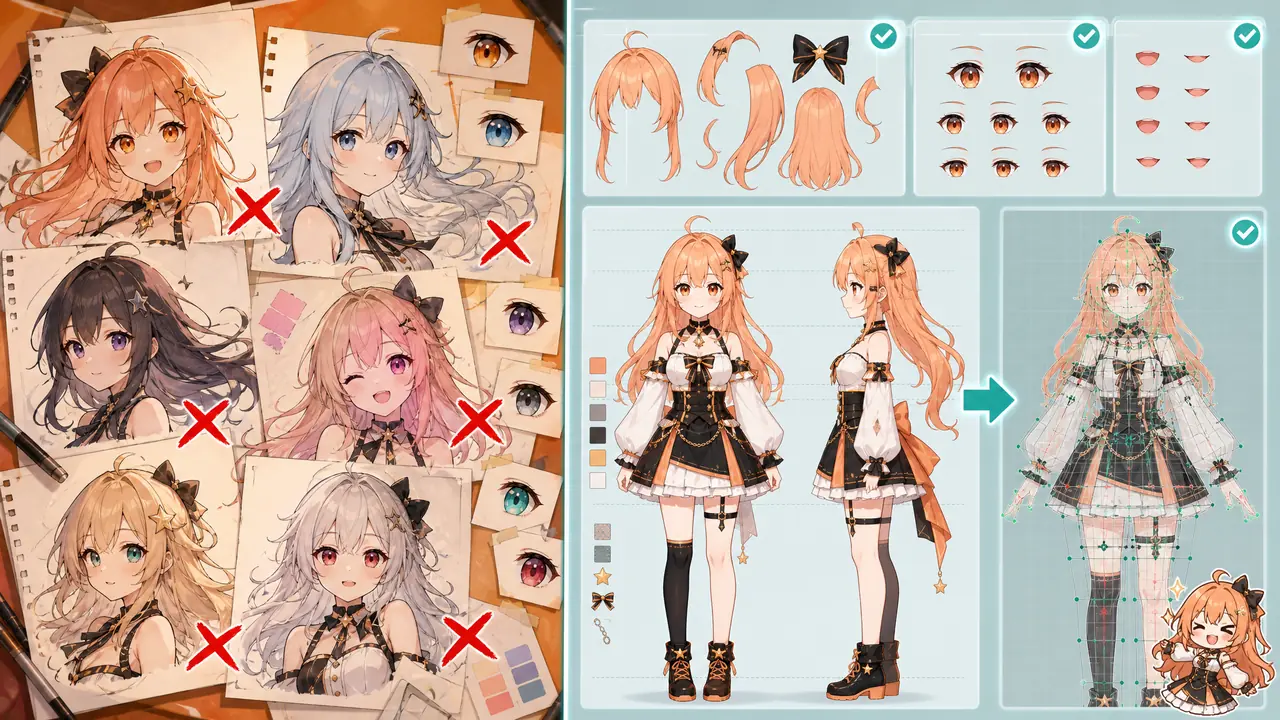
我有话在先:ai虚拟绘画能出虚拟主播立绘,但直接奔着"会动"去基本是白跑。人设一致性锁不住,后面 Live2D 全盘返工,正确顺序是先把静帧和三视图钉死,再谈拆件动起来。这篇给你一套能照抄的流程,附几个实测数字。
用 ai虚拟绘画给虚拟主播做立绘,我的结论先放这儿:静帧先行,动图后置。直接生成会动的形象,出来的东西既不能拆件,也没法进 Live2D,等于白烧显卡。
为什么这么笃定?上个月帮朋友做一个新皮套,图省事用图生视频出了段会眨眼的动画,看着挺唬人。结果 Live2D 那边的师傅打开就摇头:头发和身体糊在一起,眼睛没有分层,侧面那张跟正面的瞳色完全对不上。全部推倒重来。那一晚我重新跑了三十多张图才明白,顺序错了,后面全是徒劳。
先出静帧,是 Live2D 素材的硬门槛
Live2D 拆件吃的是分层清晰的静帧,抖动、表情、口型全建立在稳定轮廓上,动图素材反而一件都拆不出来。这是很多人第一次做皮套时踩的第一个坑,先把这个门槛看清楚。
Live2D 的原理说白了是给平面做"伪 3D":把立绘拆成前发、后发、眉毛、眼睛、嘴、身体这些图层,再给每个图层绑变形器。拆件的前提是每层边缘干净、颜色区隔明确。ai 生成的动图恰恰相反,每一帧都在重新计算,连头发丝的位置都对不上前后帧,根本无从拆起。
我的固定流程是四步:先出一张定稿全身像,接着补正面、侧面、背面三视图,然后做表情差分,最后才交给 Live2D 侧拆件。按这个顺序走,师傅那边基本不用返工。
定稿那一步最费图。我试了下同一套提示词裸跑 12 张,发型和瞳色能对上的只有 5 张,四成出头的命中率。后来加了一张自己拼的粗糙草稿当垫图,权重给到 0.55,再跑 10 张,8 张稳定。差距就是这么直接。
人设一致性靠什么锁:模板、垫图与训练的取舍
一致性三件套按性价比排序是固定提示词模板、参考图垫图、角色 LoRA 训练,小成本项目用前两个就够。每一档的成本和效果差得不少,选错档位会白白多烧几天时间。
提示词模板要写得像填表。发色别写"蓝色",写"深藏青色长发,发梢渐变浅青",越具体越稳。瞳色、瞳孔高光的位置、服装的层数和配饰,全部写死,每次出图只换动作和镜头。seed 也要固定,同一个 seed 配同一套词,画面骨架才不会漂。
垫图是我个人最推荐的一档。把定稿静帧丢进去当参考,权重从 0.4 开始试,每 0.05 一档往上加。实测 0.55 到 0.6 是甜点区:人设特征抓得住,姿势又不会被参考图焊死。超过 0.7 之后构图基本照抄参考图,想换个动作就难了。
上色风格上,虚拟主播立绘多是赛璐璐质感的平涂加双层阴影,出图前把风格词统一好,后面做差分才不会一套水光一套厚涂。日系平涂的调法有现成经验可搬,这篇韩日绘画ai怎么分开出味儿?水光肌与赛璐璐的调法差异里拆得比我细,可以先看再动手。
服装描述用分层写法也更容易稳:从内到外,衬衣、马甲、外套、配饰,一层一句,别挤在一句里。模型对"层次分明"的反应比对"华丽"好得多。
| 方案 | 前期成本 | 一致性表现 | 适合场景 |
|---|---|---|---|
| 纯提示词模板 | 半小时写模板 | 同模型同seed下约四成命中 | 试错期、定人设 |
| 垫图加权重 | 一张定稿加调参 | 八成上下稳定 | 日常出图、表情差分 |
| 角色LoRA训练 | 30张以上底图加数小时训练 | 九成以上,细节最稳 | 长期更新的皮套 |
训练 LoRA 听着一步到位,说实话对单人项目有点重。底图本身就要求一致性,等于先过前两关。个人建议皮套确定要长期做再上这个,临时项目别折腾。
三视图最常翻车的三处,和修法
侧面瞳色漂移、背面发型走样、服装纹样对不齐,是三视图出图的三大翻车点,逐项排查比整体重跑省图。每一处都有对应的低成本修法,先定位再动手。
翻车一:侧面瞳色漂移。正面定稿是金瞳,转侧面跑出来变成琥珀色甚至灰绿。修法是把瞳色写进提示词最前面的权重位,同时垫图权重加 0.05,一般两三张内能修回来。我有一回连跑 7 张侧面全是偏色,最后发现是风格词里混了"黄昏光",环境光把瞳色染了,删掉就正常。
翻车二:背面发型崩。ai 对后脑勺的理解普遍糊,低马尾画成散发、发饰凭空消失。我的做法是背面图单独跑,提示词里把发饰逐个点名,再垫正面定稿做参照,容忍度放宽一点,反正背面在 Live2D 里出场率低。
翻车三:服装纹样对不齐。正面裙摆三道金边,背面变两道,侧面错位。这种别指望模型自觉,出图后在修图软件里手对,或者干脆简化纹样。细节越少,一致性越好,这话不好听但管用。
交给 Live2D 前,静帧要过完这份自查
静帧交付前查四件事:图层能分层、线条闭合、色块纯色化、单张宽高够用,缺一项后面都要加倍补工。这份清单是拿返工换来的,逐条过一遍再交。
分辨率上,全身立绘建议长边 3000 像素起步,放大看线条边缘不能有明显的涂抹感。Live2D 的纹理有上限,拆件时会被切小,源头给大图才够裁。
表情差分不用贪多。基础配置是眨眼开合、口型三档、眉毛两档,再加两三个情绪脸,一共 8 到 10 张静帧就够开工。我第一次做时贪心出了二十多张差分,结果基础件还没拆明白,全闲置了。
拿别人的皮套形象来练手,个人欣赏自用没问题,商用授权另算,接单前把这点跟委托方说清楚,免得后面扯皮。
回到开头那晚的教训:ai虚拟绘画出虚拟主播立绘,拼的不是出图速度,是顺序。静帧钉死,三视图对齐,差分够用,再进 Live2D,返工率肉眼可见地降。下次起新皮套,把这份流程摆在前面,能省下不少通宵。
常见问题
静帧一定要手修吗,直接用ai原图行不行?
基础件建议手修。手指、发丝交叉处、眼睛高光,这几处 ai 经常画得含糊,Live2D 变形时会被放大。我一般只修交付件,小尺寸差分能不动就不动。
没有绘画基础,垫图用的定稿从哪来?
从 ai 出的图里挑一张最稳的,修掉明显瑕疵就能当垫图。垫图不要求完美,只要求特征全。我第一套皮套的垫图就是从废图堆里捞出来修了半小时的。
同一个角色想出不同服装怎么办?
锁脸不锁衣。垫图权重只压脸部和发型区域,服装描述整段替换,跑完再检查纹样逻辑是否自洽。换装是皮套更新的常规操作,流程熟了很快。
出图分辨率开多大合适,一步到位拉最高行吗?
别拉满。分辨率过高时构图反而容易崩,也废显存。我习惯 1024 出图再高清放大两倍,成图率比直接出 2048 高一截。
Live2D 拆件可以自学吗,还是必须外包?
可以自学,免费版软件就能练,拆一个简单头像大概两三周上手。但全职皮套的口型和大动作绑定有门槛,赶上线就外包,不赶就自己磨。