AI人工智能绘画解读:它怎么出图,争议又在哪
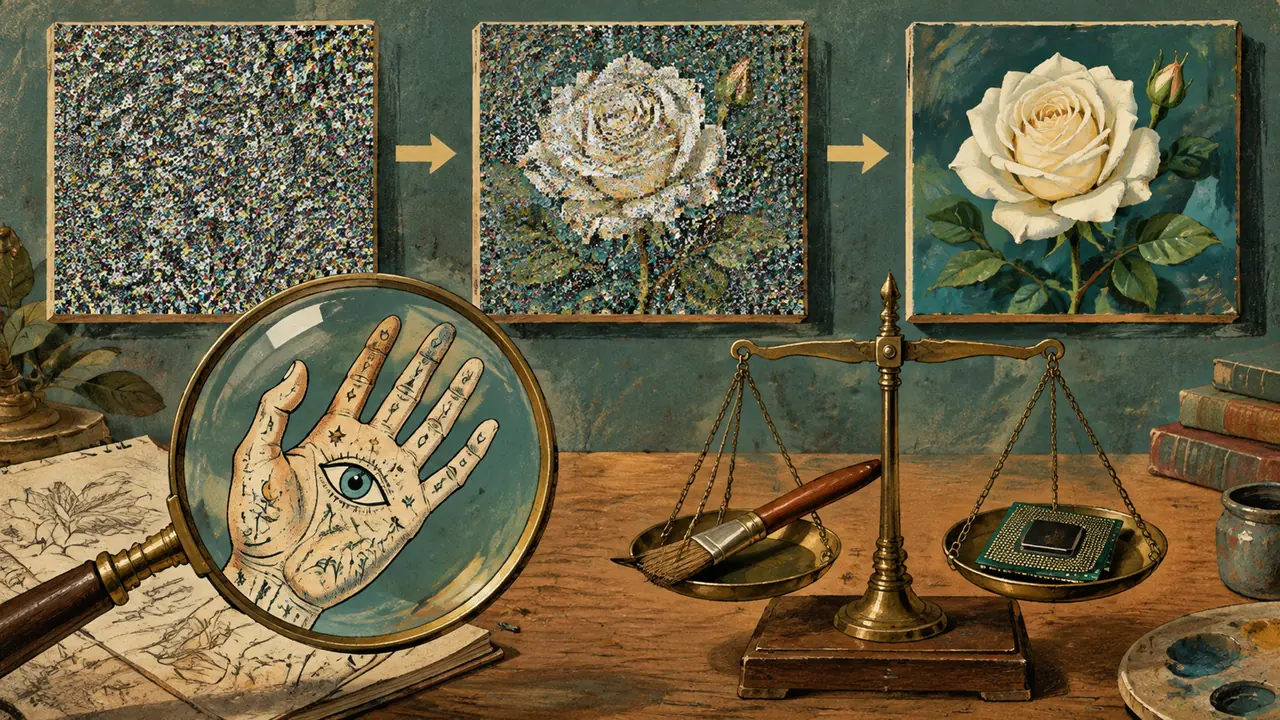
直接给结果:AI绘画是模型按统计规律猜像素,它并不理解你写的词,只是见过这些词和画面一起出现太多次。想通这一点,手会崩、字会乱、版权扯不清这些事,就都有了着落。
把AI绘画讲成「人工智能在创作」,是这行最成功的误会。它更像一个见过几百万张图的猜谜高手:你说白玫瑰,它不是想起玫瑰,是按经验把「白玫瑰最可能长什么样」的像素一层层猜出来。我用了大半年才真正接受这个设定,接受之后,出图率和心态都好了不少。理解这个底层机制,你对它的期望和用法都会准很多,这篇就把原理、错位和争议三件事说透。
出图三步:从一团噪点到一张画
扩散模型出图分三步:把你的话转成数字信号,从一团随机噪点出发,再按信号一步步去噪,画面就浮出来了。
整个过程像显影。模型先把你的提示词编码成一串数字,再拿一张纯噪点图当起点,每一步都往「更符合这串数字」的方向修一点,几十步下来,噪点褪掉,画面浮现。步数就是修的次数,我常用的28步,调低了画面糊,调高了多数时候白等。你每次抽卡得到的图不一样,因为起点的那团噪点每回都不同,这是机制决定的,不是你操作有问题。
这个机制还解释了另一件事:为什么改一个词,整张图都变了。信号是一体的,牵一发而动全身,你想只改背景留人物,靠抽卡碰运气效率极低,正经办法是局部重绘,把改动圈起来只修那一块。明白原理的人少走很多弯路,不明白的会一直以为是词没写对。
步数和采样这些参数也别神化。我拿同一组词做过对比:24步和36步的成品,肉眼挑得出差别的不到两成,多花的那两倍等待时间多数打了水漂。参数的意义在于稳定,不在玄学,找到一组稳定的配置就固定下来,把心思花在词上,回报率高得多。
手和文字为什么总出错
手崩和字乱,是因为这类目标的形态太不固定:手有一千种姿势,字母有几千种字体,统计规律在它们身上最不好使。
玫瑰只有一种长法,手却有一千种姿态,模型见过的手千姿百态,落到具体一张图上就爱多给一根手指。文字更惨,它得在几十个像素宽的格子里把笔画排对,错一个横都算崩。2026年上半年的几款新模型在字上进步不小,短句已经能写对,但长段文字我还是建议后期手动加,省得反复抽卡耗时间。
同理可推的还有镜像问题:文字会左右颠倒,纽扣会错位,乐器按弦的手型不对。凡是现实里要「精确对应」的东西,它都容易含糊。拍证件照、画产品说明图这类活儿,指望它一步到位不现实,它擅长的是氛围和创意,不是精确。我的分工原则是:讲情绪的交给它,讲准头的自己来。
还有一个反直觉的观察:写得太细反而容易崩。我有回把一条提示词堆到上百词,画面元素互相打架,人物挤在角落里。砍到三十词上下,每样东西才各归其位。统计规律这个东西,你给的信号越杂,它平均下来越平庸——少而准,比多而全有效。
争议真正卡在哪
版权争议卡在两头:训练数据有没有拿到授权,以及出图算不算借鉴了某个画师,这两件事目前都没有清楚答案。
训练数据的来源是第一笔账:模型学画用的是网上公开的图,作者们事前大多不知情,这层积怨是行业里最硬的那根刺。第二笔账在输出端,你写某个画师的名字,模型能给出近似风格,这算不算侵权,各国的判例还在拉扯,没有定论。平台的态度也不统一,有的禁止商用,有的要求标注AI生成,有的条款里直接分走你的权利。
我的做法朴素:商用之前,把当次所用平台的条款从头读一遍,重点看商用范围、署名要求和独占限制三处;条款里没写清楚的,就当没有这项权利,别赌。另外我会避开直接点名在世画师风格的写法,不是怕出事,是没必要——描述到位了,风格自然来,点名这条捷径省下的力气,抵不上惹来的麻烦。
争议之外说点实际的:作为用图的人,能做的是留痕。我每个项目都留一份生成记录,日期、工具、关键词、改动过程各一行,万一哪天授权被质疑,这份记录比记忆管用。规则没定型的阶段,自证清白的能力就是议价能力。
回到开头:它是猜图高手,不是创作者,也不是照相机。知道它的边界在哪,用起来就少了好多怨气——别指望它理解你微妙的心情,也别冤枉它「故意」画错手指,它只是在猜。想清楚你要的是效率还是表达,工具的位置自然就摆正了。
常见问题
AI绘画会完全取代画师吗?
短期看不到。批量素材被吃得最狠,定制表达、风格署名、现场协作这些环节人还占着位置。更可能的是「会用的人替代不会用的人」这种老剧本。
同一关键词每次出的图都不一样,版权算谁的?
一般谁生成谁持有使用权,但同一关键词加同一随机种子能复现近似结果,独占性别当真。要紧的商用项目,条款里写清楚归属最保险。
想入门需要学编程吗?
不需要。提示词和后期处理才是日常,编程只在想本地部署、折腾参数的时候才用得上,先把表达练好,工具的事往后放。