AI绘画帮我画图靠谱吗?我拿十句大白话喂了一整晚
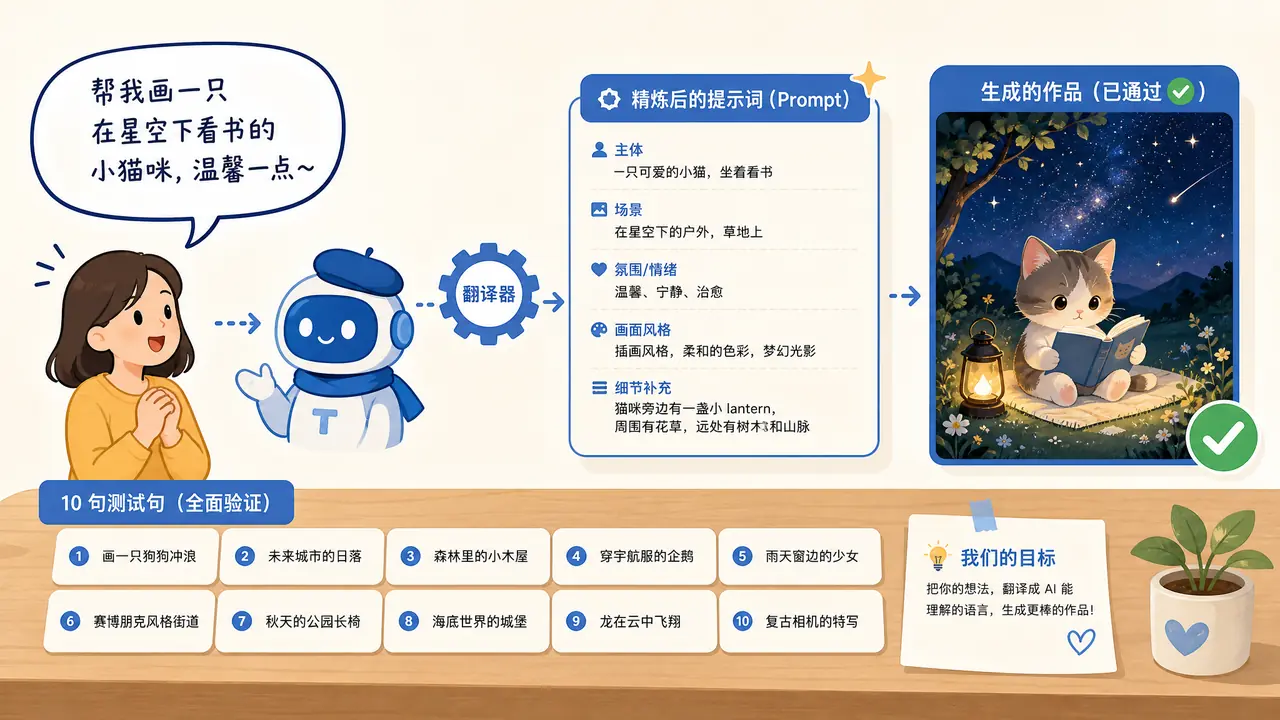
直接给结果:口语原句直接喂,十句里能成五句,成的全是画面具体的,歪的全是要私有信息或者要感觉的。文末那套三步改法,能把大白话拧成好提示词,你今晚就能照着跑通第一张。
昨晚十一点,我妈在家庭群里发来一句「AI绘画帮我画张全家福呗」,我盯着这行字乐了半天。普通人用AI画画,开口第一句根本不是什么提示词,就是一句求助。所以我干了件笨事:把身边人最常说的十句原话攒下来,一句不改,直接丢给两款主流工具,同一句话各跑五张,看它们到底接得住几句。测试从晚上九点跑到十二点,二十次抽奖,结果比我想的有意思,该成的成了,不该成的歪得千奇百怪。
十句原话直接喂,五句能看五句报废
口语原句直喂的成功率大概一半:画面具体的能成,要私有信息、要文字、要抽象感觉的必歪。十句的结局摊开讲,你就知道该说什么不该说什么了。
先说成的。「帮我画一只戴红围巾的橘猫蹲在阳台晒太阳」,第三张就能直接用,围巾、阳台、眯眼全对上了。「帮我画一个下雪天的菜市场,摊主在砍价」,出了六张挑出两张能看,雪落在菜筐上的质感比我想的好。还有一句「帮我画个机甲少女在便利店吃关东煮」,第一张就挺惊艳,热气都有。顺带一提,同一句话两款工具的表现不一样,A家的构图更规矩,B家的光影更足,挑图的时候各留了一张。
歪的就更有节目效果了。「帮我画我家的狗」,它根本不认识我家狗,出来一只金毛,可我姐家养的是柯基。「帮我画个logo」,出来一坨图形字,字母还拼错了俩。「帮我画一张读书节海报」,构图是有了,标题栏的位置空着一块,模型不敢碰字。「帮我画得可爱一点」这句最冤,可爱到什么程度全靠模型猜,十张里九张猜不中。说实话,看到柯基那张我笑出了声,这不赖模型,赖需求里压根没给信息。
口语转提示词,我只做三个动作
改法就三步:删掉「帮我」,把形容词换成看得见的东西,再把画面拆成主体、场景、光线三块。三个动作比背一百个教程词都顶用,改动花不了一分钟。
口语像在饭馆里喊「随便来点好吃的」,提示词是直接报菜名。第一步删「帮我」,那是人和人之间的客套,对出图没半点用。第二步,把「可爱」「高级」「有意境」这类词翻译成看得见的细节:可爱就是圆脸大头短手短腿,高级就是低饱和配色加留白,有意境可以是雾、是空椅子、是没关的灯,别让模型替你做阅读理解。第三步按「谁在干什么、在哪、什么光」排一遍,比如「圆脸橘猫,坐着舔爪子,午后阳台,暖光,浅色背景」。
我拿同一批口语前后对比过,只做这三个动作,能看的图从三成上下爬到八成。岔开说一句,我妈那句全家福我也照方抓药,拆成四个人物加客厅场景加落地窗光线,出来一张全家都在笑的,脸不像,她倒挺满意,转头就设成了群头像。我姐看完把改法清单也要走了一份,说回头把她家柯基也安排上,垫图的事交给我。
这三类请求,趁早别原样喂
要私有信息、要文字图形、要精确构图的请求别硬喂,换路子走:垫图、后期加字,或者局部重绘。硬喂只会浪费抽奖次数。
画自家宠物、画真人朋友,先垫一张照片,文字只负责补风格,这一步能救回九成的「帮我画我家狗」。要logo、要带字的图,让AI出构图草稿,字留到设计软件里打,模型到现在也写不利索汉字。想把某人P进场景,老实用局部重绘,一次不行就两次。我上周把同事的头像P进了一场音乐节的图里,第一遍脖子是歪的,第二遍就顺了,前后五分钟。
这跟你去裁缝店一个道理,不能空着手说「照我衣柜那件做一件」,布料总得自己带过去,工具才有的放矢。
回头看我妈那句「AI绘画帮我画张全家福呗」,其实是句挺好的需求,只是说得太省。工具接得住具体画面,接不住没说出口的细节,中间差的那几句,得我们自己补上。下次开口前,先把「谁、在哪、什么光」在心里过一遍,再按三步拧一下,你的第一张图大概率就能成。
常见问题
同一句口语,为什么两次出图差很多?
出图带随机性,同一段提示词每次都是重新抽奖。想稳一点,就固定种子再微调别的参数,或者一次出四张,挑最接近的那张继续重绘。
口语里加「高清」「8K」这类词有用吗?
用处很有限,清晰度主要由出图尺寸和采样步数决定。与其堆画质词,不如把分辨率调上去、多走几步采样,效果来得直接。
中文口语和英文提示词差很多吗?
主流模型理解中文都没问题,日常表达够用。个别偏门风格词用英文写命中更准,拿不准就中英各跑一次,对比着挑。