斗罗宁荣荣AI绘画怎么出图?关键词细节与翻车实录
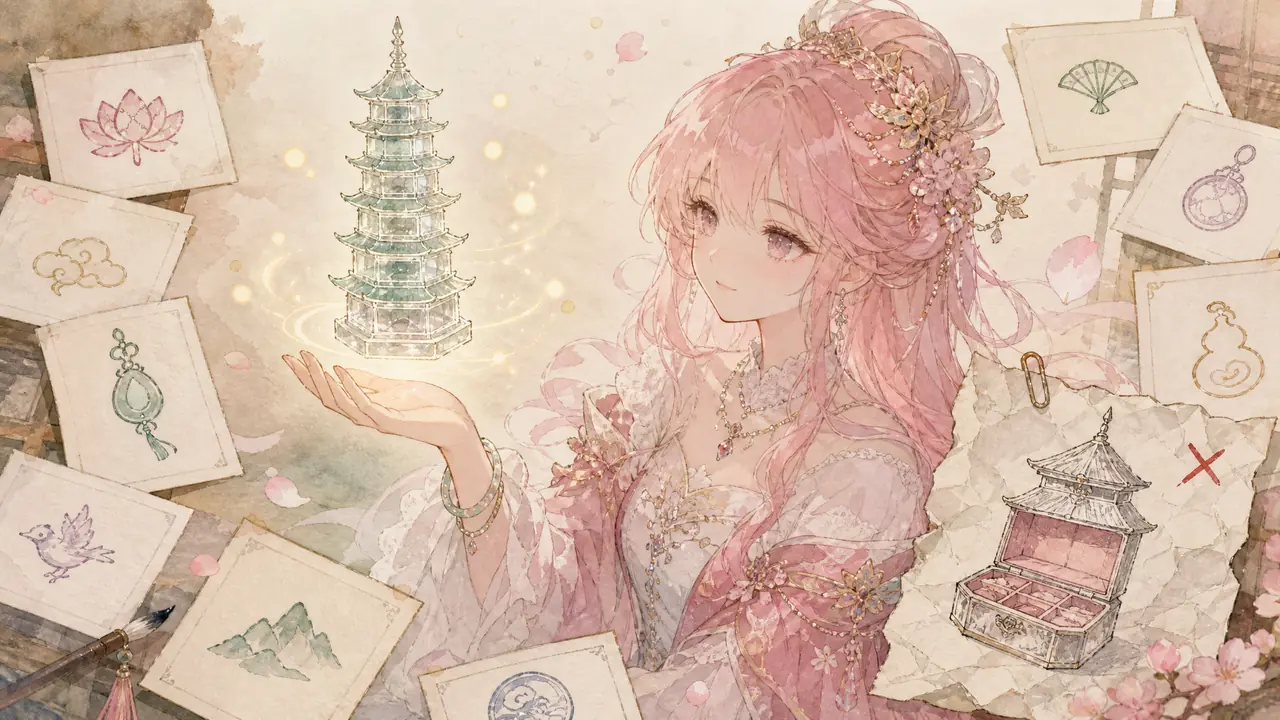
先泼盆冷水:把"斗罗宁荣荣"五个字直接丢进AI绘画工具,十张里八张是路人粉发少女,剩下两张武魂塔长得像首饰盒。想让宁荣荣像宁荣荣,关键词得拆碎了喂,脸、塔、脾气一样都不能省。
斗罗宁荣荣AI绘画的搜索热度一直不低,点进来的人多半想要一张能一眼认出她的同人图:粉发、裙装、掌心托着一座发光的宝塔。我的经验是,这类国产动漫角色出图,靠角色名碰运气,真不如老老实实做关键词拆解,两种跑法的命中率差得不是一星半点。
角色名不是万能钥匙
只写角色名,模型给的多数是个泛泛的粉发少女;身份、外貌、标志物拆成关键词分开写,像不像立刻分出高下。这不是玄学,是模型对训练数据里同人图数量的直接反应。
今年5月我做过一组对比:只写"斗罗大陆宁荣荣"加"高清",连跑四十张,能认出她的不到五张;换成拆解后的关键词组,二十张里挑得出七八张能用的。差距就出在模型对角色名的记忆上。训练数据里同人图多不多、画风杂不杂,决定它记不记得这位七宝琉璃宗的大小姐。宁荣荣不算顶流角色,吃亏很正常。
我现在的拆法固定成四块:身份写"贵族出身的大小姐",外貌写"浅粉长发、眉眼带点傲气",服饰写"华丽的短裙礼服、精致的肩部装饰",标志物写"掌心上方悬浮的琉璃宝塔、流转的金色光点"。四块拼齐,出图的人形才往"她"那边靠。缺哪块,模型就拿大众脸补哪块。
这四块词我存在备忘录里当模板用,6月给朋友出图直接套,第一轮八张就出了两张能认的。朋友惊讶,其实没啥诀窍,就是别偷懒省词。模板还方便微调:想换场景,只动场景那一块,其他三块原封不动,变量少,翻车也好排查是哪块词出了问题。
七宝琉璃塔是灵魂,也是难点
武魂塔最容易画崩,别指望模型自己懂,层数、材质、悬浮位置都得写进关键词,少一项它就自由发挥。
它翻车的花样比人脸还多。我见过出成红木佛塔的,见过出成带锁珠宝箱的,最离谱的一次,直接让宁荣荣背了个琉璃花瓶。后来我把塔的描述固定下来:"悬浮于少女掌心上方的七层琉璃宝塔,通体半透明,内部有光点流转,环绕柔和金光"。层数写明七层,材质写半透明,位置写掌心上方,这三项缺一项,出来的东西就从宝塔滑向摆件。
还有个坑是塔喧宾夺主。有一批图宝塔占了半个画面,人物倒成了陪衬,看着像建筑宣传图。补一句"人物占画面主体,宝塔小巧悬浮"就好多了。比例这种事,人一眼能看懂,模型不提醒就装糊涂。
负面词我也试出来一条:写"模糊、多余的建筑、佛像"能压掉大半跑偏的塔。说实话佛像那条是被我逼出来的——那阵子出来十张有四张偏宗教风,加上负面词之后基本绝迹。负面词不占地儿,白给的保险,能配则配。
三次翻车换来的那版成品
表情写不进关键词就用动作去带,单手叉腰加托塔的姿势,比一句"微笑"管用得多。
头一次翻车是脸。出来个温温柔柔的大家闺秀,完全没那股小魔女劲儿。第二次是塔,前文说的珠宝箱事件。第三次最冤:塔和脸都对了,右手五根手指并成一片鸭蹼。三次下来我学乖了,表情这种东西直接写"傲娇""得意"经常无效,换成动作描述——"单手叉腰,另一手托塔,下巴微抬"——出来的人一下子就活了。
鸭蹼手那次另有个笨办法,后来一直用着:关键词末尾加"完整的手部,五指自然分开",手崩的频率肉眼可见地降下来。但十张里还是能漏一张,AI画手这事没有根治的说法,只能生成时多留个心眼,选图前先把手指放大看一遍,省得发出去被人截图。
现在的固定流程是一组跑八张,挑一两张顺眼的再细调参数重来。五十张过去还挑不出的,多半是关键词方向错了,回头改词比硬跑划算。挑图的时间其实不比生成短,同人出图一半功夫在选。有一晚我为了赶社团约稿,从十一点跑到凌晨一点,最后挑中的那张反而是第一组里的,回头想想后面那几轮纯属自己不甘心。话说回来,这份耐心挑出来的图,拿去社区里也确实更压得住场。
回到开头那句:宁荣荣不像宁荣荣,问题多半不在工具而在喂法。角色名只是入口,特征拆解才是钥匙,塔和表情这两关过了,剩下的交给筛选的耐心。我最后留下的那三张图,就是这么一轮一轮磨出来的。
常见问题
斗罗宁荣荣AI绘画用什么工具比较像?
支持中文关键词的绘画工具都可以试,差别主要在对动漫同人语料的熟悉程度。别光听推荐,自己用同一组关键词各跑八张,高下立判。
生成的宁荣荣同人图能发社交平台吗?
发图注意标明"AI生成",内容标"同人创作",别拿去做商品售卖。角色版权在原作方,各平台的发布规范也看一眼,规则都写在明面上。
为什么出图总把宁荣荣画成小孩?
模型对年龄的理解容易往低走。关键词里补"十六七岁少女、身形修长"这类明确描述,或者把人物外貌词放到句首加重,年纪感会回来一些。
一次生成多少张才够挑?
我的习惯是八张一组,两三轮就有能用的。要是二十张过去毫无方向感,问题在关键词不在次数,改词再跑比无限重roll省事。