ai绘画评测怎么评才不水?三个维度加同词对比实测
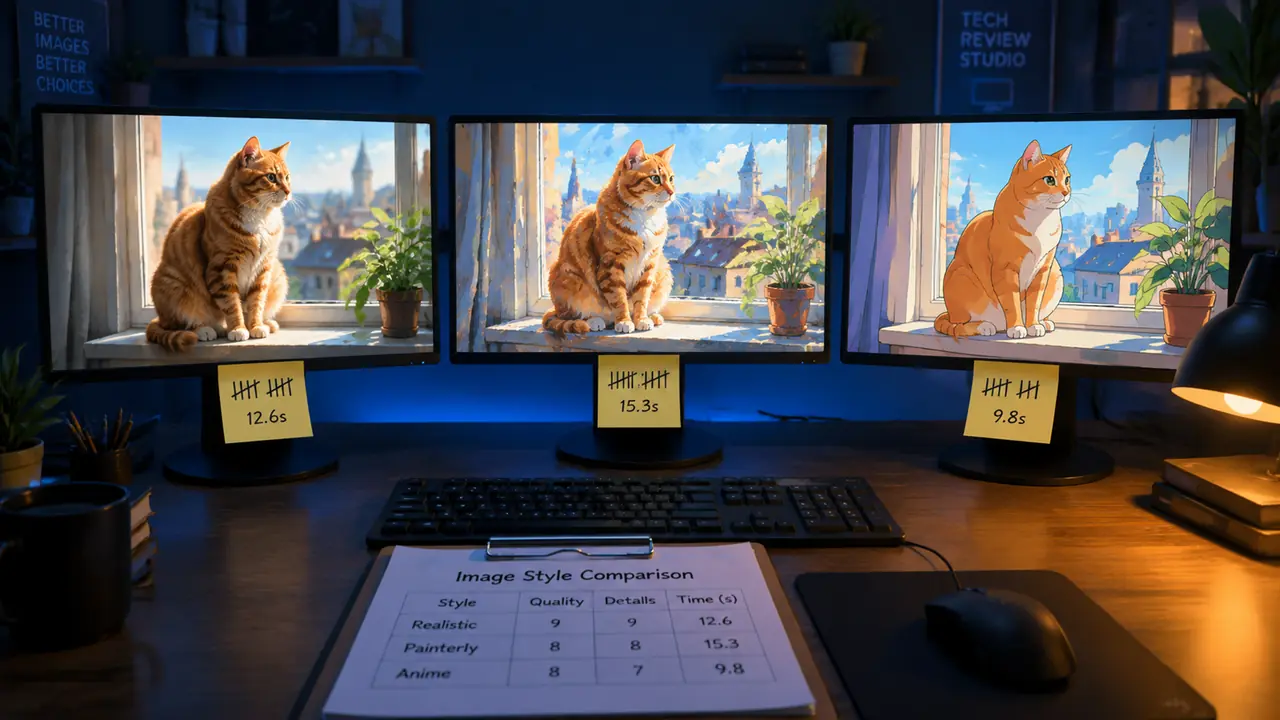
结论放在最前面:ai绘画评测的可信度,取决于变量控制。同一组提示词、同一批随机数、同样的张数,跑出来的对比才算数;换了词再比,评的全是提示词不是工具。我写评测帖半年,三个维度加一套笨办法,都在这篇里。
我是个写了半年AI绘画评测帖的业余玩家,起步的原因很俗——挑工具挑花眼了。评测看了二三十篇,A说甲好B说乙好,说得都言之凿凿,可对照着用发现根本不是那么回事。后来自己上手评,才明白大多数评测的水从哪来:变量没控制住。ai绘画评测这件事,方法比立场重要,这篇我把自己的笨办法全亮出来,你可以直接拿去验任何一篇评测,包括我这篇。
我评图只看三个维度
三个维度:出图质量看美学上限,听话程度看提示词遵循率,细节稳定性看手部、文字这些易崩点的出错率。三个维度分开打,混在一起评等于没评。
出图质量最好理解,单张图漂不漂亮,但注意评的是上限不是均值——十张里最好的一张能到什么水平,这决定你值不值得花时间养这个工具。听话程度是我最看重的一维,你写"雨天咖啡馆",它给不给你雨?给了雨又丢没丢咖啡馆?遵循率低于五成的工具,词写得再好也白搭。细节稳定性专盯易崩点:手指数量、盘子里的餐具、背景里的人脸,这些地方崩起来最伤图。
为什么拆开评?因为三个维度的冠军经常不是同一家。我测过的一组里,质量最高那家稳定性倒数,出的好图惊为天人,废片也惊为天人。混在一起打总分,这种信息全被抹掉了。评测帖里那种"综合评分8.9分"的写法,我个人觉得基本没有参考价值。
同一组词跑三家的实测账
固定做法:一组十五词以内的提示词,三家工具各跑二十张,记录可用张数、平均出图秒数和崩坏位置,全程不换词不加词。
上个月我做过一轮:提示词就写一只坐在窗台的橘猫、午后光线、插画风格,五个词,谁也别想靠词堆出便宜。二十张样本统计下来,甲工具可用十一张、平均九秒,崩点集中在猫的后腿;乙工具可用七张、平均十四秒,崩点在窗框透视;丙工具可用十三张但耗时最久,崩点最分散。三个工具三个性格,用的人自己掂量要什么。
统计方法很土,但土得有用:可用图的标准提前写死(主体完整、结构没崩、风格没漂),一张张过,过一张记一笔。别凭印象说"甲工具感觉更好",感觉这东西被单张神图一晃就偏了。我第一篇评测就犯过这毛病,把一张神图的印象算给了整组,发出去被评论区打脸,数据贴出来才翻的身。
还有个细节:随机数。有种子控制的工具,同一个种子跑两遍结果一致,这对对比测试是天大的好事;没有种子控制的,就老老实实加大样本量,二十张起步,少于这个数波动能盖过差异。
看别人的评测怎么避水分
三种水分要认得:官方送测图当实测、挑最好的一张代表整体、不同工具用不同提示词。中一条,这篇评测的可信度就要打折。
送测图最常见,图特别精致,边角还带着官方水印的痕迹,那是厂商给的图,不是工具吐的。挑样本也好认,满篇九宫格张张完美,可你上手就知道日常出图废片率摆在那,二十张里挑一张和二十张全贴,是两种评测。最难识别的是提示词不对称——给自家推的工具写二十个精心打磨的词,给别家丢一句随手写的话,数据看着漂亮,比的全是词。
识别的办法就一个:看它有没有交代方法。样本多少、词给没给、标准列没列,交代得越具体的越可信,一句方法都不提直接甩结论的,当广告看。我这半年学到的最大的事是:评测的价值不在结论,在方法公开——方法对,你自己跑一遍也能验证;方法藏起来,说破天也只是主张。
写评测之前,我是那个被评测忽悠的人;写评测之后,我成了被自己第一篇打脸的人。ai绘画评测没有捷径,二十张样本、一张表、几个崩坏点统计,笨功夫做足,结论自己会长出来。下回你再看到"某某工具吊打全场",先问一句:样本几张,词给了吗。笨功夫,反而是最快的路。
常见问题
免费工具和付费的差距实测有多大?
同词对比下,差距主要在稳定性和上限,均值反而接近。免费工具能出好图但废片率高,付费买的是省去的筛选时间,这个账要算自己的时薪。
评测帖里的分数能信吗?
综合分基本别信,维度分看它怎么打出来的。有样本量、有标准的维度分可以参考,凭感觉打的分数跟星座运势一个精度。
新工具刚上市,要不要马上跟风?
等两到三周再看评测,让别人的样本先跑完。上市第一周的宣传图全是精修过的,这时跟风入的坑我踩过一回,会员费交了才出坑。