AI绘画和AI声音怎么搭?一条配音短视频的流水线实测
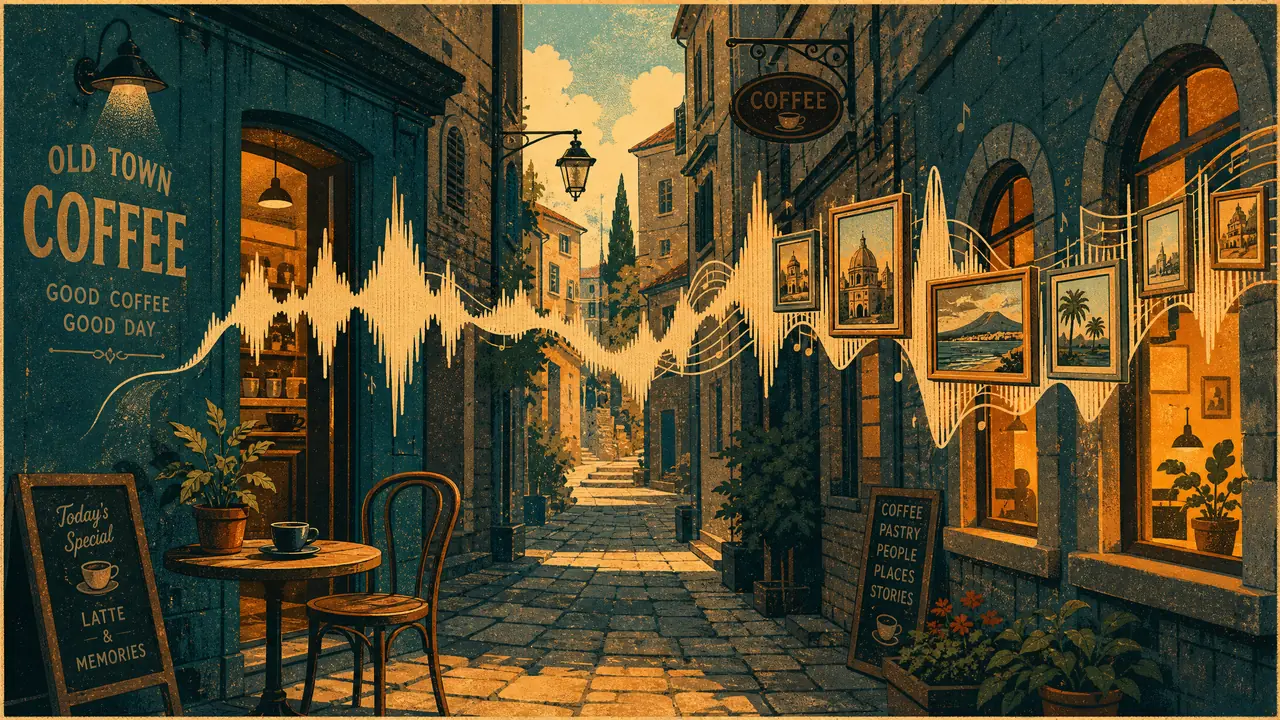
不卖关子:AI绘画和AI声音搭着用,声音要先行、画面跟着声波走,这条顺序最省返工。我做了一条两分半的配音短片实测两种流水线,卡点技巧、翻车账和声音侧的合规边界全记录在下面,照抄能少走三天弯路。
AI绘画和AI声音这两样,单独用都不难,难的是让它们咬合上。上个月我帮朋友做一条介绍老城区咖啡店的短视频,文案三百三十字,打算AI配音加AI出图,全程不请真人。开工前我以为最大的难点是画质,做完才知道,难的是"对齐"这两个字。
声音是时间的艺术,画面是空间的艺术,视频把两者拧在一起。图再好看,晚半秒进,味道就散了。这篇就把这次实测里关于配合的部分摊开讲,顺序、卡点、规矩,一样不落。
声音先行还是画面先行?我两种都跑了一遍
短内容先定音再配图,返工最少:配音时长决定了画面总量和每张图的驻留秒数,倒过来做必然反复改。长片可以例外,两分钟内的短片别犹豫。
我先犯了个典型错误:兴冲冲先出了十八张图,个个满意,然后才去配音。配完一算,文案念完两分二十六秒,平均每张图只能摊到八秒出头,而我最得意的几张细节图,八秒根本看不完;有几张氛围图倒是拖得太久,观众会腻。整套画面的节奏全被打乱,只好回去补图。
推倒重来时我换了顺序:先把文案给AI配音定稿——语速调到每分钟二百六十字左右,成片两分半整。再把音频铺进时间线,照着波形打点,每句话落一张图,句与句之间留气口。这回十八张图有明确的名额分配:重点句给特写,过场句给空镜,配图像填格子一样填进去,一遍成。粗算下来,声音先行的做法比画面先行少返工了整整一晚。
结论很朴素:声音是这条流水线的尺子。尺子没定,量什么都白量。
画面怎么跟声音咬合:三招够用
卡节奏点、跟情绪走、留呼吸空镜,三招能让静态图在配音下活起来,误差控制在半秒内观众就无感。不需要专业设备,一条波形图就够打点。
第一招,硬卡点。配音里每个句号的落点,画面必须切换。我把音频导进剪辑软件看波形,波峰收尾处就是切点,十八个切点全对齐后,整片有种奇怪的顺滑感,朋友说像有真人剪辑师跟过片。手打第一遍可能要多花二十分钟,但比来回调强得多。
第二招,情绪跟色。文案讲到"清晨排队"那几句,画面全部换成暖黄色调;讲到"雨后傍晚",立刻切青灰。声音的情绪和画面的色温同频,观众的体感节奏自然就出来了,有个观众留言说"看着看着好像闻到咖啡味",这条我截图存了。
第三招,敢留白。有两句纯过渡的话,我什么都不放,只给一张空椅子慢推近。做完发现这两处恰恰是全片最舒服的地方,比塞满图强。声音有气口,画面也得有。
声音这头的规矩,比画面那头严
AI声音的合规比AI绘画更紧:别克隆他人声线,配音成品标注AI生成,背景音乐用有授权的源。图错了一般是丑,声音错了可能惹麻烦。
做配音时我试过拿某位知名主持人的声音特征去调,试了一版就删了——太像了,像到我自己都觉得心虚。拿可识别的人声特征去合成,踩的是人格权的线,跟绘画里模仿画风完全不是一个量级。
最终成片的配音我用了无名的合成音色,发布时在简介里标注了AI配音和AI生成画面。平台对AI内容的标注要求这两年只紧不松,老实标,睡得着觉。也别小看观众的眼睛,标了反而更多人愿意信你。
背景音乐我踩过浅坑:最早用了素材站的"免费"曲目,仔细看授权条款才发现仅限个人。换成了明确可商用的音源,多花了半小时搜,省了后患。顺便记一条经验:授权条款截图存档,发布平台核查的时候能救命。
片子最后发出去,朋友店里那周客流量涨没涨不好说,评论区倒是有人问"配音是请的谁"。全流程两个人都没出镜、没开口,声音画面的咬合做到位,观众其实分不出这条流水线上有没有人。尺子先定,格子填满,气口留足——这十四个字就是我这次实测攒下的全部。
常见问题
不会剪辑软件,这套流程能跑吗?
能,门槛比想象低。打点对齐在手机剪辑App里也能做,我后来用平板剪过一版,功能和电脑端差不了太多,就是导出慢些。
AI配音会不会听着很假?
现在的合成音色日常场景够用了,破绽主要在长句的停顿处理上。文案写成短句,标点利落,假感会小很多。
画面全用静图不动,观众会不会看腻?
单张驻留控制在十秒内、切换跟住句子,静图节奏就不会塌。想再活一点,给图加轻微的推拉缩放就够,别上复杂转场。
配音和背景音乐谁的声音大一点?
配音优先,背景乐压到人声的三分之一左右,句间气口处可以让音乐冒头。混完自己闭眼听一遍,听不清词就再压。