ai绘画的ai系统是怎么搭起来的:从你点按钮到出图
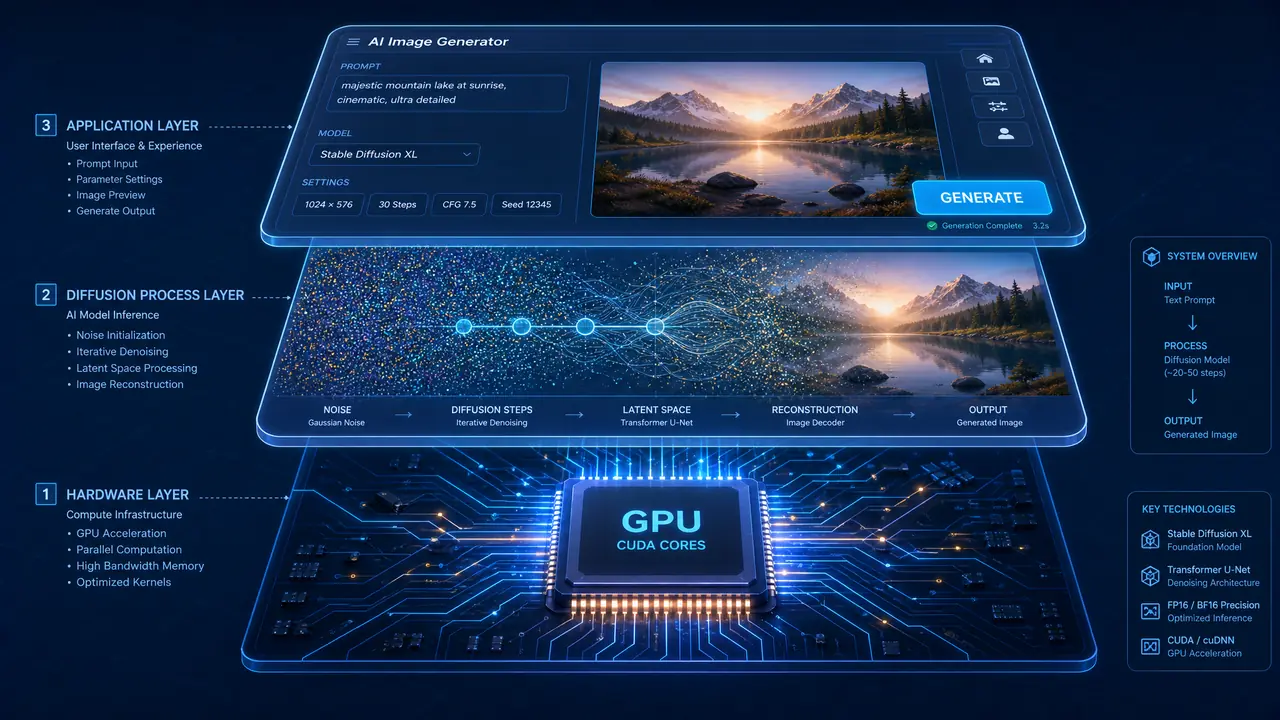
把结论摆在桌面上:AI绘画系统就三层——模型负责怎么画,算力决定画多快,前端管你和这两者之间的对话。你抱怨的每一个体验问题,都能在这三层里找到归宿。
ai绘画的ai系统这个词,听起来像营销话术,其实是正经东西。上周我在自己那台老电脑上折腾本地部署,显存不够当场翻车,反而把整套系统的门道摸得更透了。趁热把这套架构写下来,不堆术语,就讲清楚一件事:你点下生成按钮之后,那十秒钟里到底发生了什么。
三层架构:模型是画手,算力是手速,前端是柜台
AI绘画系统由扩散模型、GPU算力、前端界面三层组成,模型决定画面的上限,算力决定出图速度,前端决定你能不能用好前两者。缺哪层,体验都塌。
模型这层,现在主流的是扩散模型。它的工作方式说起来有点反直觉:先往一张纯噪声图里「看」你的提示词,然后一步一步把噪声擦掉,擦个十几二十步,画就出来了。你理解的「画」是添笔,它理解的是去噪。
算力这层是物理世界的事。去噪那十几步,每步都是大规模矩阵运算,CPU干这个慢得让人发疯,全靠GPU。云端服务动辄几十张卡轮着跑,你本地一张消费级显卡,差距就是在这里拉开的。
前端是最被低估的一层。你填的提示词、调的重绘幅度、选的尺寸,全是它在翻译成机器能懂的请求;出图之后的时间戳、任务排队、历史记录,也全是它管的。同一个模型,前端做好做坏,效率能差出三倍。
一张图的旅程:从点按钮到看到的十秒钟
点按钮后,提示词先被前端编码成交叉注意力条件,再由GPU迭代去噪15到25步,最后解码成图回传,全程最耗时的环节是中间的去噪循环。排队和报错也都发生在这条链路上。
拆成四步看。第一步,前端把你的输入打包发出去,这一步不到一秒,真正慢的是它前后的排队;第二步,文本编码器把提示词变成模型能理解的条件向量,「画家」「水彩」这些词从此失去了字面意义,变成一串数值;第三步,GPU开始迭代去噪,20步左右,这是整条链路里九成时间的去向;第四步,解码回传,前端把图摆到你面前。
排队这件事就出在第一、三步之间。云端服务的GPU不是随叫随到,高峰期你的请求在一堆任务里等位,这就是为什么晚上八点出图要40秒、早上七点只要9秒。我连续记录过一周,规律稳定得很。
报错也多发生在链路两头。提示词里塞了触发词导致被拦截,是入口的事;显存爆了直接黑图,是出口的事。下次遇到问题,先想想卡在哪一段,比到处乱试有效。
本地跑和云端跑,实测差在哪
同一组参数,云端9秒出图,我的6GB显存老显卡跑了45秒还缩了分辨率,本地部署的优势是无限量和不排队,代价是硬件门槛。轻量用户选云端,重度折腾选本地。
上周末我在自己的旧显卡上装了本地环境,折腾两个多小时才跑通,这里全是眼泪换来的数字。
| 对比项 | 云端服务 | 我的本地部署 |
|---|---|---|
| 单张耗时(1024方图) | 9-12秒 | 45秒左右 |
| 并发 | 随便点 | 开第二张就排队 |
| 新模型尝鲜 | 等官方上架 | 发布当天就能换 |
| 隐私 | 图要上传服务器 | 不出硬盘 |
| 门槛 | 注册就能用 | 装环境翻车一下午 |
翻车名场面:第一次跑,我忘了降分辨率,直接按云端的习惯填了1536,显卡当场罢工,出来的图是半张黑块。查了半天才知道6GB显存跑大分辨率要开省显存模式,换算下来速度再打七折。本地部署最大的谎言就是「自己的电脑随便画」——随便的前提是你懂显存账。
还有个容易忽略的细节:本地跑图对散热很敏感。我那台老本子跑三张之后风扇声跟起飞似的,速度也从45秒掉到将近一分钟,垫高机身加个散热架才稳住。云端没这烦恼,电费和热量都由机房替你操心。
我的最终分工:日常出图、赶量走云端;涉及隐私的委托图和玩新模型,回本地。两头各干各的活,谁也别想取代谁。
搞懂这套系统的好处很实际:出图慢,你知道该看时段而不是骂网速;图糊了,你知道是去噪步数没给够而不是手气差。那台老显卡现在还在桌角嗡嗡转着跑本地任务,它和我租来的云端算力,其实是同一套系统的两个角落。
常见问题
为什么同一个提示词每次出的图都不一样?
起点是一张随机噪声图,种子不变画面结构才不变。很多工具允许固定种子,想让结果可复现,先把种子锁住再微调其他参数。
手机上跑AI绘画为什么比电脑慢?
手机芯片的算力和散热都撑不住大规模矩阵运算,多数手机应用实际是把请求发到云端服务器跑,慢主要慢在排队和网络往返。
显存不够会怎么样?
轻则速度暴跌,重则输出黑图或直接报错。可以把分辨率降到1024以内、开启省显存模式,或者换小一点的模型来缓解。
本地部署需要什么配置?
一台带独立显卡的电脑是底线,显存6GB起步才能舒服跑主流模型。显卡之外,硬盘和内存的要求都不高,装环境的耐心比硬件更稀缺。