ai绘画ai视频结合后运镜词怎么写?镜头语言的提示词细节
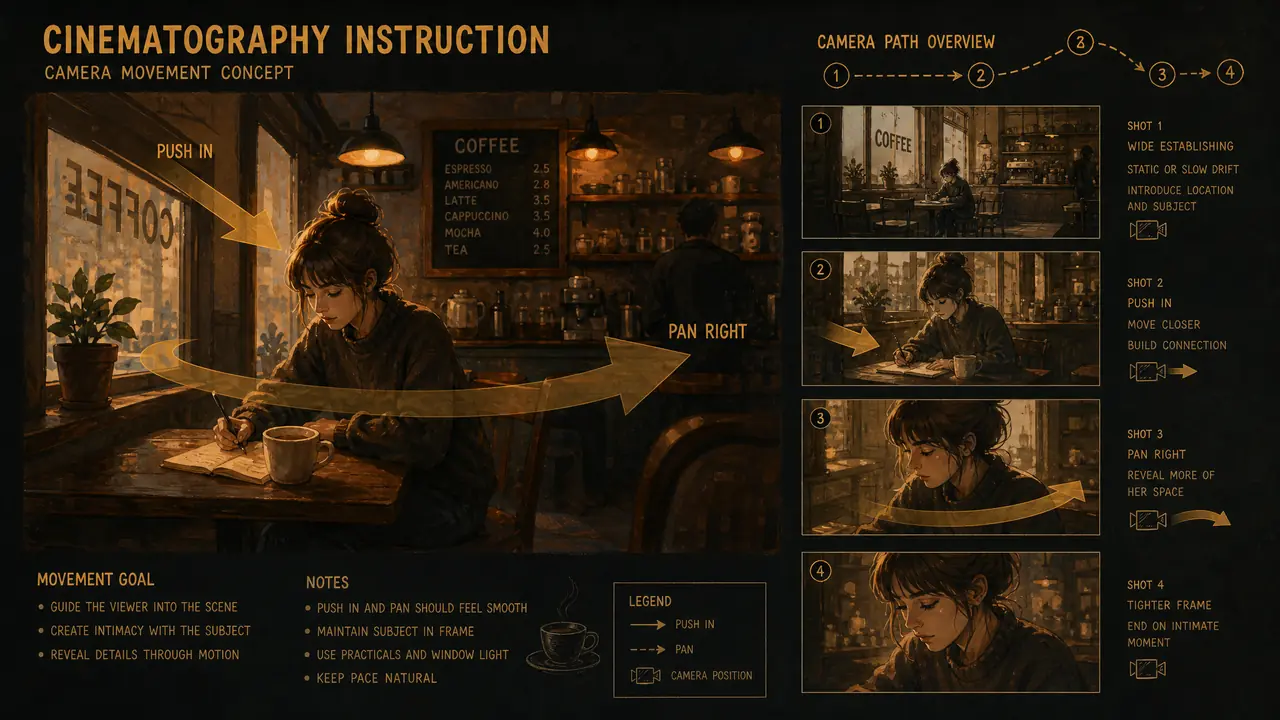
图生视频的成败,提示词里运镜词占一半:三段式写法——镜头动作、主体动作、速度感,各说各的,一个镜头只给一个指令。塞两个镜头动作,画面必抖。这是我从几十段废片里换来的经验。
ai绘画ai视频结合这条流水线,前面篇目讲过怎么排顺序,这篇专抠中间最玄的一环:运镜词怎么写。50 字版结论——图定稿之后,视频模型听的是镜头语言,不是形容词堆砌,写运镜词像给摄影师下指令,别像写散文。
为什么单独拎出来说?因为我在这一步浪费过整整一个晚上。同一张图,写「电影感十足地缓缓移动镜头展现少女回眸的唯美画面」,出六段,两段镜头乱晃,两段人物漂移,只有一段勉强能看。后来把这句话拆开重写,三段各归各位,五段里四段能用。词没多写一个,结构变了。
运镜词的骨架:镜头、主体、速度三段分开
运镜词按三段写:先说镜头怎么动,再说画面里的人或物怎么动,最后给速度和幅度。三件事各占一句,别揉在一起。
拿那次翻车的句子改造示范。「电影感十足地缓缓移动镜头」是镜头动作但混了形容词,「少女回眸」是主体动作,「唯美画面」是废话。拆开后我写成:「镜头固定不动」「少女缓慢转头看向镜头」「运动幅度小、速度均匀」。出来的画面干净利落,转头就是转头,没有多余的晃动。
为什么这样更稳?我的理解是视频模型在首帧图上做的是「猜下一帧」的活,你给的指令越单一,它猜的方差越小。一段话里塞三种模糊要求,模型只能各满足一点,结果就是镜头晃、人物也晃。速度感这个词尤其关键,我在对比里单独测了它。
一个镜头一个指令:贪多是翻车之源
同一段 5 秒里,推近和横移只能二选一,写了两个镜头动作,模型会同时执行然后互相打架。想要复杂运镜就切段,一段一动作。
翻车记录必须记这笔。我写过「镜头缓缓推近主角面部,然后向右横移展现整个房间」,出的画面在第三秒开始剧烈抖动,人脸拉扯变形——模型先推近再横移,切换的瞬间没有过渡帧可用。改成两段:第一段推近,第二段拿推近的末帧当新首帧再横移,衔接处加 0.3 秒叠化,比一段硬出流畅得多。多花 90 秒出一段,值。
还有个隐藏坑:运镜词和运动幅度参数会互相打架。我固定运动幅度 4 档之后写「剧烈推近」,出来的画面边缘撕裂。后来明白参数和词要配套:幅度 3 到 4 档配「缓慢、轻轻」类词汇,幅度 5 档配「快速、猛烈」,两边唱反调,画面就崩。现在我的词库里每个运镜词后面都标了配套档位,直接抄作业。
| 运镜写法 | 实测效果 | 配套幅度 |
|---|---|---|
| 缓慢推近,主体静止 | 最稳,特写首选 | 3 档 |
| 固定镜头,主体转头/抬手 | 稳,适合对话感镜头 | 3-4 档 |
| 缓慢横移展现全景 | 稳,空镜好用 | 4 档 |
| 快速拉远 | 略糊,开头两帧有跳变 | 5 档 |
| 推近加横移同段出现 | 抖动、变形,直接废 | 别这么写 |
同一张图的四种写法:实测对照
同一张图配不同运镜词,可用率差距巨大:单一动作加速度词的四段全过,混写形容词的一段没过。词的精确度就是废片率的倒数。
上周我拿同一张咖啡馆定稿图做了组对照,四个写法各出两段。写法一「镜头缓慢推近咖啡杯,蒸汽向上飘」,两段全过。写法二「镜头固定,女生微笑着抬起杯子」,两段全过。写法三「唯美镜头环绕咖啡馆,女生同时起身走动」,一段镜头漂移,一段人影拖尾,全废。写法四只写「画面动起来」,两段都出了轻微的无规则晃动,凑合能用但没法看第二遍。四组八个词,答案很清楚。
主体动作这块再补一个细节:动作幅度跟画框有关。半身图里写「转身」容易把人物转出画面,全身图就没这个问题。我现在固定规矩——半身图主体动作只写头部和手部,大动作留给全身图。这条没人教过我,全是废片教我的。
运镜词写到这个份上,其实就一句话的事:把视频模型当成一个只听得清单口令的摄影师。指令越短越单一,他执行得越利索。ai绘画负责给他一张好图纸,运镜词负责告诉他这台机器要怎么动,两环都干净,成片自然干净。下次出片前,先把你要的那个镜头动作用三个短句写出来试试。
常见问题
运镜词用中文还是英文好?
我用中文,主流平台的中文理解都够用。比语言更重要的是结构,三段式用英文写乱了一样翻车。
「缓慢」这类速度词加几个合适?
一个就够。写「缓缓地慢慢地推近」不会更慢,反而可能让模型不确定要多慢。速度感一个词,幅度交给参数档位,别用词堆。
人物说话的口型能靠运镜词控制吗?
不能,口型是另一类功能,跟运镜词是两回事。我试过写「边转头边说话」,出来的嘴部动作像咀嚼。需要开口说话的镜头,老实用对口型工具单独处理。
空镜素材的运镜词可以偷懒吗?
空镜反而更要写清楚。我给云层写过「缓慢向右流动」,比只写「天空延时感」稳定得多。空镜没有主体动作那段,就把镜头动作写得更具体。