AI绘画 儿歌配图实操:逐句拆歌词出分镜,做娃爱看的绘本视频
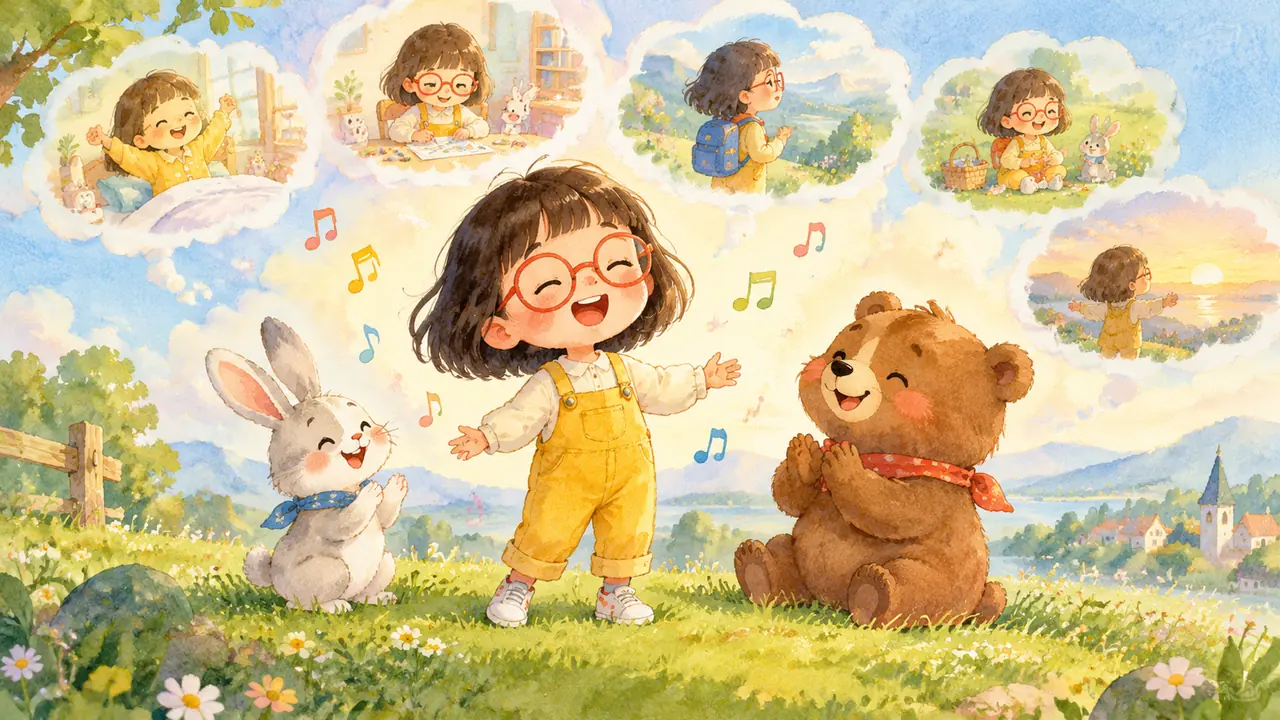
一句话版本:儿歌配图的本质是分镜,不是单张美图,先逐句拆歌词定画面,再想办法把主角长相锁住,最后才谈风格。别上来就磨单张图的质感,镜头与镜头之间的连贯才是娃看不看得下去的关键。
AI绘画 儿歌配图这件事,我最初以为就是给每句歌词配张漂亮的画,真上手才发现完全不是那么回事。去年我给家里娃的一首自编儿歌做过一版配图视频,十句歌词出了四十多张图,前三个镜头里的小主角还是圆脸蛋,第四个镜头突然换了个发型,娃指着屏幕问我:这是谁呀?那一刻我才明白,儿歌图的难点在一致性,不在好看。这篇把我的完整流程和踩过的坑都摊开讲。
第一步:把歌词拆成会讲故事的分镜
一句歌词对应一个镜头,先给每句标注画面类型——主角登场、动作、场景、情绪,再按类型填画面要素,歌词拆得细,图才不会乱。先写分镜表,再开软件。
我的拆法是在纸上画个四栏表:
| 歌词类型 | 画面要素 | 提示词侧重 | 我的经验值 |
|---|---|---|---|
| 主角登场句 | 全身像加标志性配饰 | full body, character reference | 配饰要够独特,是认人的记号 |
| 动作句 | 大动作加留白给字幕 | dynamic pose, side view | 动作幅度写大点,小动作容易糊 |
| 场景句 | 远景环境,主角可小 | wide shot, scenery | 给视频留呼吸感,别塞满 |
| 重复副歌 | 同构图微变体 | 固定种子换背景词 | 副歌唱两遍,画面得有呼应 |
拆完你会发现,一首十句的儿歌真正需要单独设计的画面也就六七个,剩下的靠变体凑。我第一版就是没拆,对着整句歌词硬生画,画面里什么元素都想要,结果每张图都挤成一团,娃的注意力根本抓不住重点。
第二步:锁主角,一致性比画风更难
固定种子加一段不动的角色描述词是底线,讲究点的用参考图或角色卡功能,服饰特征写死在每一条提示词里,换场景不许换。主角的记号越多,越不容易跑偏。
我的角色描述词是这么写的:五岁小女孩、齐刘海短碎发、红框圆眼镜、黄色背带裤、白色小皮鞋。这一串在每条提示词里原样复制,一个字不改。红框圆眼镜就是她的记号,戴上眼镜,跑偏率肉眼可见地降了,因为模型得先画出眼镜,脸型就会被带住。翻车三次里最惨的一次,是我图省事把背带裤写成了裙子,出来的主角整个气质都变了,连娃都说这不是刚才那个。还有个细节:每改一次种子,主角长相就重抽一次,所以确定主角的那张图,种子要抄下来存好,后面所有镜头都拿它当起点。
第三步:风格和节奏,跟着娃的注意力走
学龄前选厚涂绘本风或柔和水彩,饱和度适中,一个镜头在屏幕上停三到五秒,画面切换跟着歌词的短句节奏走。太花哨反而抢了听歌的注意力。
我试过两种风格,荧光卡通风看着热闹,娃盯了两遍就没兴趣了,换成柔和水彩绘本风反而反复要看,画面安静,儿歌的节奏才突显得出来。节奏上我踩过一个坑:早期一个镜头停了八秒,娃以为视频卡了。后来按歌词短句切,一句一换,明显坐得住了。制作环节不用上复杂的软件,图片加音频拖进剪辑工具,按分镜表排好顺序就能出片,我全套做下来一个晚上,其中出图占了小半个钟头,一张图大概十几秒,倒是剪节奏和调转场花的功夫最多。
发布前要过的一道坎:素材来源得干净
经典儿歌的词曲大多有版权,自己编词编曲再配AI插图是稳妥路线,想用现成儿歌必须先确认授权,别拿别人的作品搭便车。给孩子做的东西,来源更要干净。
这也是我从第二版开始坚持自编的原因。查过一圈才发现,耳熟能详的儿歌多半在版权期内,随手配图发出去,小圈子玩玩或许没人计较,真做大了就是隐患。自编其实不难,押韵的小词配上简单的旋律生成工具,一晚上能出一首,图和歌都是自己的,发出去心里踏实。孩子看到的作品,多这一道工序,值得。
回头看那次给娃做儿歌视频的经历,技术环节都是小问题,真正让我上心的是一致性这道坎和素材来源这道坎。分镜表、角色记号词、种子记录这三个习惯保留至今,后来做任何系列图都在用。流程就是这些,剩下的交给你家那位最严格的小观众来验收。
常见问题
不会画画也能给儿歌配图吗?
完全可以,AI绘画要的是描述能力不是手上功夫,把歌词拆成一句句画面描述就能出图,我认识好几位做配图的家长都不会画画。
主角一致性用免费的工具能做到吗?
能,固定种子加写死的角色描述词就能达到七八成稳定,剩下的靠多抽几次挑最像的,不一定非得上付费功能。
儿歌视频发到平台会被判搬运吗?
图是自己生成的、歌是自己编的就不算搬运,发布时按平台要求标注AI生成内容,材料来源干净就不怕审。
一首儿歌大概要出多少张图?
十句左右的儿歌,设计六七个镜头再补几张变体,十五张上下基本够用,出多了娃也记不住。