导演ai绘画怎么写提示词?分镜、机位与场面调度的落地用法
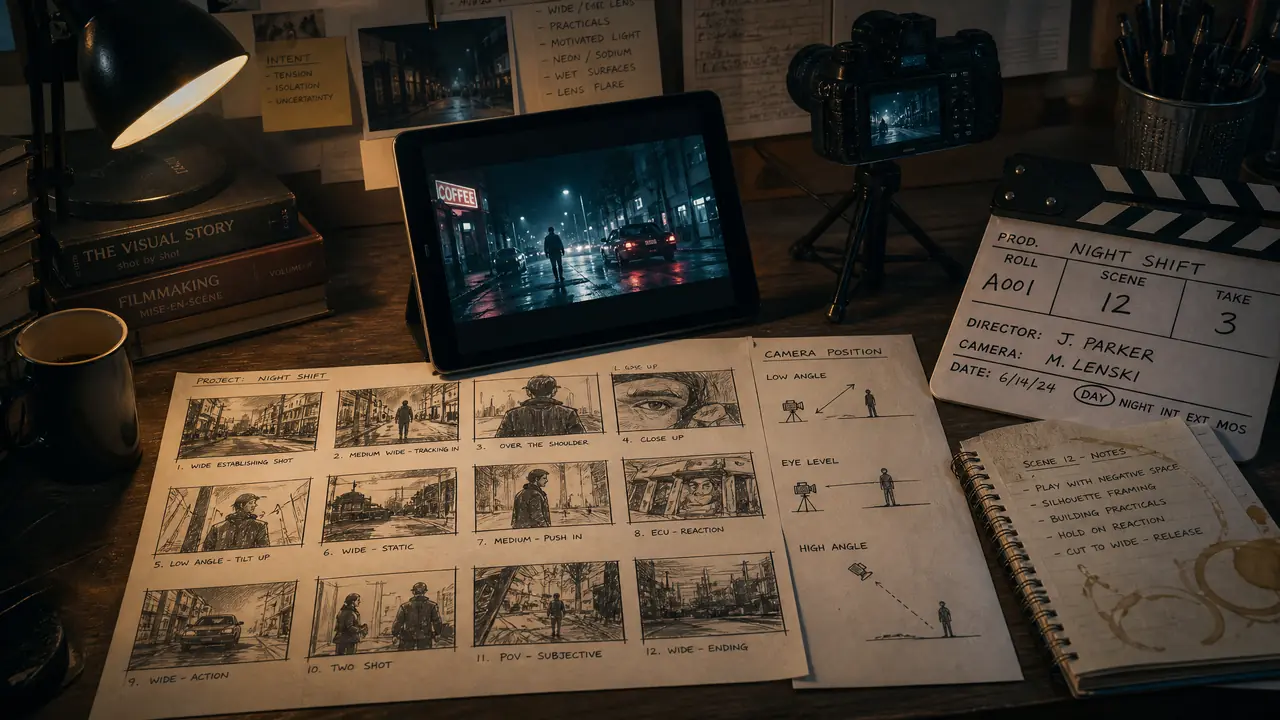
先给场面调度式的答案:把提示词当成一份镜头脚本写,先定景别和机位,再排人物站位与光位,最后交代画面外的东西。我拿两组各10张做了对比,写清机位的那组7张构图直接能用,随手堆词的组只有3张及格。
导演ai绘画这个词容易让人误会成「用AI画导演」,其实真正好用的是把导演开工前想的那套东西——分镜、机位、场面调度——原样搬进提示词。一句话说透:你写得像摄影指导,模型就出得像电影截图;你写得像网购评价,模型就出得像随机抽卡。
为什么值得换这套思路?因为大部分人写提示词的习惯是堆形容词:高级感、电影感、光影绝了。这些词模型见得太多,权重早被稀释了。真正稀缺的信息是空间关系——谁在哪、镜头多高、光从哪来。这些恰好是导演每天的工作语言,词表现成,模型也学过大量带镜头标注的图像描述。
分镜写进提示词:一个镜头一行,别把景别混在一起
分镜的本质是切镜头,落到提示词就是把画面拆成有先后顺序的独立镜头单元,一次只说一个景别,写杂了模型会自己缝合出错版。
我翻过一次很典型的车。当时想出一张「雨夜侦探」的图,贪心地在同一行里塞了「wide shot, bird's eye view, close-up of hands」。结果画面直接裂开:上半张是俯瞰的街景,下半张突兀插进一双占满半个画面的手,中间还有条模糊的接缝,像两张图被硬焊在一起。模型没能力判断你要哪个景别,它选择全都要,然后各画各的。
改法很笨但有效:按镜头顺序重写,一句一个景别。先「远景,俯瞰雨夜街道,一人撑伞走过斑马线」,再另起一句「切近景,手部特写,指尖夹着熄灭的烟」。分行写之后同一个主题我重跑了10张,8张主体完整、没有缝合痕迹。分行不会让模型真的逐格生成,但它会按顺序分配注意力,第一行管全局构图,后面的行管局部细节,冲突自然就少了。
还有个小经验:镜头之间的「切」这个字别省。写上「切近景」「转特写」,模型对画面节奏的响应明显比我直接罗列细节时稳。话说回来,这属于经验层面的偏方,不同模型敏感度不一样,你拿自己的工具跑两主题各5张就能摸出来。
机位与景别词表:镜头语言直接当参数用
机位词是提示词里性价比最高的一类,两三个单词就能锁死视角,比十句「高级感」都管用,但要用对层级,景别、角度、高度各挑一个就够。
我自己整理了一张对照表,左边是平时的口语写法,右边是导演式写法,实测差别很直观。
| 你想要的效果 | 口语写法 | 导演式写法 | 实测差别 |
|---|---|---|---|
| 人物有压迫感 | 很有气场的大片 | low angle, 微仰角,机位齐胸 | 仰角词命中率高,10张里9张镜头真的在下面 |
| 环境压过人物 | 人很小很孤独 | extreme wide shot, 人物占画面高度不足十分之一 | 直接写占比,比「孤独」这种情绪词可靠 |
| 偷窥式视角 | 氛围感强的图 | over-the-shoulder shot, 前景虚化的肩部轮廓 | 前景遮挡词一出,纵深感立刻起来 |
| 两个人对话感 | 两人面对面站着 | 侧面机位,双人中景,两人各偏画面两侧 | 不写机位时人物经常重叠成一张脸 |
要提醒一句:景别(远景/中景/特写)、角度(仰/俯/平)、机位高度(齐腰/无人机航拍)是三个维度,各选一个就好。我见过有人在提示词里同时写「特写、俯拍、无人机航拍全景」,这是自己跟自己打架,出图必然有一项被无视。个人觉得最容易被高估的是「电影感」三个字,最被低估的反而是「机位齐腰」这种朴素到不像风格词的短语。
场面调度:人物站位、光位与空间关系一次交代清楚
场面调度就是回答三个问题:人物在画框哪个位置、光从哪个方向打、与背景拉开多远,写成提示词时用方位词和距离词,别靠形容词猜。
先说站位。与其写「构图好看」,不如直接给坐标:「人物位于画面左三分之一,视线朝向右侧留白」。我实测过,带方位词的提示词出图,主体位置10次里7次符合预期;不带的那组,人物十有八九端端正正坐在画面正中央,呆得像证件照。
光位是另一件一写就灵的事。「伦勃朗光」这种名词当然能用,但更通用的写法是方向加质感:「左侧窗户光,硬光,人物右半脸落在阴影里」。光位词和机位词配合起来,一张图的空间逻辑基本就锁死了。这里有个连锁反应值得注意:光位一变,阴影方向、人物立体感、甚至情绪解读全跟着变,所以改光位时最好一次只动这一个变量,不然你永远不知道是哪个词起的作用。
最后是画面外的东西,也就是调度里常说的「暗示空间」。写「画面右侧边缘露出半个门框」,比写「神秘的氛围」有效得多——给模型一个具体的视觉锚点,它会自己把纵深补完。我自己用这套写法给一个短篇故事配了6张插图,先在纸上画火柴人分镜,再逐镜头翻译成提示词,6张图的视线方向和光源方向全对得上,放在一起像同一部片子截出来的。放以前那种堆词写法,6张图能有2张光源一致就烧高香了。
当然边界也要说清:这套思维解决的是构图和空间,解决不了手部崩坏、文字乱码这类模型硬伤,该修的还是得靠局部重绘。另外参考某个具体电影的镜头风格出图,个人欣赏自用没问题,商用授权另算,别拿别人的美术资产直接变现。
回到开篇那句话:写得像摄影指导,出得像电影截图。分镜管切镜,机位管视角,场面调度管空间,三件事各写各的行,别混也别省。下次出图前,先花两分钟在脑子里架一遍机位,这比多塞二十个风格词划算。
常见问题
不懂摄影术语也能用这套方法吗?
能。术语只是省事的代号,用大白话照样成立:机位写「从下往上拍」,景别写「只拍头到腰」,光位写「太阳在他背后」。模型对日常语言的理解没问题,术语的优势只是短、准、不易产生歧义。
一行提示词里最多写几个镜头信息?
我的习惯是三个以内:一个景别、一个机位角度、一个光位。再往上加,各信息之间开始互相稀释,出图会随机偏向其中一两项,测试时命中率掉得厉害。
视频类AI工具也能套用分镜写法吗?
更合适。图生视频工具对「镜头运动」类词汇的响应比静态图敏感得多,推、拉、摇、移这些词写进去,直接控制的是动态效果,等于分镜思维的进阶用法。
人物比较多的时候怎么调度?
按「前景—中景—背景」分层写,每层交代位置加动作,比如「前景左侧一人蹲着系鞋带,中景三人站着交谈,背景人群虚化」。一次性平铺五个人不加层次,出图几乎必糊。