人工智能ai绘画技术是什么原理?从噪声到成图的拆解
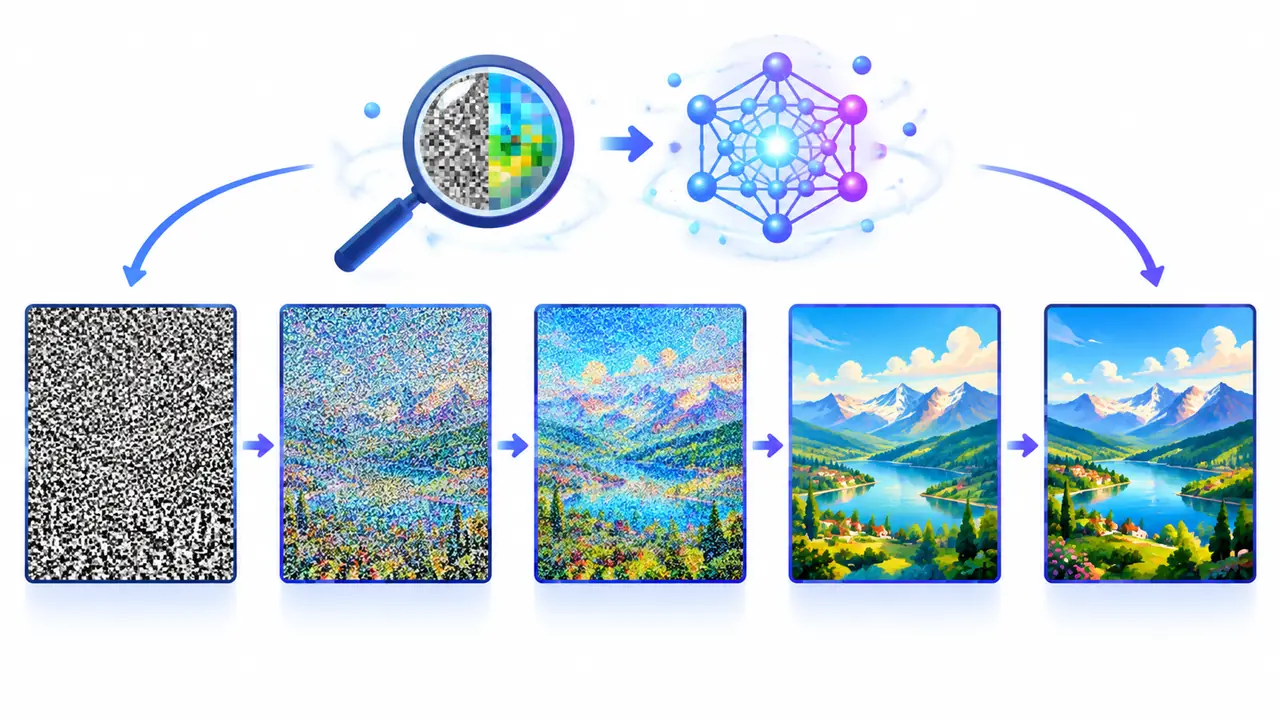
我的判断是:ai绘画没那么神秘,一句话讲就是"学会去噪的还原游戏"。理解了这个原理,很多现象立刻说得通——为什么描述越具体图越稳、为什么手指老崩、为什么换个模型等于换画风。
人工智能ai绘画技术这几年的跃进,很多人用"魔法"形容,但底下跑的东西相当朴素:一套叫扩散模型的数学流程,加上海量图片喂出来的视觉经验。把这层纸捅破,你用工具时会踏实很多,遇到翻车也知道该往哪儿找原因。
从雪花点开始:扩散模型在干什么
扩散模型两步走:训练时给图片逐层加噪,学会预测并去掉每层噪声;出图时从纯噪声开始,按提示词方向逐层去噪,浮出成图。
训练阶段像教小孩认东西的反操作:拿一张照片,往上撒一层淡淡的雪花点,再撒一层,撒到几十层之后整张图彻底变成电视雪花屏。模型的任务是从轻到重,练习把每一层的噪声猜出来、去掉它。练了几十亿遍之后,它对"图该长什么样"有了一套概率直觉。
出图就是把这套直觉倒过来放。起点是一张纯噪声,模型按你的提示词指的方向,一层一层把"不该有的噪声"抹掉。你在工具里看到的进度条,本质就是去噪的层数。步数调低图会糙,就是抹的次数不够,噪声没擦干净。
2022年下半年开源模型铺开之后,这套技术从实验室落到了普通人手里,算力门槛一路降到现在手机云平台都能跑。原理从那时到现在没有翻天覆地的变化,变的是训练数据、模型规模和细节控制的手法。
提示词是怎么被"听懂"的
文本编码器把提示词变成一串向量,充当去噪过程的路标。词写得越具体,路标越清晰,图偏得越少;全是虚词,模型只能自由发挥。
模型不认识汉字也不认识单词,中间有个翻译官叫文本编码器,把你的句子转成一串数字向量。每个词的向量都带着它在海量图文里攒下的关系网——"羽扇"连着白色、羽毛、诸葛亮那些联想。你的提示词就是给去噪过程指路的一组坐标。
这也解释了写词的门道。"超高清、杰作"这类词不是没用,而是信息量太薄,路标立了一根光秃秃的杆子;"红金古风战裙,广袖,层叠裙摆"是实打实的坐标,模型知道往哪儿走。我早期写词爱堆形容词,图出来总差点意思,把虚词换成实物描述之后,出图的命中率立刻不一样了。
为什么像人画的,又为什么老崩
出图像人画,模型学的是千万张图里的视觉规律,不是死记图片;手部老崩,手的姿态变化太多、训练里常被遮挡,规律最难学。
很多人担心"模型是不是在拼贴训练图",方向搞反了。它记不住也不储存原图,学到的是规律:光从哪儿来影子往哪儿落、皮肤在逆光下是什么色、布料垂坠的褶皱走向。所以它能画出从没存在过的构图,可一旦你的提示词把它没见过的组合硬凑在一起,规律之间打架,图就开始诡异。
手指是老生常谈的崩点,原理上一点不冤:手有二十多个关节,姿态千变万化,照片里还经常握着东西、只露几根手指,规律碎得没法学。脸就不一样,人人都要露、姿态相对固定,模型练得滚瓜烂熟。知道这个,你就明白为什么修手要靠局部重绘单独来——这不是玄学,是短板补短板。
我自己的体会:把模型当成一个"规律很强、常识为零"的画手,预期就摆正了。它不知道世界上猫有几条腿这种事实,它只知道图里的猫通常怎么长。数量、文字、逻辑关系这些要靠数的东西,出了错别怪它,它真不识数。
这项技术的边界在哪
边界也很清楚:不懂真实事实,数不清具体数量,画不好文字;涉及照片和真人形象时还有版权与肖像的雷区,用前先想清用途。
头一条边界是真实事实。让它画"新闻现场",出来的图看着像那么回事,细节全是编的,拿去当纪实素材就是造假。这也是我一贯的用法分界:创作和示意交给它,记录和证据交给相机,两者别混。
第二条是真人肖像。技术发展到今天已经能做到一眼难辨,可真人脸牵扯肖像权,公共人物的形象还有额外麻烦。我给自己画像、给朋友画卡通头玩没问题,拿别人的脸去产出东西,这条线我劝谁都别碰,跟技术无关,跟人有关系。
绕回开头那句"还原游戏":ai绘画的全部魔法,就是加噪和去噪这两个互为镜像的动作,加上一整个互联网的视觉经验。懂了原理,你会对它宽容一点,也会警惕一点——该它干的活它干得飞快,不该它碰的边界,得自己把着。
常见问题
模型训练时是不是偷存了网上的图?
不是存图,是存规律。训练后模型本身只有几个G的参数,装不下千万张原图,它记住的是统计出来的视觉特征。不过训练数据从哪来、有没有获得授权,确实是行业还在吵的版权问题,使用者心里要有数。
提示词越长,图就越准吗?
不是越长越准,是越具体越准。两百字里塞五十个形容词,不如五组清晰的实物描述。词太多还会互相稀释,模型挑着执行,反而失控。我的经验是一句话内三四个核心元素,多了分段轮流强调。
以后ai绘画会取代画师吗?
从原理看,它擅长的是按规律出图,不擅长从零决定"该画什么、想表达什么"。流程里的起稿、铺图、找参考它越来越能干,创意判断和审美把关还是人的活。会用的人把它当助手,不用的人多一道对手,区别在心态不在工具。