AI绘画推理能力实测:画个冰淇淋上煎蛋,翻车翻出规律
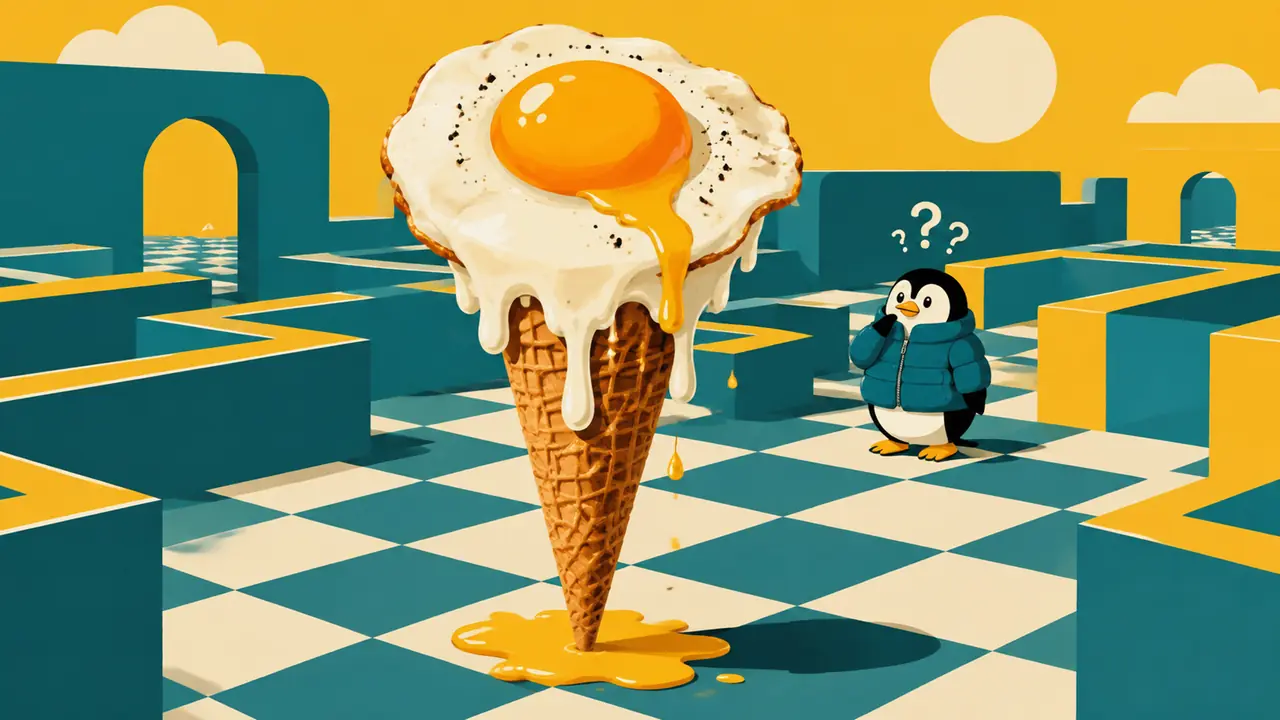
先说结论:AI绘画的"推理"更像联想,不是逻辑推演。我用冰淇淋上煎蛋、鲨鱼织毛衣这类组合题喂了三个模型共九十张图,单概念全对,两个概念凑一起只剩四成能看,三个概念直接散架。想让AI画出没见过的组合,先学会把长句拆开喂。
AI绘画推理这个话题,是被朋友一句"AI能画出它没见过的东西吗"问出来的。他想要一张图:一支甜筒冰淇淋,顶上卧着个单面煎蛋,蛋黄要流心。我当时拍胸脯说这不简单吗。结果打脸打得很快。
我拿手头常用的两个国产模型加一个海外模型,各跑十轮。三十张里,煎蛋出现了二十二张,冰淇淋出现了二十八张,可两个东西同时待在正确位置上的,只有六张。剩下的要么蛋掉在桌上,要么冰淇淋底下垫了块铁板——模型大概觉得,煎蛋嘛,就该在铁板上待着。
三档难度,翻车率完全不是一个量级
同一个模型,单个概念几乎全对,两个概念的组合只剩四成能看,三个概念以上基本散架。AI绘画推理靠的是联想拼贴,不是逻辑推演,概念一多它就开始各画各的。
我把测试题分了三档。第一档是单概念,比如"流心煎蛋""草莓甜筒",九十张里对了八十一张,闭着眼都行。第二档是两概念组合,像"穿羽绒服的企鹅""戴草帽的猫",能挑出能看的不到四成——企鹅往往对,羽绒服也有,但羽绒服经常披在旁边一只海豹身上。
第三档最狠。三个概念往一句里塞,"倒挂在树枝上啃西瓜的熊猫",跑了三十张,只有两张勉强及格,其中一张熊猫倒是倒挂了,西瓜变成了一个红色保龄球。你说它不认识西瓜吧,单独让它画西瓜画得可好了。概念一凑一起,脑子里就打架。
为什么组合一多,画面就散架?
文生图模型先把你的词翻译成一堆视觉概念,再把它们往一张图上凑。凑不动的部分,它就用训练数据里长得最像的画面糊弄过去,糊弄不了就干脆扔掉一半。
你可以把这事想成请一个只会照菜谱做菜的师傅现场发明新菜。他会做的每样食材都认识,可你让他"把麻婆豆腐包进汉堡坯里",他的手就开始凭肌肉记忆乱动——最后端上来的,多半是个撒了花椒的普通汉堡。
最离谱的一次是"戴老花镜织毛衣的鲨鱼"。十张里九张把眼镜画在了嘴上,还有一张干脆给毛线针长在了背鳍上。想想也合理,训练数据里戴眼镜的,八成是人脸,模型把"眼镜"这个概念往它认为最像脸的地方安。鲨鱼嘴,在它眼里约等于脸。
对了,位置关系词也别太信任。"骑在马上倒举雨伞",伞基本都在正常位置——模型对"举"的理解牢牢焊在训练数据里,你想让它在细节处翻新,它比你固执。
组合题想出图,我摸索出三条喂法
把长句拆成主体、动作、道具三段分开写,动作词紧挨主体,位置关系单独一句强调。整句甩给模型,等于把难题原样退回给它。
回到那个煎蛋冰淇淋。我最后能看的成品,是这么改出来的:先把"一份融化的冰淇淋甜筒"单独一句,再加"甜筒顶端放着一颗流心煎蛋",最后补一句"没有盘子,没有铁板"。负面提示词里塞进煎锅、汉堡、餐具。前八轮的图,蛋全都自动滑到旁边的盘子里去了,把退路堵死之后,第九张才老实。
第二条是降低概念密度。真想画"倒挂啃西瓜的熊猫",就分两步:先出一张倒挂熊猫,挑构图最好的,再用局部重绘把西瓜补进它的爪子。一次只解决一个问题,成功率从我那惨淡的一成半拉到过半。
第三条算认怂——实在不行的题,换成隐喻画面。画不出"时间是小偷"这个概念,就画一只手从怀表上抽走齿轮。模型对隐喻的宽容度高得惊人,因为抽象画面在训练数据里本来就没有标准答案,它反而敢放开画。
这三条试下来,我那批组合题的整体出图率从不到三成爬到了七成上下。不算神迹,但够用了。
那张煎蛋冰淇淋最终发给了朋友。他回了个"好耶",配了三个感叹号。九张废图他没看见,我也没提。AI绘画推理眼下就是这个水平——你把它当联想游戏玩,处处有惊喜;当逻辑引擎用,回回要还债。
常见问题
提示词写多长算合适?
组合题控制在两到三个视觉概念以内,超过四个概念,翻车率会陡增。描述细节可以长,但核心组合关系要短促明确,别用从句套从句。
为什么同一条提示词两次出图完全不一样?
出图带随机性,起点噪声不同,结果就不同。部分工具允许固定种子值,种子一样、参数一样,画面才可复现。想对比测试,先把种子锁住。
换更新的模型,组合翻车会消失吗?
会缓解,但不会消失。新版本对常见组合的理解确实更稳,可越冷门的组合,训练数据越稀疏,翻车概率依旧高。拿到新模型,老规矩还是先跑几组怪题试试水深。
不懂技术也能做这种小测试吗?
能。准备十道题、一个记次数的备忘录就够了,我全程用的就是手机备忘录加表格,一轮十分钟,重在记录,不在设备。