生成模特ai口令怎么写?跨境运营压箱底的口令模板
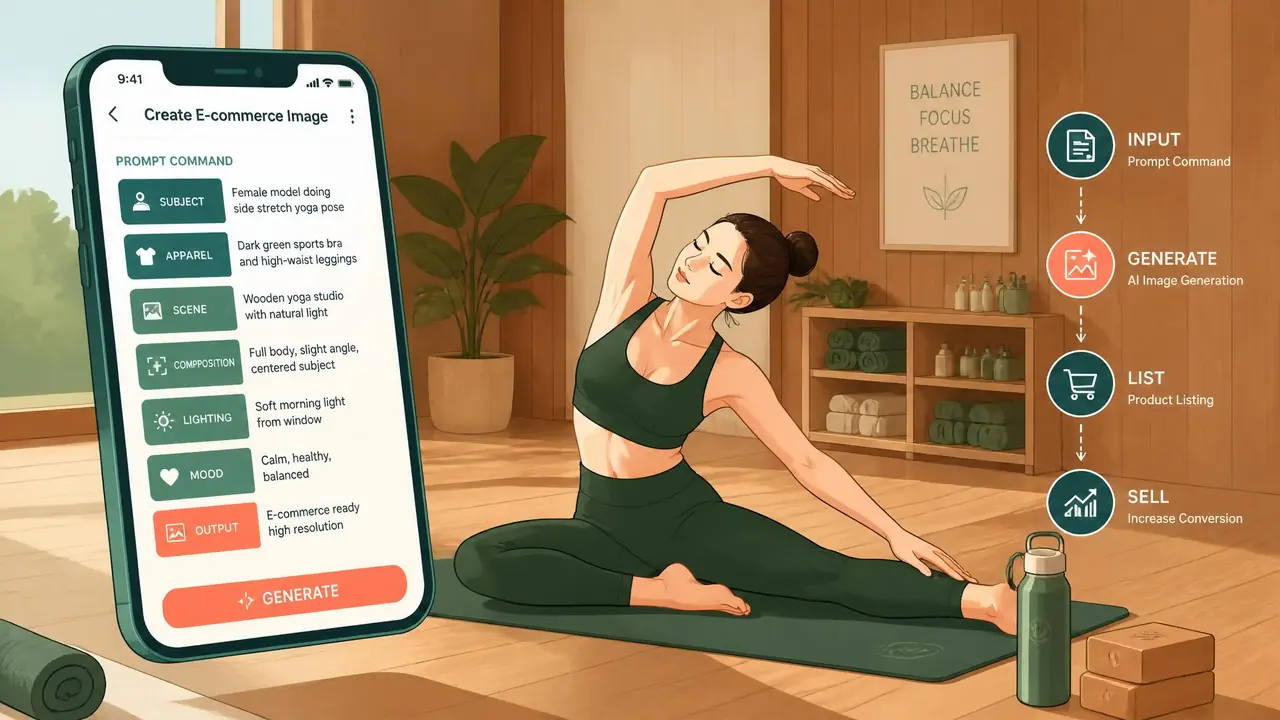
一句话版本:生成模特ai口令拼的不是文采,是信息给得全不全。我做跨境瑜伽服半年,口令里写死身材、场景、光线、机位四项,一次通过率从三成拉到七成往上。模板在下面,改词就能用。
生成模特ai口令这件事,被太多教程讲玄乎了。我在深圳一家跨境公司管瑜伽服线,今年4月开始用AI模特出图,头一个月我最大的感受是:口令写得越像聊天,图崩得越快。后来我把口令逼成了填空题,一次通过率从三成出头爬到七成左右,这个数字是我们内部表格里记的,4月到8月一共跑了六百多张图。
先说个背景:我们出图是拿平铺的瑜伽服白底图,让AI穿到虚拟模特身上,再放到健身房或者瑜伽馆场景里。流程不同,口令侧重也不同,这篇只讲我跑通的这条。
成本也顺便交代:我们用的是按张计费的工具,一张几毛钱,六百多张摊下来不到一顿海底捞。真正贵的是工时,所以下面这些规矩,全是为了少跑废图,不是为了炫技。
一条稳定的模特口令长什么样
稳定口令的结构是:人物身材加服装描述加场景动作加光线机位,四段一口气写完。少一段,模型就自己编一段,编的部分就是崩图的部分。
我直接贴一条跑通过几十次的口令给你:"25至30岁女性,健康微胖体型,穿这件深灰绿瑜伽套装,在木地板瑜伽馆做低弓步拉伸,自然侧光,全身平视机位,真实摄影感。"45个字左右,没一个形容词是多余的。
为什么"健康微胖体型"要写?欧美市场我们的主推码数是L到XL,模特体型跟买家对不上,转化就难看。这个细节是我们6月改的,改完那个月大码款的加购率涨了一截,我不敢说全是模特的功劳,但至少退货理由里"图片与实物不符"少了。
光线和机位也别省。不写机位,AI爱给你半身特写,衣服的关键部位(比如高腰线和裤脚)出不了镜,等于白做。
中文口令和英文口令差多少
同一个工具里,英文口令的细节还原度普遍比中文高一点,尤其动作类描述。但日常够用的话,中文口令加关键词兜底也能打。
我做过一轮对比,5月拿同一批20款瑜伽背心分别用中英文口令各跑一遍:英文版动作还原准的有17款,中文版13款。差距主要在"low lunge"这类动作词,中文写"低弓步拉伸",模型偶尔给你蹲成深蹲。不过描述服装颜色、材质,中文一点不吃亏,"雾霾蓝"这种词中文反而更准。
所以我的用法是混着来:身材、动作、机位用英文,服装、场景、氛围用中文。有人觉得拧巴,试两次就习惯了,比反复重跑省时间,我们组实习生第二天就上手了。
再说一个省命名的招:把跑通的口令存成文档,按"体型-场景-动作"命名。我们组现在共享一个口令库,40多条,新人来第一天就能出能用的图,这一点对经常招人的跨境团队太重要了。
口令之外,这三件事决定你返工几次
口令只占成败的一半,原图质量、单次改动量、抽卡次数上限才是返工率的关键。定好"重跑三次不过就换底图"的规矩,能省大量时间。
翻车最多的一次在6月。一款荧光绿的背心,怎么跑颜色都发灰,废了11张我才反应过来:不是口令的问题,是那张白底图拍的时候曝光不足,绿色本来就被吃掉了。换了一张曝光正常的底图,一把过。
还有个教训是贪心。有次我想让一张图同时改动作、换场景、加影子,结果手指崩了三根。现在规矩是单张图一次只改一个大项,要叠加就分两轮跑。每轮加一次重跑上限三次,三次不过就回到底图排查,别跟它耗。
说实话,我见过最能烧钱的就是没有止损线,一张图磨一下午还舍不得停,工时早就超过重拍一件样衣了。
口令模板这东西,抄来只是起点。我们那条45字的口令,也是从网上抄来的版本里砍掉了七八个没用的形容词之后才稳的。你抄走模板之后,记得拿自己最难搞的那款产品先跑三张,崩了就回头删词,删到稳为止。等你也攒出40条自己的口令,这套活儿才算真接住了,这事真急不来。
常见问题
生成模特的ai口令一定要用英文吗?
不一定。我实测动作和机位描述英文更准,颜色材质中文不吃亏,混着写是我现在的日常用法。
口令里怎么让模特穿指定的衣服?
前提是工具支持喂参考图,把平铺或挂拍的白底图喂进去,口令里再补一句"穿着图中这款服装",单写文字描述衣服是画不还原的。
为什么跑出来的模特手总是畸形?
动作幅度大的口令手崩率明显高,我这边的记录是三成上下。避免复杂手势、单次只改一个大项,能压掉大半。
一次口令能同时换场景和动作吗?
不建议。单张图一次改一个大项,叠加改动等于让模型自由发挥,6月我贪心叠加那次手指崩了三根。
跑通的口令可以复用到下一个款式吗?
可以,我攒了40多条按体型场景动作归档,换款只改服装颜色那一段。底图曝光正常是复用的前提。