ai模特拿着产品总穿模?手持图三条铁律
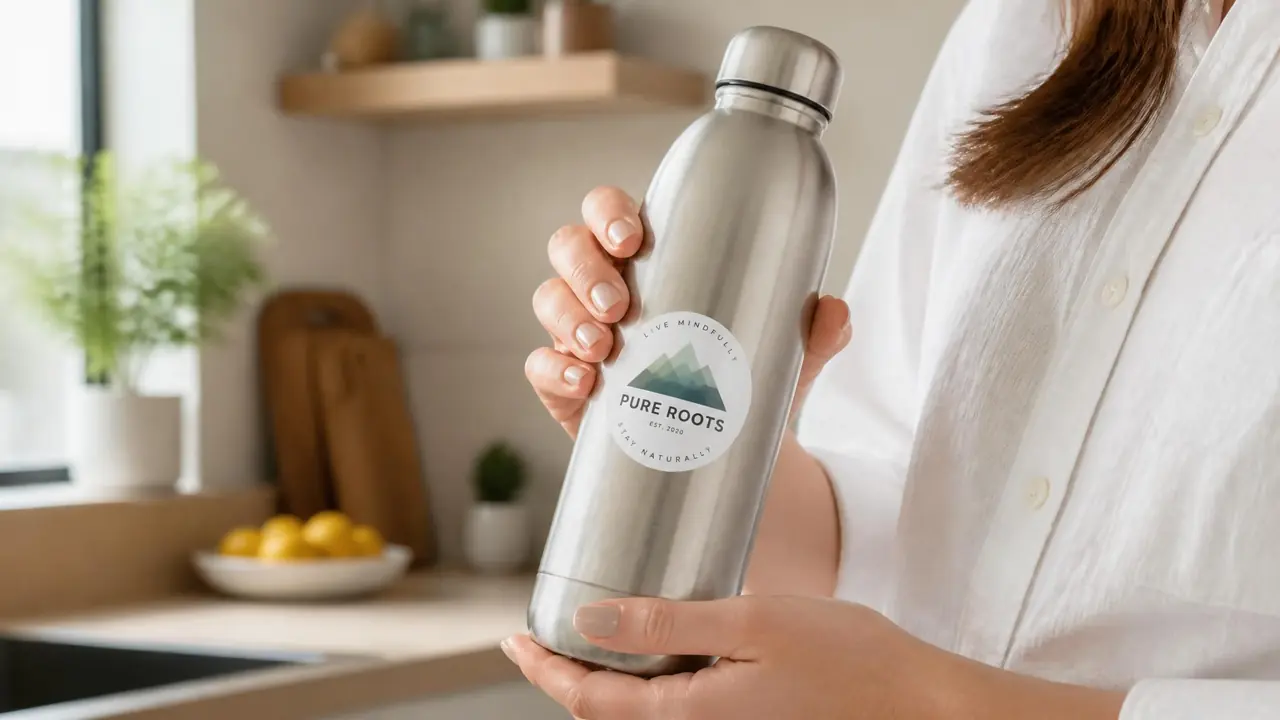
一句话版本:ai模特拿着产品,手和产品接触的位置要当独立工程来做——先给握持点写死描述,产品用白模图垫底,标签朝向单独交代,成品率能从三成拉到八成。
我在深圳做亚马逊家居小件,水杯、香薰机这些产品全要手持场景图。实拍一组四百起,AI一张几毛钱,前提是你得知道手怎么保。
ai模特拿着产品这类图,我第一回做的时候天真得可笑。提示词写"模特手持保温杯",出来二十张,十八张的手指直接长进了杯壁里,剩下两张杯子成了椭圆的歪葫芦。那晚我悟了:手持图的重点根本不是模特,是那只手和产品的物理关系。
手持图崩,都崩在哪三个位置
指缝穿模、产品轮廓变形、标签背对镜头,三处占了我废片的九成,每处都有对应解法。先看清崩在哪,再谈怎么修。
指缝穿模最常见,手指和杯身交界的地方AI会"融合",五根手指变成四根半。产品变形排第二,圆形杯口画成椭圆,直的吸管画弯。第三处最阴——标签问题。你辛辛苦苦把产品做对了,结果品牌标签朝后,或者干脆没了,主图等于白做。
我统计过8月的91张废片:穿模占41张,变形占33张,标签朝向错了17张。数据不会骗人,解法就得一条条对着来。
握持点写死,废片直接砍半
提示词里把握持方式写成完整句子——哪根手指贴哪里、手掌角度多少,越具体越不穿模。试了四十多组描述,我固定下来三条最好用的写法。
第一,写"手指自然环绕杯身,指节分明,不与杯体重叠",光这一句就把穿模从四成压到一成半。第二,写接触关系而不是动作,"指尖轻触瓶盖边缘"比"拿着瓶子"稳得多,模型对"触"的理解比对"拿"精确。第三,单手比双手稳,双手持物AI经常画出六根手指,我现在只有大件产品才敢用双手构图。
出图速度也给你个数:单张22秒左右,一批40张跑完约一刻钟,能用28到32张。这个成品率对家居类产品图来说,成本已经低到可以随便试错的级别了。
产品本体,白模垫图比提示词管用
想保产品不变形,垫一张产品白模图比在提示词里堆形容词有效十倍,标签细节靠后期合成兜底。这是我这半年最大的心得。
光靠文字描述,AI对"瓶身正面印有渐变蓝色logo"这种话的理解全凭运气。后来我改成图生图:产品白底图垫底,权重拉高,模特部分靠提示词生成。杯型立刻正了,瓶口圆的就是圆的。代价是构图自由度下降,模特姿势基本围着产品转,但主图要的不就是这个吗。
标签怎么办?跟做印花T恤一个思路:AI出图时标签区域留白,后期把logo素材贴回去。一张多花四分钟,换来的品牌细节是AI永远画不准的。我这批杯子48张主图,标签全部后期合成,平台审核一次过。
收纳盒这类方形产品我再补一句:方物比圆物好画,棱角给了模型参照,废片率比水杯低一截。9月那批收纳盒60张,穿模的只有7张。要挑毛病的话,方物的阴影容易画重,AI爱在盒底抹一大块死黑,后期统一提亮一下就好,批量处理用动作录制,一晚上能清完。
出错的活儿也有。有一批香薰机图我偷懒没垫白模,想着提示词写细点就行,结果60张里型号旋钮的位置全是AI瞎编的,跟实物对不上,整批重做。垫图这道工序,省不得。
现在组里新来的运营,我都先让他照这三条铁律跑两百张练手。手感和判断这东西,看十篇教程不如亲手废一百张图来得快。
对了,场景图和主图的分工要分清。我给不同用途配不同出图策略,之前记过一篇讲一件衣服配出八套图的操作(ai模特服装搭配实操:一件风衣怎么配出八套图),那个多角度拆解的思路搬到手持产品图上一样好使——一张白模垫底图,能衍生出桌上、手里、背包装态好几个场景。
现在我的新品上架流程里,手持场景图已经完全不需要影棚了。上一款香薰机从白模到48张场景图,两天搞定,总成本不到50块。AI不是替你思考,它是把你脑子里的画面变便宜了——前提是那只手,你得亲手教它怎么长。
常见问题
ai模特拿着产品的图,手指穿模还有救吗?
轻微穿模可以局部重绘,把幅度压到0.3以下重画手部区域。严重穿模建议换提示词重来,重点把握持关系写成完整句子,比如"手指自然环绕杯身,不与物体重叠"。
产品标签上的小字能被AI画对吗?
基本画不对,两三个字以上的标签文字正确率很低。成熟做法是AI出图时让标签区域留白,后期贴原始logo素材,顺手加透视变形和环境阴影。
白模垫图会不会限制模特姿势?
会有影响,模特动作基本要配合产品位置。但主图和场景图本来就该突出产品,这个限制反而帮你避开了构图跑偏的废片。
手持产品图适合哪些类目?
水杯、香薰、小型家电、美妆工具这类需要展示握持感和使用场景的品类最合适。服装类不需要手持图,重点在穿着效果,思路完全不同。