看懂ai模特算法在画什么,就知道模特图的手为什么总崩
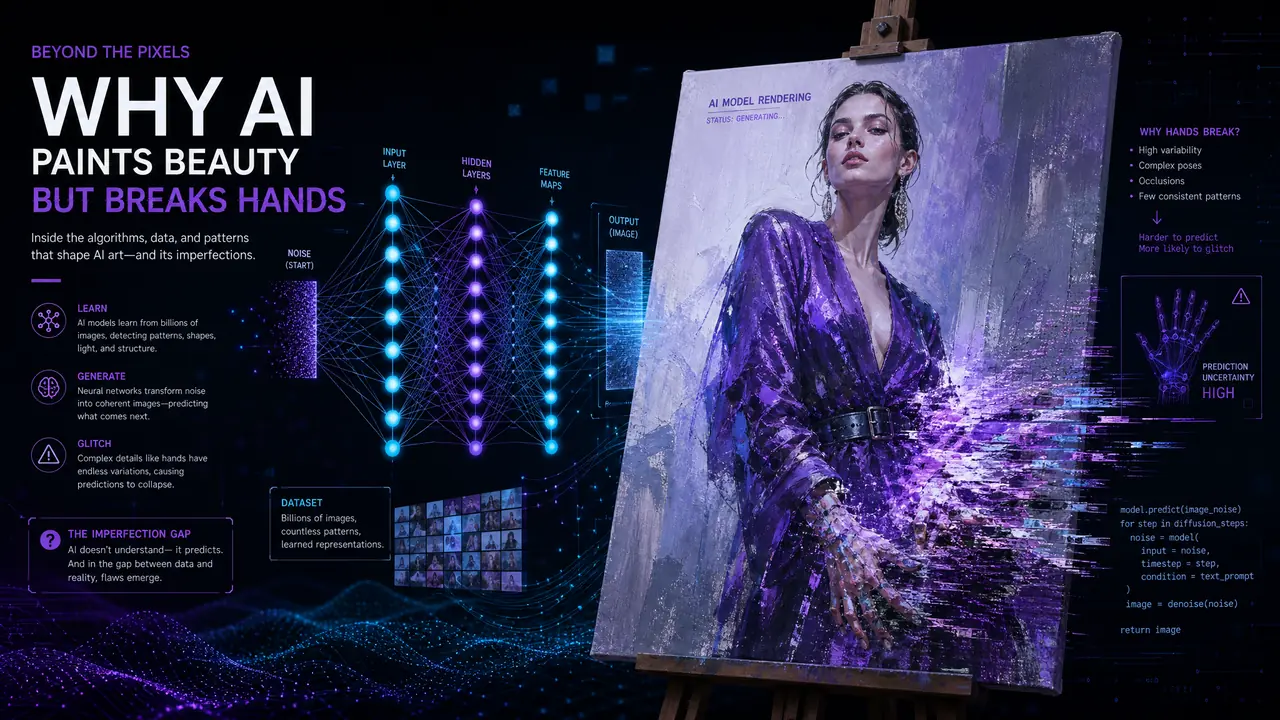
说重点:ai模特算法不是在「画」人,是在噪点里逐步擦出一个统计上像人的图。手部六指、耳朵错位这些崩,源头在算法层,修图笔刷救不了,换种子和局部重绘才对症。先把原理捋顺,再谈流程。
先把我最想传达的一句放这儿:崩图不全是你的问题。9月我把自己一个月的做图记录翻出来算了算,100张电商模特图里,手部异常31张、耳朵和饰品错位14张、左右衣领不对称9张。我中途怀疑过自己是不是词没写对,把提示词改了四五版,比例几乎没动。后来去啃了点资料才明白,这类崩坏长在算法的骨子里。
这篇不讲公式。我按做图人的视角,把扩散模型的原理讲成能对照自己翻车经历的话,再给一张我自己记的崩图账:哪类能救、救活率多少、哪类别犹豫直接重抽。原理看懂了,你看到崩图第一反应会从「我哪错了」变成「这是算法层的,走重绘流程」,心态和效率都不一样。
扩散模型两步走:先捣碎,再学着擦
出图是一个去噪过程:模型从一团随机噪点里,按训练时学到的统计规律,一步步擦出人像。它认识「合理」,不认识「正确」。
训练阶段做的事,打个比方:把千万张人像照片一层层加噪点,捣碎成一团雪花屏,让模型记住每一步「擦掉一点噪点之后图应该长什么样」。出图阶段就反过来,从纯噪点开始,一步步往回擦。所以它不是先想「这是个人」再画人,是擦着擦着,人「浮现」出来了。
我自己的理解是个类比:隔着磨砂玻璃认人。玻璃越擦越亮,轮廓先出来,然后是五官,最后才是毛孔这种细节。这里有个关键——模型每一步都在猜「下一个更清晰的画面最可能是什么」,它对「看起来合理」有执念,对「到底对不对」没有任何概念。手为什么难画?因为手在训练图里形态千变万化,握拳、比心、插兜、扶眼镜,模型学到的是「手有很多种样子」,五根手指这条硬约束它反而记不牢。台阶、乐器、眼镜腿,同理。
明白这点,很多现象就通了。为什么一张图里发带左边蓝右边黑?因为模型不维护「全局唯一」这种账本,它只保证局部看着顺。为什么脸看着还行、镜子里的倒影是另一个人?倒影区域是单独「擦」出来的,没人保证它跟主脸是同一位。
崩图清单:哪类能救,救活率多少
手指、耳朵、饰品、镜像这四类崩是算法层的,修图笔刷治标。我的账本:手部局部重绘救活约八成,耳朵五成,反复崩就换种子。
9月那100张的账我分了类记。手部异常31张里,重绘蒙版框住手部重新生成后,24张救回来了,救活率七成七。耳朵和饰品错位14张,救回来7张,五成。左右衣领不对称9张,救回来6张。剩下救不回来的,全是同一个部位崩两三次不收敛的,换种子重抽比跟它死磕快。
有一类我单独拎出来说:多人同框。给情侣装店出图那阵,双人同框10张里能崩6张,崩法五花八门——两只手四条胳膊、脸互相串、身高比例离谱。这不是参数没调好,是两个人物在去噪过程里互相「污染」对方的统计。我的土办法是单人分着出,后期合成,合法又稳。
还有个反直觉的:把步数拉满,崩图不一定少。我9月试过20步和40步各抽50张,手部崩率一个29%一个27%,差别在误差范围里。步数影响的是细节细腻度,不解决五指问题。想靠堆步数治崩图的,省省电费吧。
看懂原理后,我的流程改了三处
先小图抽构图再放大,结构词写在风格词前面,每天按三成比例预留重绘时间。改完单张交付从35分钟压到22分钟。
第一处,出图顺序。以前直接出大图,一张两分钟,崩了重来,时间全喂给重抽。现在1024的小图先抽10张选3张,构图和姿态定了再放大精修。小图便宜,抽卡成本低,崩图概率还不变,这笔账怎么算都划算。
第二处,词的顺序。结构性的描述——站姿、手在做什么、镜头距离——放在前面,风格词放后面。原理上,越靠前的词在去噪早期就被「擦」进轮廓里,越靠后的越影响不到骨架。改了顺序之后,我想要的姿势命中率肉眼可见地高了,9月下旬那批,姿势一次过的比例从一半升到七成上下。
第三处,心态和排期。账本摆在那,三成崩图率是常态,我接单报价时就把重绘时间算进成本,一天8小时的活按11小时排。以前崩一张急一张,现在崩一张按流程走:先局部重绘,两次不收敛就换种子。活还是那些活,人不焦了。
ai模特算法这套东西,说穿了就是个「统计意义上的人像复原器」。它不知道人有五根手指,也不知道倒影里该是谁。知道哪些崩是算法层的,你就不会再跟修图笔刷较劲,也不会再怀疑自己词穷。流程顺着原理改,时间自然省下来。
常见问题
同一个提示词加同一个种子,两次出图还是不一样,为什么?
我实测过,部分平台的采样实现里,批次内并发出图或后端版本更新都会让结果漂移,种子只是起点,去噪每一步的计算细节平台随时可能调。想要可复现,把整组参数截图存档,出图前后各存一次,交付对不上号时至少有据可查。
提示词里写「五根手指」能减少手部崩吗?
我9月试了一周,正反两种写法都试了,崩率基本没动。模型学的是画面统计,文字约束改变不了它对手的理解。真要控手,要么手部动作写得极其具体,比如「双手自然下垂」,要么靠后期局部重绘,别指望咒语。
模特脸出多了总长得很像,是不是模型的问题?
是。模型有自己的审美中心,出图越多越往中心收,业内叫趋同。我的办法是给脸部描述里留两个「偏离项」,比如 specific 的眉形或雀斑,把脸从中心拽开一点。另外隔一阵换一组底层风格词,也能换换基因库。
局部重绘的蒙版边缘总有接缝感,怎么压下去?
蒙版别贴着崩点框,往外多留一圈完整结构,比如修手就把手腕一起框进去,让重绘区域有过渡的余地。羽化开到两三成。我现在的蒙版尺寸基本是崩点区域的两倍大,接缝感基本看不出来了。