ai模特文本提示词怎么写?同一件衣服我改了6版描述的差别
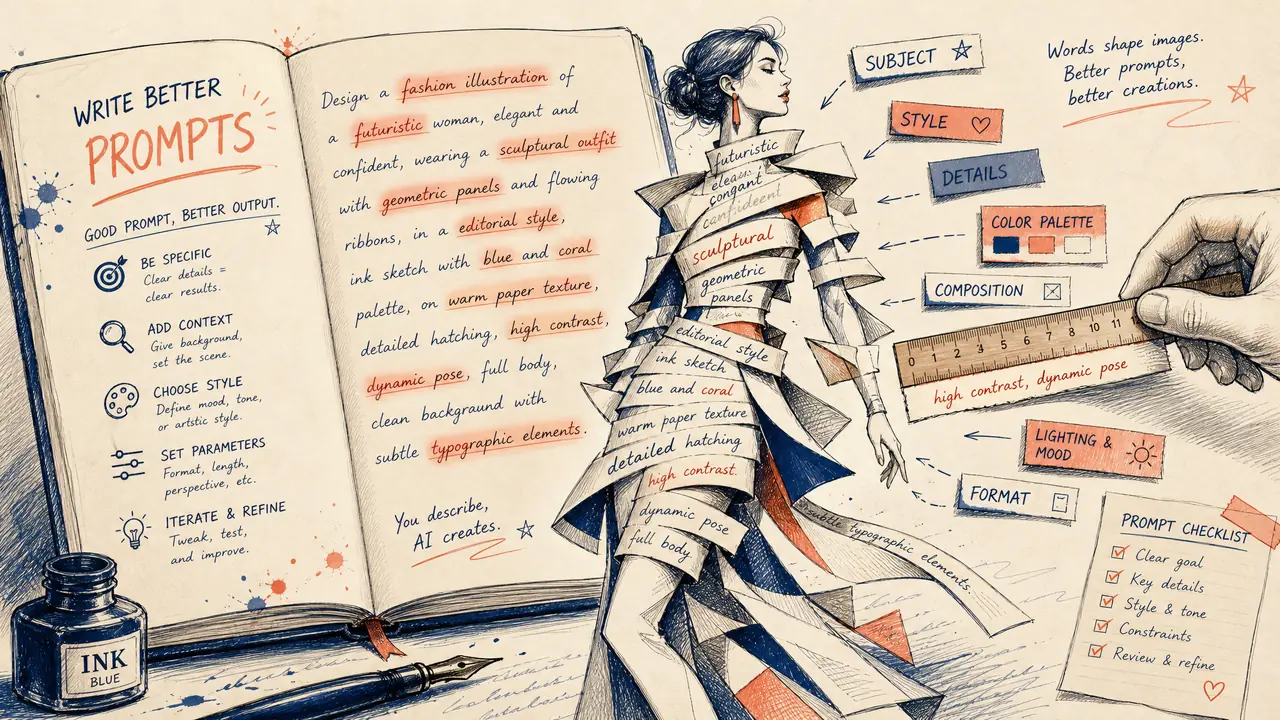
一句话讲透:ai模特文本提示词决定下限,参数决定上限,描述写不准,参数调到冒烟也没用。同一件衣服我改了6版描述,可用率从20%干到80%。
ai模特文本提示词这事,很多教程把它写成了玄学:一堆咒语让你背,背完照样出废图。我的体会相反,提示词没什么神秘的,它就是一个"给画师下需求"的过程,你跟真人画师怎么沟通,跟AI就怎么写。
为了验证这个想法,我拿一件深灰西装外套做了个对照实验:同一套参数不动,只改文本描述,前后改了6版,每版出24张,记录可用率。结果比我想象的夸张,最好和最差的版本差了四倍。下面把6版改了什么、结果差在哪,全部摊开。
6版描述对照:改对一处,可用率翻一倍
描述的优先级是版型结构、量化数据、材质光泽,最后才是氛围形容词,形容词堆得多不等于图出得好。
第1版我随手写的"高挑女模特穿深灰西装,时尚大片感",24张里能用5张,模特年龄感飘忽、西装版型五花八门。第2版把"高挑"换成"身高172厘米、肩宽适中",可用率上到10张。第3版补了"单排扣、平驳领、落肩设计",西装的结构终于稳定了。第4版加材质"哑光羊毛混纺、垂坠感",第5版写了光线和背景,第6版精简掉所有无效形容词。
| 版本 | 改动点 | 24张可用数 |
|---|---|---|
| 第1版 | 随手写,形容词为主 | 5张 |
| 第2版 | 身材改量化数字 | 10张 |
| 第3版 | 补版型结构词 | 14张 |
| 第4版 | 补材质与垂坠描述 | 17张 |
| 第5版 | 补光线场景描述 | 19张 |
| 第6版 | 删冗余形容词 | 20张 |
这张表里最有价值的信号是第6版:删词也能提可用率。我原来在末尾堆了一串"精致、高级、大片质感",删掉之后AI反而不再往"精修海报"方向发挥,图片更接近实拍。描述不是越长越好,每个词都要干活。
量化是文本提示词的分水岭,形容词靠边站
"高挑""纤细"这类词AI只能猜,身高、肩宽、裙长到膝、条纹间距半厘米这类数字描述才能锁住结果,能换算成数字的词都该换。
为什么量化这么有效?我的理解是形容词对应一个巨大的模糊区间,"高挑"可以是165也可以是180,AI每次落点不同,出图自然飘。数字把区间压到一个点附近,波动立刻收窄。现在我写描述有个习惯动作:先问自己这个词能不能换成数字,能换就换。
有些属性没有现成数字,就造相对描述。"裙摆到模特小腿中段""袖口盖过手腕骨",这类定位词比"合适长度"管用十倍。版型相关描述写不准是合身度翻车的主因,我把排查过程整理在ai模特指定衣服总不合身?版型和垂坠感才是真正的关卡这篇里,和本篇的方法是配套的。
负向提示和片段库,两个提效的小机关
负向提示负责排除高频废图形态,片段库负责把你验证过的描述沉淀下来,一个管下限,一个管效率。
负向提示是我救废图的第二道闸。我常用的一组:多余的手、粘连的手指、扭曲的衣领、水印、模糊。加上之后手部崩图明显变少,一批能多救回三四张。这东西不是咒语,就是把你翻过车的地方逐条列出来,让AI绕着走。你踩的坑和我不一样,你的负向表就该照着自己的翻车记录写。
片段库是长期最划算的投资。我把验证过的描述拆成四段存在备忘录里:身材段、版型段、材质段、场景段,出图时按品类拼装。比如针织品类就是"身材段加针织特性段加室内场景段",拼完微调两个词就能出图。半年攒下来,我现拼一套描述只要两分钟,新手从零写要二十分钟还不稳。
维护片段库有个小纪律:每次出图如果发现某个词表现异常,回来就改库里的对应片段,别在拼装时临时救。库里的片段永远是验证过的版本,出了问题修库,不出问题不动它。就这么一个小习惯,让我的描述质量半年里只升不降。
回到那件深灰西装:6版实验之后,同参数下20/24的可用率已经接近工具的实用上限。文本提示词的价值就在这里,它不花一分钱,只花你写描述的十分钟,却决定了后面每一张图的起点。先把词换成人话、换成数字、换成结构,再去谈玄学咒语,顺序别反。
常见问题
提示词用中文还是英文效果好?
主流模型两种都认,差别不大。我的习惯是中文写、关键服装术语附英文对照,比如"平驳领 notched lapel",个别术语英文响应更准。别为了玄学硬翻整段英文,浪费时间。
同一段描述两次出图为什么差别很大?
生成过程带随机性,同样的描述每批都会有波动。要复现某张好图,除了描述,还得把种子值、参数一起固定下来,三样齐了才能稳定复刻。
要不要去抄别人公开的咒语模板?
可以参考结构,别整段照搬。别人的模板里长款大衣的描述套到短款卫衣上就是灾难。抄回来先拆段,换成你自己品类的量化描述,才算真会用。
描述里写明星或者品牌名能提质感吗?
不建议。既有肖像和商标的合规风险,效果也不可控,AI会往那个明星的形象上靠,你的衣服反而成了背景。质感靠材质词和光线词堆,不靠人名。