模特转场AI指令怎么写:两帧图出换装大片
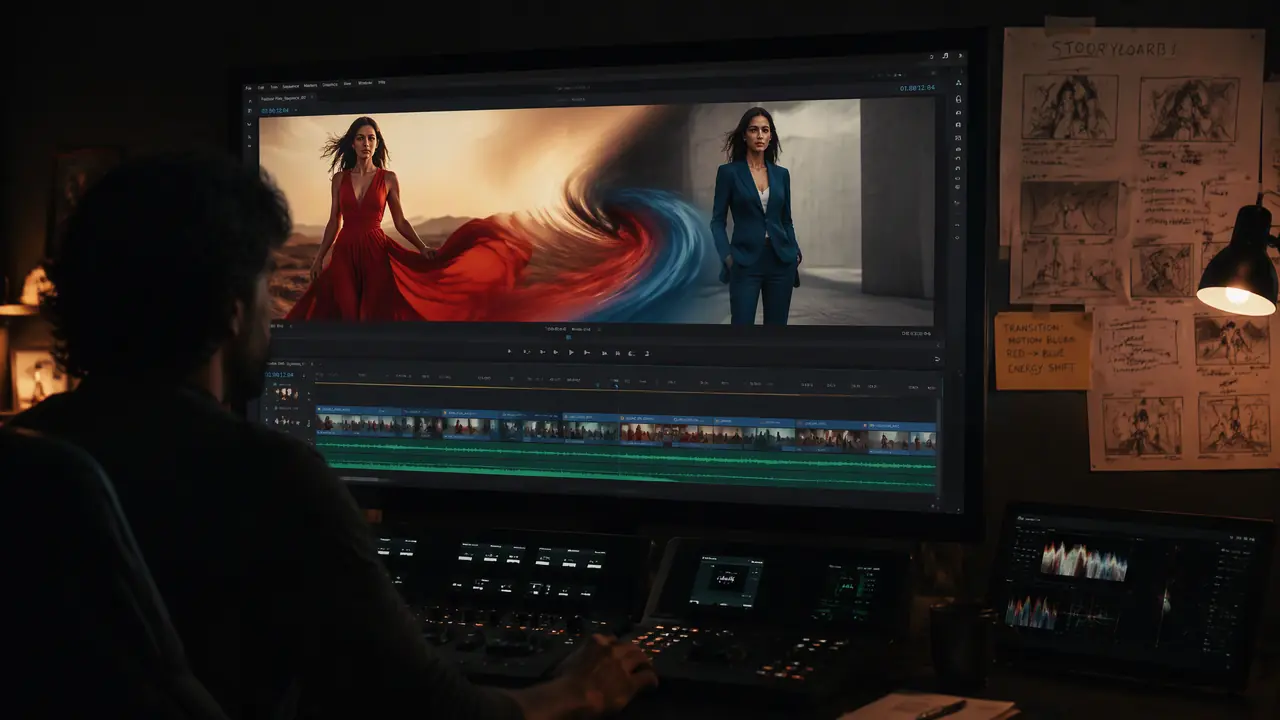
我的判断:模特转场视频崩不崩,七成看首尾帧两张图控制得好不好,指令只占三成——图选对,指令一句话就够。
下面五条指令模板我各跑过几十条,崩坏率数据全给了,照抄能少熬两个通宵。
写模特转场AI指令这件事,我一开始也是绕了大弯的。头一个月我把指令写得跟论文一样,动作分解、镜头语言、情绪描述全塞进去,出来照样崩。后来把两张首尾帧图的控制做严了,指令反而越写越短,成片率从三成爬到七成往上。这个教训值得先讲:指令是缝补两帧图之间的针线,不是全能的画笔,针线再花哨,布料不对也是白搭。
转场视频的原理,两帧就够
给视频模型一张首帧一张尾帧,中间的动态它自己补,指令只需要说清"怎么从A到B",别抢画面的活。帧图越稳,补间越顺。
首帧尾帧怎么来?我全部用AI出图:同一位模特、同一机位、同一布景,只换衣服或姿势。这里有个前提,两帧里的模特得是同一张脸同一个发型,差一点观众就会觉得中途换人了。我出两帧图的习惯是先出首帧,锁定参数后再微调提示词出尾帧,这样两帧的底子最接近。顺带说一句,如果两帧要换的是整套衣服,换装图本身的功夫不能省,模特换装图ai三种换法实测里的参数笔记正好用在这。
两帧图出完先做一件事:并排放着盯十秒。脸型、发型、背景家具的位置,任何一处肉眼可见的偏差,到了视频里都会被放大成穿帮。我有个文件夹专门存配好对的帧,命名写清首尾和款式,攒到二十多对之后,出片速度明显快了,赶工期那周全靠这个库续命——素材库这东西,视频和图片一个道理,早囤早受益。
五条指令模板,附实测崩坏率
旋身换装、走位遮挡、灯光切换、甩裙摆、推近镜头,五条模板按崩坏率从低到高排,动作越简单越稳。每条都是我拿五十条以上的生成量换来的。
崩坏率最低的是灯光切换,指令写模特站定不动,灯光从冷白过渡到暖黄,我跑了六十条,崩了四条,稳定性天花板,适合做开场。走位遮挡次之,写模特向右走出画面,再换装走回,五十条崩七条,接缝藏在出画那一瞬。旋身换装排中间,写模特原地旋转一圈,旋转结束时衣服变为另一款,五十条崩十二条,崩的都在手部。甩裙摆和推近镜头崩得最多,别超过两成预期。哦对,推近那条实际是运镜不是换装,我拿它做款式的悬念开头,效果意外地好,客户审片那关都没卡过。
时长也有讲究:全部控制在五秒以内,三到四秒最优,五秒封顶别越线。转场是节奏件,拖长了观众划走的速度比你想象快。我自己的交付标准是一条片子里转场不超过两处,多了晕,留一处高光就够撬动完播率。
三个翻车规律,比指令本身值钱
两帧差异越大越崩、动作幅度越大越崩、单条时长越长越崩,三个变量全都往小了控,成片率立刻上去。这是我用几百条废片喂出来的规律。
两帧差异怎么量化?我的土办法:两帧之间只允许一个变量变化,换装就不换姿势,换姿势就不换布景。有回我贪心,首帧站着尾帧坐着还换了套装,跑八条崩八条,条条手部糊成一团。动作幅度同理,旋转一圈的崩坏率是半圈的接近三倍,能走位遮挡就别转圈。贪心是转场最大的敌人,我在这上面没少交学费。
还有个容易被忽略的点:转场条条都崩的话,先查两帧图的光线差。我遇到过一批怎么跑都崩的,回头看是尾帧不小心改了光位,改回来立刻顺了。机器不会错得无缘无故,先自查原料。
指令语言也提一句。我中英文都试过,同一个模型的同一批帧,两种语言出来的动态没有稳定差距,真正拉开差距的是动作描述够不够单一。别写模特优雅地转身微笑然后裙摆飞扬这种复合句,一句一个动作,崩了也好定位是哪个环节的问题。
从论文式指令到一句话指令,我走的弯路就当替你踩了。今晚挑两条模板,先出稳住的两帧图,再跑五条转场,明早你手里大概率就有能直接发的片子。转场这东西练的是克制,克制的运营出片最稳,这话我逢人就讲。
常见问题
没有视频生成额度,能先练什么?
练首尾帧图。把两帧图的稳定性做出来,额度恢复后直接进生成环节,转场的成败大头本来就在图上。
转场视频发主图视频还是详情页?
我发在详情页视频位和店铺短视频动态两边,主图视频要求展示商品全貌,转场类更适合讲氛围和上新,各归各位。
两条转场能连着剪一条吗?
能,我的常规操作是灯光切换开场加旋身换装收尾,中间夹三张静帧图,一条十五秒的短视频就齐了,节奏刚好。
崩坏率低于多少值得继续跑?
单条模板崩坏率超过四成就别硬磕了,要么换模板要么回头查两帧图。时间是成本,五条废片的时间够你换一条稳的路子。