ai豆包生成模特的口令写法:大码男装店主逐条拆解
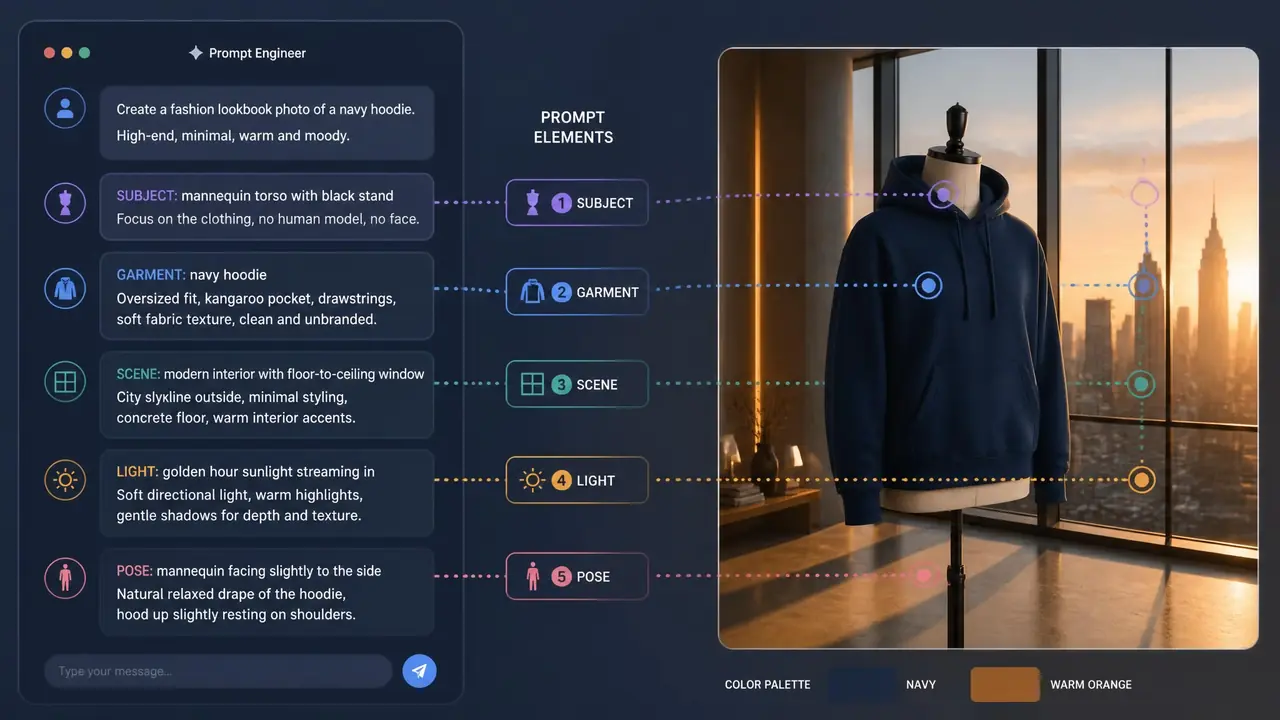
结论挺出乎意料:ai豆包生成模特,工具不是瓶颈,口令才是。我把半年大码男装攒下的口令按五段式骨架逐条讲:大码专门写法、长度坑点、顺序讲究,一条条讲透,男装店主看完就能上手改自己的口令。
ai豆包生成模特的用法,我前后琢磨了半年。做大码男装的都懂一个痛:普通模特图撑不起XL到4XL的衣服,买家最常问的就是"我180斤能穿吗"。与其反复解释,不如让图自己说话。结论先给:口令写得像样,免费工具也能出商用的图,写不像样,付费工具也救不了。
我的店主做大码男装,春季那批卫衣是我第一次成体系地用AI出图。五十多个SKU,从口令写得一塌糊涂到形成模板,中间废了不下两百张图。这篇把摸索过程里口令部分的干货全倒出来。
为什么盯着豆包不放?说穿了就两个字:白嫖。大码男装利润薄,图又是消耗大户,能省则省。半年用下来,它对中文长口令的理解比我预想的好,当然毛病也不少,后面都会讲。
口令的骨架:五段式
好用的口令是五段式:主体(谁)、服装(穿什么)、场景(在哪)、光线(什么光)、姿态(干什么)。每段一句话,顺序别乱,一段管一件事。
拿我的一条真实口令举例:"三十岁微胖男性,短寸头,穿深灰色加绒卫衣,码数宽松但不显臃肿,站在落地窗前,午后侧光,双手插兜看窗外。"五个信息块一口气交代完,出图基本能直接用。
顺序为什么重要?我试过把光线放最后,图的光线时对时错;挪到姿态前面,稳定多了。我的理解是模型按顺序分配注意力,重要的信息靠前放。这个说法未必严谨,但实测有效,你照做就行。
大码身材的专门写法
大码出图必须写清身材程度和衣服的合身关系:"微胖""壮实""肚子微凸"比"胖"有效,还要写明服装是宽松还是修身。不写清楚,模型一律按标准身材画。
最早我只写"胖男人",出来的图要么夸张变形,要么干脆还是标准身材。后来改成"体型壮实、肚子微凸、肩宽背厚"这类具体描述,图一下就对了。买家看图的心理很微妙:身材要真实到"这就是我",又不能真实到让人不适,这个度要靠词去卡。
服装的合身关系也要写。"卫衣在身上宽松但不拖沓""裤腿堆在鞋面"这种描述,直接决定买家对版型的预期。有一批图我没写合身度,出来全是修身效果,客服被问了一个星期的"有加大码吗"——衣服明明就是加大码,图骗了人。
还有一个词要避:模特长相别写明星。试过一次写了某个演员的名字,图是有那么点意思,但那批图我全压着没敢用,肖像的事说不清。写"短寸头、圆脸、有胡茬"这种特征就够了,安全又一样出效果。
口令长度与顺序的坑
口令不是越长越好:超过一定长度,末尾的信息会被忽略,我实测超过一百二十字后段要求基本作废。写不完的细节,分两次生成再合成。
翻车案例直接给你。有次我在口令末尾补了"注意袖口螺纹要完整",结果图里袖口照样糊。把这句挪到口令中段,一次就出来了。从那以后我给自己定了规矩:单条口令不超过一百二十字,最重要的约束放中前段。
还有个反直觉的发现:负面描述尽量少用。"不要畸形的手"这种写法,有时反而诱导它画畸形的手。稳妥的办法是只写你想要的:"双手自然插兜"。叫它干什么,比叫它别干什么管用。
模板送你一条,直接抄:年龄段加体型两三个具体特征,服装名加颜色加合身描述,场景一句话,光线一句话,姿态一句话。先照抄,出十张图之后再按你的类目改词,改着改着就是你自己的口令库了。
我的口令库另一条经验是按季节分文件夹。冬装口令里"哈气、围巾、暖光"这些词,夏天照搬就是灾难,分开管,换季时效率高得多。库要养,别指望一条口令吃遍天。
半年下来,我的口令库攒了一百四十多条,按体型、场景、季节分了类,新链接上架直接调模板改三个词。回头看最早那些废图,问题从来不在工具笨,在我话没说清。跟AI打交道跟带徒弟一个理:你说得明白,它就干得明白。
常见问题
豆包生成模特的口令有固定结构吗?
我总结的是五段式:主体、服装、场景、光线、姿态各一句,顺序按这个来。重要的约束放中前段,实测出图更稳。
大码服装的模特图怎么写口令?
身材写具体程度,比如"壮实、肚子微凸",别只写一个"胖"字;再写清服装合身关系,宽松还是修身直接决定买家预期。
口令写多长合适?
我实测超过一百二十字,末尾要求基本被忽略。写不完的细节拆成两次生成,或者干脆砍掉不重要的。
口令里写"不要什么"有用吗?
多数时候没用甚至帮倒忙,"不要畸形的手"可能诱导畸形。改成正向描述,写你想要的样子,"双手自然插兜"比否定句管用。