ai走台模特出图与视频:婚纱店虚拟秀场的做法和坑
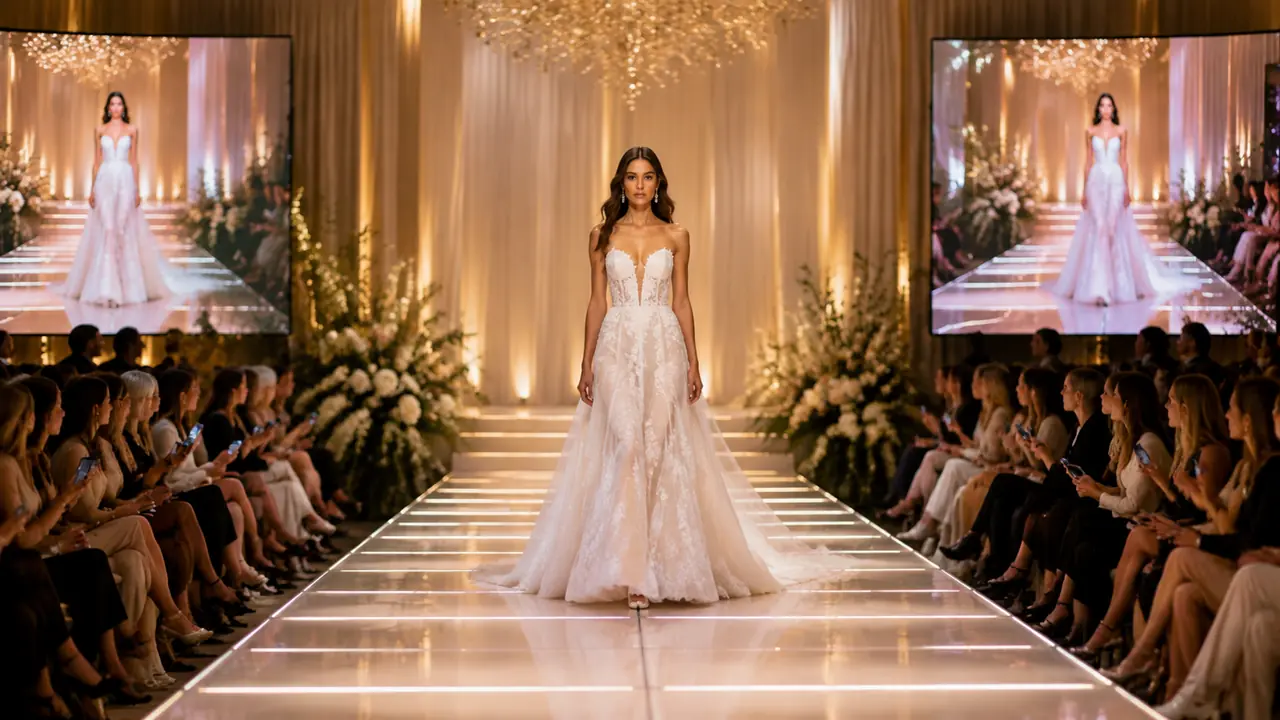
开门见山,直接上干货:ai走台模特的静态图及格容易,视频是真正的分水岭。T台透视立住、台步不滑、裙摆会飘,三样齐了才敢叫秀场,缺一样都像幻灯片。
ai走台模特这件事,我家婚纱店做了两季。在苏州做批发,以前每季上新要办一场小秀请客户来看,场地加模特一场六千起,去年换成AI虚拟秀场,一场压到六百,图和视频全是AI出的。省钱是真省,坑也是真多,这篇从静态图写到视频,把我的踩坑记录全摆出来。
办秀这笔账再摊细一点:场地、模特、灯光、茶点,一场下来六千挡不住,客户坐前排,后排的看屏幕。虚拟秀场反而人人看得清,客户在手机上看视频的完成度,比现场后排强,这个反差让老客户很快就接受了。
静态T台图:透视和台面先立住
T台图先立透视:台面的消失点、两侧灯位的对称、地面的反光三样对了,秀场感才有八成。
T台图最容易假在台面上。消失点一乱,台面像斜着漂的,模特像站在斜坡上走秀。我的提示词固定写:正面机位、台面透视对称、地面带轻微反光。地面反光这条很关键,秀场的T台是亮面材质,没有反光的台面像水泥地,气氛全无。
灯位也要守规矩。T台是顶光加两侧追光,模特脸上会有顶光特有的眼窝阴影,这是秀场氛围的一部分。我试过把脸补得像棚拍一样平,客户说"没了那股子劲儿",从此不再补平,留住顶光的戏剧感。
观众席用虚化处理。两侧的买手和镜头给一层暗调虚化,主体更突出,还省得AI把观众的脸画崩。全场图我只保证模特是清晰的,其余元素一律往氛围里推,这个取舍让定版速度快了一倍。
图生视频:台步不滑步的三道参数
视频防滑步盯三处:步频写慢不写快、镜头跟随要缓、单段时长压在十五秒内,贪长必糊。
静态图转视频,滑步是头号杀手。模特上半身在走,脚在地上蹭,像踩着隐形滑板。我的经验是把步频放慢,写"缓步、每步间距小",AI没能力处理快节奏的连续动作,慢动作它反而稳。十五秒的单段时长也是铁律,超过这个长度,肢体细节开始融,裙子先糊。
镜头运动要克制。推拉摇移全上,画面必崩,我的视频里镜头基本只做缓慢推进或者固定,让模特动、镜头稳,成片才有"摄影机在旁边"的真实感。有一版我加了环绕镜头,出来模特的脸转了三次型,全废。
踩空是第二常见的崩点。AI对台面边缘的理解不稳,脚步偶尔踏出台面悬在半空。出片后我逐帧看脚部接触点,十秒的视频逐帧过也就一分钟,这活不能省,客户对视频的挑剔比图还狠。
多机位是省钱的秘密武器。同一套走姿出正面和侧面两段视频,剪在一起节奏感就出来了,客户以为请了两个机位,其实是一套参数跑两遍,工费一分没多花。
动态裙摆和走姿,礼服的生命线
裙摆动画宁小勿大:轻微摆动最稳,大摆裙的飞扬要在提示词里限制幅度,走姿给腰背发力感。
婚纱的视频,裙摆就是全部看点。可AI处理大裙摆的飞扬极易崩,布片撕裂、裙撑穿模都见过。我最后锁定"轻微摆动"档位,裙摆随步伐有小幅的起伏,克制,但每一帧都成立。客户挑片那天,她原话是"不动那么大反而像真秀",这句我记在了流程卡上。
走姿的发力感也不能缺。模特的腰背要有往上提的那股劲儿,肩线稳,胯部随步幅轻摆,这才是"走台"的体态。缺了发力感的走姿像散步,视频的调性就散了。提示词里写"腰背挺拔、步态带控制感"。
头纱是婚纱视频最难啃的部分。半透明的纱AI处理得飘忽,忽隐忽亮,我的办法是把纱写成"薄纱轻微飘动",控制幅度,再压一档透明度的变化,稳字当头。婚礼头纱的那组视频,光这块纱就试了六版。
音乐卡的节奏我单说一句:视频不配乐先给客户看动作,配了乐情绪会被音乐带跑,动作的毛病反而看不出来。先裸看,后配乐,顺序别反。
把开头的话收住:虚拟秀场这条船,静态图是船票,视频是风浪。透视立住、步子放慢、裙摆收着动,两季做下来,我的成本账从六千压到六百,客户续订的比例反而升了。想做这事同行,照这三关排自己的流程,至少别在滑步上翻船。
常见问题
虚拟秀场客户买账吗?
批发客户一开始将信将疑,看完视频版后多数认了,毕竟他们要的是看清版型动态。我们把视频和实拍细节图打包发,两样互相补位,续订率没掉。
一段十五秒的视频要跑多久?
生成十分钟上下,逐帧检查和重跑占大头,一条能用的视频平均折腾一小时。一场秀八段视频,我两天排完,实拍办秀的周期是三周。
静态T台图和视频哪个先用?
先出静态图定全场调性,图定了再转视频,方向不会跑偏。图都不过关就直接上视频,是把返工成本放大三倍的干法。