ai感知模特盲测实验:二十张图混进群里让人挑假
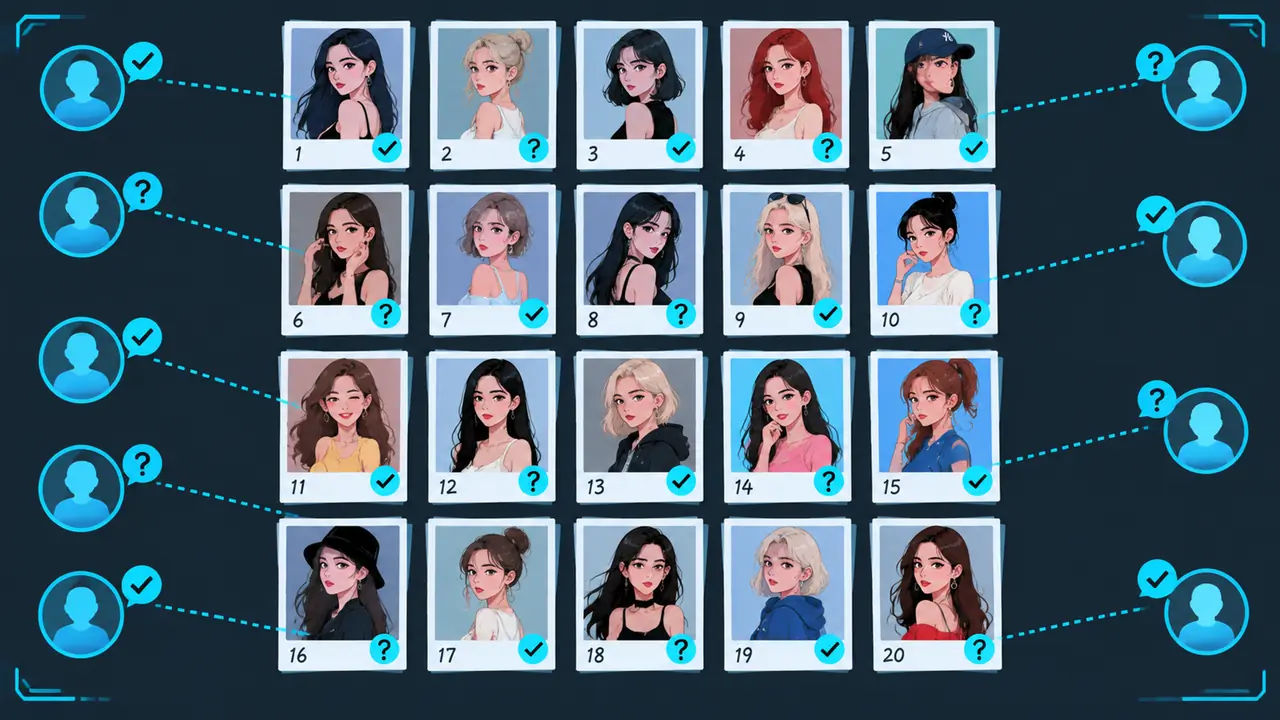
一句话版本:ai感知模特图能不能骗过人眼,我拿二十张图做了盲测,结论是脸早就不露馅了,露馅的是手、影子和地面。普通出图者把修图顺序倒过来,先查这三样,感知门槛立刻上一个台阶。
盲测是怎么做的:把图混进人群里
十张AI图十张实拍图混序编号,发进朋友圈和两个买家群,收回一百三十七张有效票。我是做工具测评的,横评写了一年多,各种跑分表格都做过——工具横评那套我自己也写过,模特软件ai怎么挑:一套素材横评四款工具的实测结果,参数摆得整整齐齐,可总有人留言问"参数再好,看着假有什么用"。这话把我问住了。参数测的是工具,感知测的是人,两码事。八月底我决定测人。
做法土得很。我挑了十张自己精修过的AI女装图,又从合作影棚要了十张实拍图,统一压成同样尺寸,随机编号一到二十,文字说明就一句:"哪几张是AI做的?写出编号就行。"发朋友圈,发两个我长期混的买家群。头一个小时票就来了五十多张,我盯着屏幕刷新,比看跑分刺激多了。有个阿姨在群里认真地说"我都放大到能看清睫毛了才敢下判断",还有个大哥全选了"都是AI",属于来捣乱的,票作废。 有个设计细节提一下:投票我没设奖励。一设奖励,大家就会去群里对答案,票就脏了。反倒是没奖的纯游戏,有人较真到半夜十二点还来私信补充理由,其中三条理由后来直接进了我的修图清单。人心这个东西,游戏化到一半最诚实的说法是——别用钱碰它。这算是我做测评以来最便宜也最值的一次"调研",成本约等于零。 给想复刻这套测法的朋友划三个重点。第一,样本别贪多,一百票上下就够看出大方向,重点是投票理由而不是票数本身;第二,图要压缩到同样的观感条件,一张8K一张糊图,等于作弊;第三,记录理由要有耐心,二十张图我能收到三百多条留言,逐条归到"手、光、脸、地面"四个筐里,归完规律自己浮出来。整套流程两个晚上能跑完,比写一篇横评快多了,结论却硬得多。结果改了我的修图顺序:脸最后,手最先
一百三十七票里,脸被挑中率不到一成五,手超过三成五,影子和地面关系最拉分,顺序得倒过来修。结果出来那晚我对着表格坐了半天。十个最准的投票者,只挑对七张;超过六成的人,准确率和抛硬币差不多。被挑得最狠的,是那张手扶栏杆的图——手指和栏杆的接触面发虚,票数里三成七的人点名了它。而大家以为最容易露馅的脸,被点名率不到一成五,其中一半还是碰运气点的。
最扎心的一条来自评论区的自由发言。好几个人没挑编号,只留言说某张图"说不上来的怪"。我逐张回查,发现他们说的全是同一类问题:影子。有张图人是下午四点的光,影子却是正午的短;还有张图人站在砖地上,砖缝在脚底下悄悄断了。这些毛病我自己看了几十遍都没看见,因为我的修图顺序一直是先磨脸——脸是我的舒适区,不是观众的敏感区。 票里还有条意外信息:有十二个人点名了两张根本是实拍的图。问理由,一个说"光线太完美了,不像真的",另一个说"现在实拍不都用AI修过吗"。你看,观众对"假"的定义已经变了,完美本身也开始被怀疑。这个信号对我冲击不小——以后修图可能得学会留一点不完美,一根乱发,一处轻微的皮肤纹理,反而是真人的证据。 盲测之后我把出图优先级整个倒了个个儿:第一查手和接触面,第二查光和影子,第三查地面延伸,脸排最后,有空再磨。改完的第一个礼拜不适应,总忍不住先点开脸看。忍了两周,九月那批图被挑出率降了一半。数据不说谎,虽然它说话挺难听的。 再补一个盲测之外的小发现。发图那几天,恰好有个女装店主找我出图,我顺手把她上一版详情页的图也拿给投票群看——那图是花钱请人修的,脸修得无可挑剔,可模特的手虚虚地搭在包带上,票里一半人点了它。店主看完票数统计,回了我一个字:"惨。"然后转了新单给我。这事让我确定,感知的坑不分AI图还是精修图,观众的眼睛不认出处,只认毛病。这场盲测我打算每季度做一轮,样本不用大,一百来票就够看清风向。感知这东西追不上,今天骗过人眼的图,明年可能一眼假——你测的其实不是图,是这个变化的坡度。有兴趣的也去混一场,票数会告诉你该把力气放哪。
常见问题
盲测会不会因为熟人猜心意而失真?
会有点,熟人知道我做AI图,可能故意反着猜。所以我在说明里没提AI两个字,只说"测眼力"。另外买家群的人不认识我,他们的票我单独算了一遍,和朋友圈的趋势一致,这才敢下结论。
普通卖家没有影棚资源,怎么做这种测试?
不用实拍图也行。把你自己的AI图按"你敢上架吗"来让朋友投票,敢与不敢之间那条线,就是你的感知门槛。五张图、二十个投票,半小时就有结果,比猜快得多。
盲测结果适用于所有类目吗?
不适用,这是我测完最想强调的。女装图大家盯手和影子,数码产品大家盯反光和logo,食品大家盯汁水和热气。观众的眼睛长在货上,你的盲测要用你自己的货来做,别人的结论只能参考方向。