视频模特换人ai两条路线怎么选?口型坑与授权红线实测
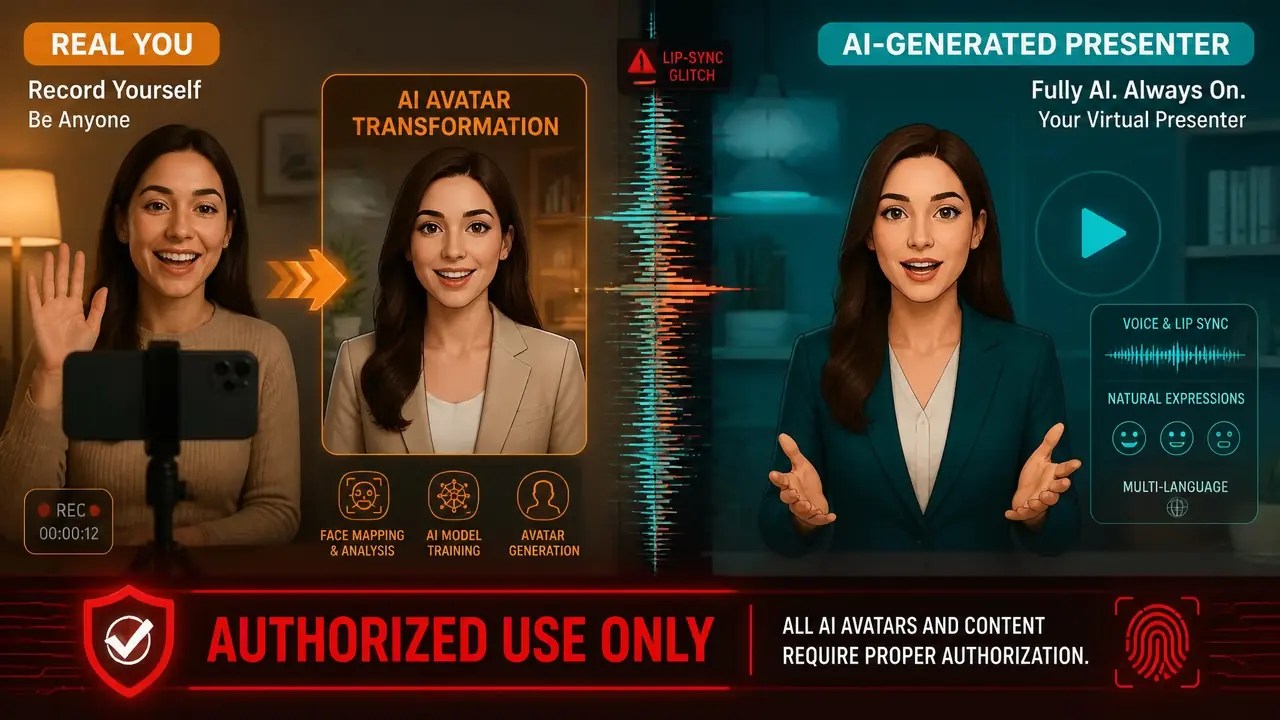
不兜圈子:想用自己的脸出镜,走授权形象(数字分身)路线,口播最稳;不想露脸,就直接生成虚拟人物出镜,表现力更自由。两条路线都得守住一条红线——形象必须是自己或拿到授权的。先定路线,再抠口型。
视频模特换人ai这件事,我九月整整折腾了三周:一批视频把自己的出镜录像换成数字分身,另一批直接生成虚拟人物来口播,前后跑了六十多条短视频,一次能直接用的不到一半。先给结论:带货口播、知识口播这类固定机位的视频,换自己的授权形象最稳;需要走位、转身、拿产品比划的展示类视频,虚拟人物路线反而省事。
你肯定也刷到过那种一眼假的数字人:嘴动得像在嚼东西,眼神飘,手势和说的内容对不上。问题多半不在工具,而在素材和用法。下面把两条路线、口型的坑和授权红线一次说清。
换形象和造虚拟人,差别比你想的大
授权形象路线是把你的真人录像转成数字分身,虚拟人路线是从零生成一个不存在的出镜者;前者口播稳,后者表现力强但可控性差。
授权形象路线的起点是录素材:对着白墙录一到两分钟,说话加自然手势,工具学完你的脸和声音,之后输入文案直接出片。我录素材那天重录了四次——第一次声音太小,第三次手势太多挡住脸,第四次才算合格。虚拟人路线更轻:写一段形象描述加文案,生成一个全新的人物,适合做店里循环播放的虚拟导购,或者不露脸的科普号。
对了插一句,虚拟人出镜和「人台实拍转虚拟模特」是两码事,后者是从真实底图改出来的,流程完全不同,感兴趣看这篇人台实拍转虚拟模特出镜的实测流程。费用上我算过一笔账:数字分身工具按年付折下来每月六十多块,随便出;虚拟人按条计费,一条三十秒大概三毛到一块,买点数包更划算。
| 对比项 | 授权形象替换 | AI虚拟人物出镜 | 我的评价 |
|---|---|---|---|
| 上手素材 | 1-2分钟真人录像 | 一段形象描述加文案 | 没出过镜的选右边 |
| 口播自然度 | 接近本人 | 偶尔有塑料感 | 要求高的选左边 |
| 单条30秒成本 | 约0.8-2元 | 约0.3-1元 | 批量出片差距不小 |
| 动作自由度 | 受你录像限制 | 可指定走位和姿势 | 展示类选右边 |
| 形象版权 | 自己授权,干净 | 要核对不撞脸 | 都别碰别人素材 |
我自己两条混着用:口播号一周四更,全靠数字分身出片;展示类短视频交给虚拟人,姿势随便指定,省得自己对着镜头比划半天。
口型对齐和动作匹配,是翻车重灾区
口型崩多因为语速太快和侧面机位,把语速压到每分钟220字以内、只用正面半身机位,一次通过率能从三成拉到七成。
有数字为证。9月12日那天我连出二十条三十秒口播,用的是工具默认语速,一次过六条;把语速降到每分钟220字、长句全部拆短之后,又跑二十条,过了十四条。侧面超过三十度的镜头更狠,口型几乎必崩,AI对面部侧面的采样本来就少,这个坑我踩了三回才认。
还有个细节是句尾停顿。AI在句号处换气经常提前零点三秒闭嘴,看着像吞字。我把每句压到十八个字以内,这个问题基本消失。手势匹配更麻烦:文案里写「看这个细节」,虚拟人手指比划的位置跟产品对不上,我只能后期局部重绘去修,一条视频平均多花十五分钟。动作幅度大的舞蹈类、走位展示,建议直接看这篇首帧姿态与幅度控制的修法,写得比我细。对了,声音克隆要单独录十分钟安静环境下的朗读,克隆出来念生僻品牌名会含糊,我把品牌名临时改成谐音字再让AI念,顺了很多。
形象授权这条红线,碰一次就够呛
只能用自己录的形象,或者拿到书面授权的形象;扒别人视频里的脸去换,平台判定侵权基本一抓一个准。
九月中旬我认识的一个同行图省事,直接拿网红的出镜视频去换人,账号连下三条视频,还收到了平台的侵权警告。虚拟人物也不是完全没风险:生成出来的人如果和某位明星高度撞脸,照样可能惹麻烦。我的习惯是生成之后搜图核对一遍,明显像熟人的直接废弃重生成,一般重生成两三次就能避开。用自己形象的话,把录音录像的原始文件存好,那不就是你的授权凭证嘛。
说回开头的结论。固定机位口播,授权形象路线最省心;要表现力,虚拟人路线配人工修口型。先录好素材、压低语速、留好授权凭证,这三步做到位,视频模特换人ai就真能帮你省下拍摄时间,而不是天天返工。
常见问题
换人出镜的视频,平台会限流吗?
主流平台目前要求AI生成内容打标,发布时勾选AI生成声明就行,我实测打标后播放量没有明显波动,不标被识别出来才有风险。
克隆自己的声音需要什么设备?
一部手机加一个安静房间就够,我用百元级领夹麦录了十分钟朗读素材,克隆出来的相似度自己听大概九成上下。
一次生成多少条视频比较合适?
新手先跑十条以内摸参数,语速、机位稳定之后再批量。我现在的节奏是三十秒口播从文案到成片十二分钟左右。
虚拟人物的脸每次生成都会变吗?
会。想固定形象,先生成一张定妆照存下来,之后所有视频都引用这张图做参考,不然每条视频的人物长相都会有细微差别。