ai女模特文案怎么写才出片:提示词指令逐项拆解,脸型材质光影一条条喂对
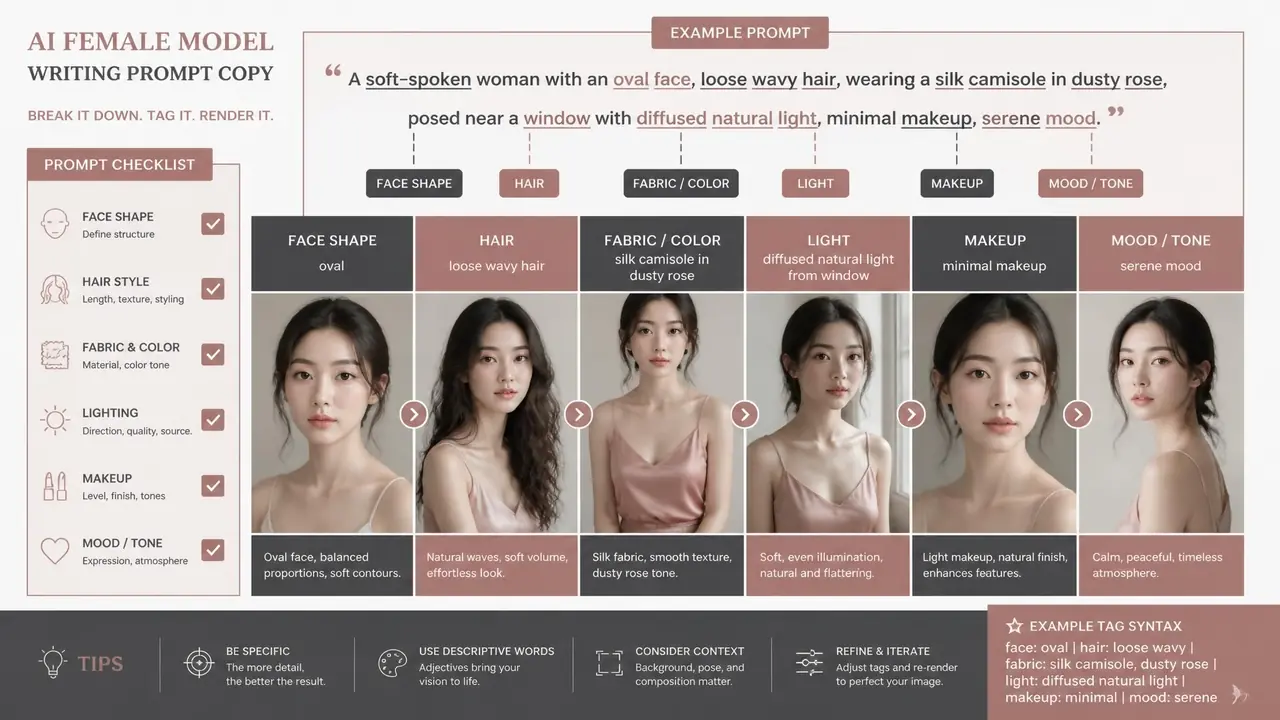
直接给结果:ai女模特文案的关键不在词汇量,在指令颗粒度。把脸型、材质、动作、镜头、光线拆成一条条实词写死,出图稳不稳立刻见分晓。先别急着加新词,把手头那条提示词按下面的顺序重排一遍。
ai女模特文案的核心不是堆漂亮形容词,是把指令拆成一条条模型听得懂的实词。同一件米色针织衫,写「高级感氛围」十张里挑不出一张能用,改成「针织纹理清晰、袖口罗纹、微垂坠」再连出二十张,能用的有十三张。差距就在这。写文案之前,先把「要模型画什么」想成一张清单,再按顺序一层层喂给它。
指令顺序:人、衣服、动作、镜头、光线,一层层往下写
顺序比辞藻重要:先写人,再写衣服,再写动作,然后镜头,最后光线和负面词。按这个顺序排完,重出图的成功率才稳。
我的固定骨架是六层:年龄脸型、发妆、服装材质、姿势动作、镜头焦段、光线与负面词。每层只干一件事,层与层之间用逗号断开,模型解析起来不费劲。举例,一条能直接用的文案长这样:
「25岁亚洲女性,圆脸短下巴,黑长直发发尾内扣,豆沙色哑光唇妆;米白色针织衫袖口罗纹,浅蓝直筒牛仔裤;单手插兜,侧身回望镜头;85mm中景,平视;柔光箱左前45度补光,背景浅灰。负面词:多余手指、塑料皮肤、面部畸变。」
这条文案在我常用的模型里出一张图大概25秒,连出30张,28张构图没跑偏。你要是拿自己的文案照这个骨架重排,先别改词,只调顺序,就能看出差别。话说回来,顺序只是地基,词本身写什么,下一节细讲。
脸型和材质写实词,氛围词只会撞脸
写「鹅蛋脸、短发、针织面料」这种实词,别写「气质美女、高级感」。模型读不懂虚词,只会往平均脸上靠,十张里八张撞脸。
模型不认识「气质」「氛围感」这类虚词,它只会往训练集的平均值上靠,结果就是每张脸都长得像同一个人——像「大众脸」的那种像。实词才是指令。眉形、唇色、皮肤质感,一个词锁定一个细节。
我自己做过对比:同一套文案,脸部段写「气质美女、高级感」的时候,连出20张只能挑出2张当主图;换成「眉峰平缓、哑光底妆、豆沙唇色」,同样的20张里能挑出8张。材质也一样。「呢子大衣」出图容易糊成一团灰,「羊毛混纺、人字纹、哑光」三词下去,纹理立刻浮出来。垫图也有个坑:相似度拉到0.65以上,脸就开始崩,五官挤在一起,0.5左右反而稳。(垫图请用自己的授权图,别拿别人的照片冒充本人生成,这条得记牢。)
动作和镜头:动词加焦段,顶十个形容词
动作写「单手插兜、侧身回望」,镜头写「85mm、中景、平视」。焦段一错,脸部比例立马变形,形容词再多也救不回来。
姿势写动词短语,别写状态词。「优雅站姿」四个字给不了模型任何信息,「单手插兜、重心放右腿、微微侧身」才是能执行的指令。镜头段更是重灾区,很多人不写焦段,模型默认广角,腿是拉长了,脸也跟着畸变。电商展示图我固定用85mm中景,人脸比例最正;想要长腿构图,就把「35mm全身」放动作后面单独写,崩了就重跑。
给你看我记在本子上的实测:
| 镜头写法 | 出图表现 | 适合用途 | 我的评价 |
|---|---|---|---|
| 85mm中景平视 | 脸型最正,30张里28张能看 | 详情页主图 | 稳,闭眼用 |
| 35mm全身 | 腿长拉出约1.2倍,脸略畸 | 长裙、风衣展示 | 得挑,废图多 |
| 24mm俯拍 | 大头身比例,五官挤 | 帽子、配饰特写 | 慎用,10张废6张 |
手是另一个坑。连出30张里有9张手指不对,负面词加上「多余的手指、扭曲的手」之后降到4张。手部暴露多的构图,我干脆把动作改成插兜或者拎包,直接绕开这个雷。出一张图25秒,30张试错也就十几分钟,别心疼额度,试错比憋词管用。
回过头看,开篇说的「拆清单」就是全部:把模特拆成六层,每层塞实词,顺序别乱。文案这东西没有玄学,调一次顺序、换一轮实词,废图率就从一半掉到两三成。今晚拿店里那件新品照着重写一条,明天上新图的底子就有了。
常见问题
文案写得越长,出图是不是越准?
不是。超过150字之后指令互相打架,模型只抓前半段。控制在80到120字,六层各占一句,最稳。
要不要把中文文案翻译成英文再喂给模型?
看模型。主打中文理解的模型直接写中文,翻译一轮反而丢细节。中英混写最亏,两种语言都只吃到一半。
负面词写多少个合适?
5到8个。写太多会把正常特征也压掉,我见过负面词里带「短发」结果全员长发的翻车现场。
换了新模型,旧文案还能接着用吗?
骨架照用,镜头和材质那两段按新模型重调。不同模型对焦段词的敏感度差很多,先拿同一条旧文案跑三张试试水温。