ai模特展示原理拆解:一张服装图从噪声到成图,中间发生了什么
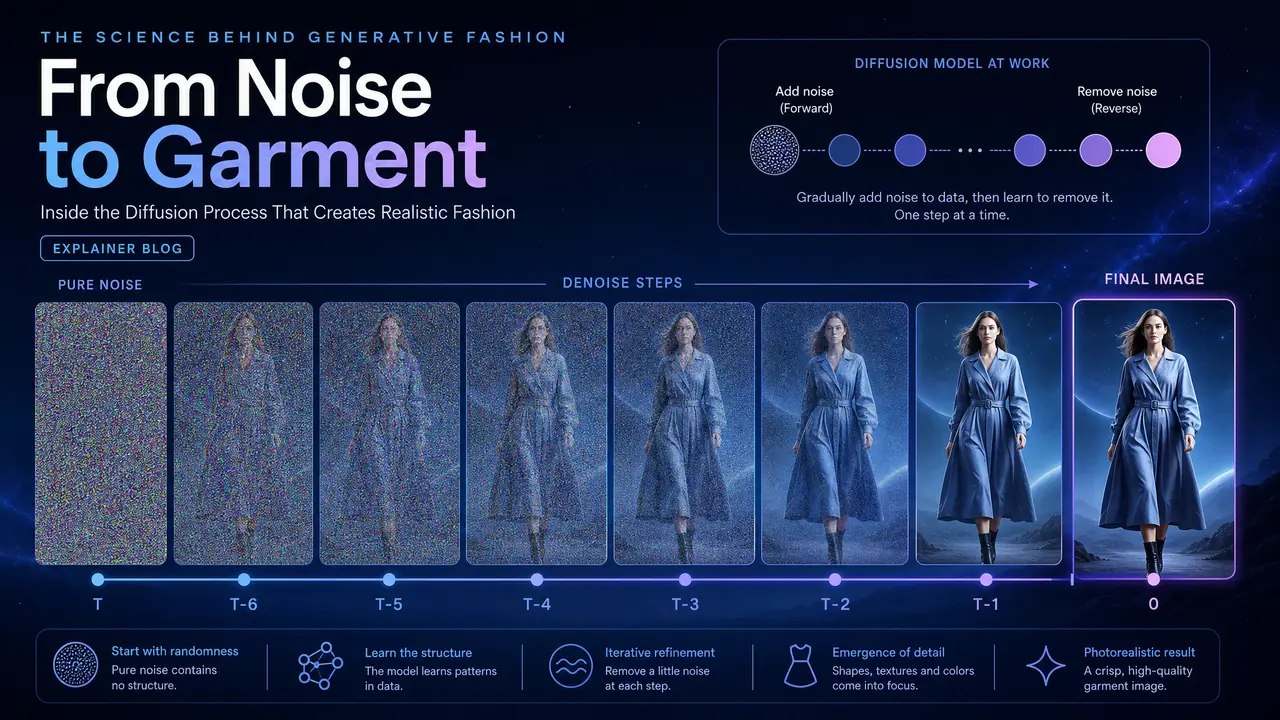
一句话讲透:ai模特展示原理就是三层叠加——底模从噪声里还原人形,控制网络照骨骼图摆姿势,局部重绘补手补脸。看懂这三层,出图坏了知道救哪里,参数也知道往哪个方向拧,不用再一张张碰运气。
工作室每来一个新美工,第一课都是我讲ai模特展示原理。讲这个不为掉书袋,是被逼出来的:新人不懂原理,出图坏了只会重roll,一天roll三百张,好图没几张,还不知道为什么好。原理这东西讲明白了,两周的摸索期能压到三天。
我把整套流程画在白板上,就三块:底模、控制网络、局部重绘。新人盯着白板听一小时,回去出的第一批图就能看出差别。下面按出一张服装图的顺序,把这三块一层层拆开讲。
第一层:底模去噪,一团雪花点怎么变成人
底模干的活是从纯噪声开始,照着提示词的引导一步一步去噪,二十多步之后人形才浮出来。提示词不是画笔,是每一步去噪的导航。
模型训练时学的是"加噪声"——把千万张图一点点加噪,直到变成雪花点,这个过程它学得滚瓜烂熟。生成的时候倒过来:给你一团纯噪声,它照着提示词描述的方向,一步一步把噪声"擦掉",每擦一步都朝提示词说的样子靠近一点。我常用的采样步数是28,步数太少人形糊,太多浪费时间和电,画面差别不大。
理解了这一层,两件事就通了。一是提示词为什么管用:它是每一步去噪的方向盘,你写"侧身站立",模型每一步都往侧身那个方向擦,权重越高擦得越狠。二是为什么换底模画风就变:不同底模"擦"的习惯不一样,有的偏写实,有的偏干净,跟请了不同的画师一个道理。新人知道这个,就不会再问"为什么我换了模型脸全变了"这种问题。
第二层:控制网络,姿势为什么这么听话
控制网络把一张骨骼图喂给模型,18个关键点钉死头、肩、肘、膝的位置,模型只能在骨架里填肉。姿势稳不稳,看的是这层,不是提示词。
只用提示词写"叉腰站立",出来的姿势十张十样。加了控制网络就不同:先画一张骨骼图,十八个关键点把人的大结构钉死,模型去噪的时候被这副骨架约束着,想歪都歪不到哪去。我做服装图的流程里,姿势参考图是必备的,商业拍摄的姿势库存了四十多组,哪个款用什么姿势,基本固定。
跟这层配套的是重绘幅度。拿样衣图垫图换模特的时候,幅度压在0.35左右,版型基本不走样,图案不乱改;拉到0.6以上,模型开始自由发挥,碎花能给你重画一遍。裙摆的走向也归这层管,姿势图里裙摆飘向左边,成图就不会往右跑。这层的门道我整理过一份姿势库的用法,新人照着练就行。controlnet姿势控制在服装出图里的用法,这篇拆得更细
第三层:局部重绘,手和脸的抢救室
局部重绘只重画框选的区域,手糊了框手,脸崩了框脸,框外的像素一个不动。整张重roll是新手干的事,老手都进抢救室动小手术。
去噪和控制网络解决大结构,小细节还是靠修。AI画手为什么崩?因为手在训练数据里的姿态千变万化,模型对"五根手指"这件事的约束很弱。我的做法是框选手部区域,重绘幅度0.4,只让它重画这一块,衣服、背景、脸全都不动。脸要稳定,用的是炼好的LoRA,几十张底图喂下去,同一张面孔能钉在所有款式上。
为什么不能整张重roll?因为重roll等于回炉重造,好不容易调对的姿势、光线、版型全部重新抽签。局部重绘保住了已经满意的部分,只赌不满意的那一小块,废片率从一半降到两成左右,这就是原理层的账。这层再往后的放大、调色属于后处理,是另一段流水线。修手修脸的局部重绘参数,我在这篇里单独记过
白板上的三层,现在我家新美工三天就能过完。回过头看那张白板:底模管"人从哪来",控制网络管"人站在哪",局部重绘管"哪里不对修哪里",三层各管一段,谁也替不了谁。你下次出图手糊了、姿势飘了、脸变了,先别急着重roll,对着这三层想一步——坏在哪一层,就去哪一层修,十有八九一张图就救回来了。
常见问题
不懂原理,只抄参数行不行?
短期行,抄来的参数换个底模、换个款就失效。原理懂了,参数变了你会知道往哪个方向调,这才是能带走的东西。
采样步数是不是越高画质越好?
不是。28步和40步的成图肉眼差别很小,时间翻倍。步数只影响去噪彻不彻底,画质上限更多由底模和分辨率决定。
为什么ai画手老是出问题?
训练数据里手的姿态太多样,模型对指头数量的约束弱。实际操作里不硬抗,框选手部用局部重绘修,一张图多花一分钟,稳得多。
这三层里哪一层最值得新手先学?
控制网络这层。姿势稳了,出图的底线就有了,废片率降得最快,投入产出比最高。