ai模特gpt用法实测:对话模型在出图流程里干的三件活
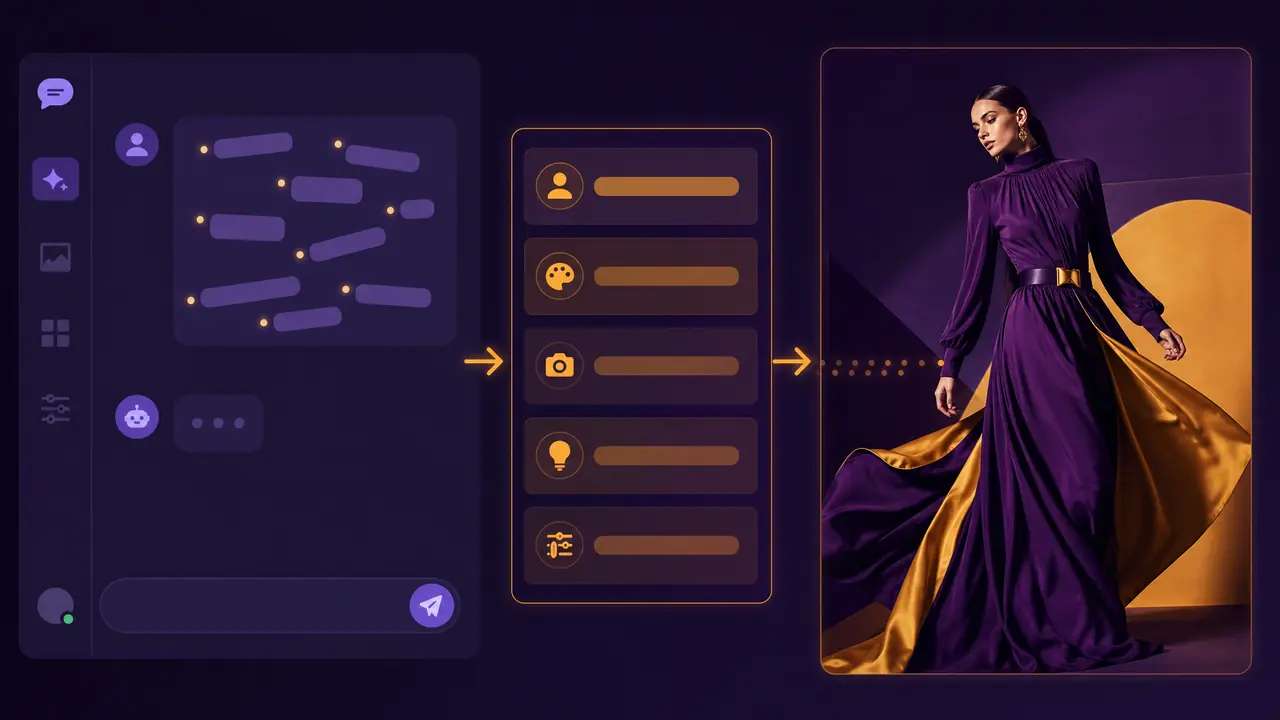
直接给结果:ai模特gpt的正确打开方式不是拿它生图,而是让它干三件活——把中文需求翻成结构化提示词、给成片挑毛病、批量改场景描述。生图这件事交给专业出图工具,GPT当军师。我按这个分工跑了一个月,废片率从四成掉到一成半。
GPT在出图流程里到底干什么活
对话模型擅长的是语言组织,不是像素生成,让它写出带光影、镜头、材质三要素的结构化提示词,比让它直接画一张图值钱得多。出图工具吃得越细的提示词,废片越少,而组织语言恰恰是GPT的本行。
我在一家做家居服和睡衣的公司当电商美工,每周要出两批模特图。以前我的流程是自己憋提示词,憋出来的东西一半靠玄学。三月开始我换了个干法:先跟GPT聊天。我把运营的原话丢给它——比如「要那种刚睡醒、慵懒、又不是没精神的早晨感」——让它翻成结构化的英文提示词,固定模板是主体、动作、光线、镜头、氛围五段。翻出来的第一版我对照着跑图,二十张里能用的从七张变成十三张。
第二件活是审图。出完图我把成片描述给GPT听——或者直接传图让它说——问「这张图里有没有不符合真实家庭场景的细节」。它挑毛病比我细心:地毯的花纹和窗外的季节对不上、杯子里的茶水位不对这种事,我盯两小时眼瞎了看不见,它一眼就指出来。
第三件活最省命:批量改场景。一个款要出客厅、阳台、卧室三个场景版本,我让GPT基于同一套主体描述只替换场景段,三个版本的核心描述一字不差,出来的图模特脸也稳。以前手改,改着改着就把光线参数也顺手动了,脸跟着崩。
我让GPT直接生模特图的实测
GPT直接生成的模特图能当草图用,当成品不行:单张质量可以,手势和面料纹理不稳,批量一致性几乎失控。要凑合出概念图可以上,要上架图就别为难它。
四月我较过一次真。同一个睡袍款,我用GPT直接生成和用专业出图工具各跑十张。结果摆在那:GPT的十张里,挑不出两张手是干净的,睡袍的罗纹袖口五张画成了普通布边,更麻烦的是十张模特的脸各不相同。专业工具那边,配合我前面说的结构化提示词,十张里七张能进候选池。
但GPT生图有个场景真的香:开会前出概念草稿。运营说想拍一组「冬日暖光」的调性,我五分钟出四张概念图扔进会议室,方向对了再回工具里正经出图。省下的那两轮沟通返工,比图本身值钱。
所以我的桌上现在写着一行字:GPT管想,工具管画。谁越界谁倒霉。
提示词交给GPT润色之后,废片率的变化
让GPT润色提示词的关键不是让它写得多华丽,而是让它固定一套五段式结构、每次只动变量段,这样批量出图的一致性才守得住。一个月下来,我的单张出图到成片时间从二十分钟压到十一分钟。
具体怎么润色,有条纪律:主体描述段锁死,谁都不许动;每次换图只改光线段或场景段。我让GPT把这个规矩写进了它每次输出前的自我检查里,它偶尔想「优化」主体段的时候会自己提醒自己。这个小心思是看写口令的文章学来的,接单两年沉淀的口令结构里讲的分段锁死的思路,和我的做法是一个道理,值得照抄。
变化是能算出来的。三月底我记过一周的账:出图八十六张,进修图队列四十一张;按新流程跑了五月初那一周,出图九十张,进队列二十四张,其中大半是背景瑕疵这种五分钟能修的小问题。手感上最大的区别是——我终于不用在下班前一小时跟抽卡似的赌图了。
丑话说在前头,GPT不是万能的。它对中文电商黑话的理解偶尔跑偏,比如我说「要淘宝爆款感」,它理解出来的东西浮夸得像十年代的电视购物。这种词得自己留个翻译对照表,慢慢教。
这事想通了很简单:出图流程里本来就有一堆语言活,以前是我一个人兼着干,现在分给了最擅长语言的那个。分工完了,人干人该干的事——挑图、修图、跟运营吵审美。工具各归各位,效率自然就上来了,美工这行的饭碗没丢,只是换了种端法。
常见问题
不会英文也能用结构化提示词出图吗?
可以,这正是让GPT进场的第一理由。你用中文把需求说人话,它负责翻译成出图工具吃得懂的英文结构,你只需要看懂输出里的五段分别是什么,复制粘贴就行。
GPT挑图的判断可信吗?会不会瞎说?
七分可信。它对光影逻辑、透视常识这类有规律的问题很敏锐,但审美类判断比如「够不够高级」就别指望它,那部分还得人来拍板。把它当一个细心的实习生,别当总监。
对话模型直接生图什么时候够用?
三种场景够用:内部沟通的概念草稿、给客户演示方向的小样、不需要上架的低精度配图。一旦图要过审、要放大、要批量一致,就换专业工具。