ai模特动作分解怎么喂给AI?修图师拆站姿的三段笨办法
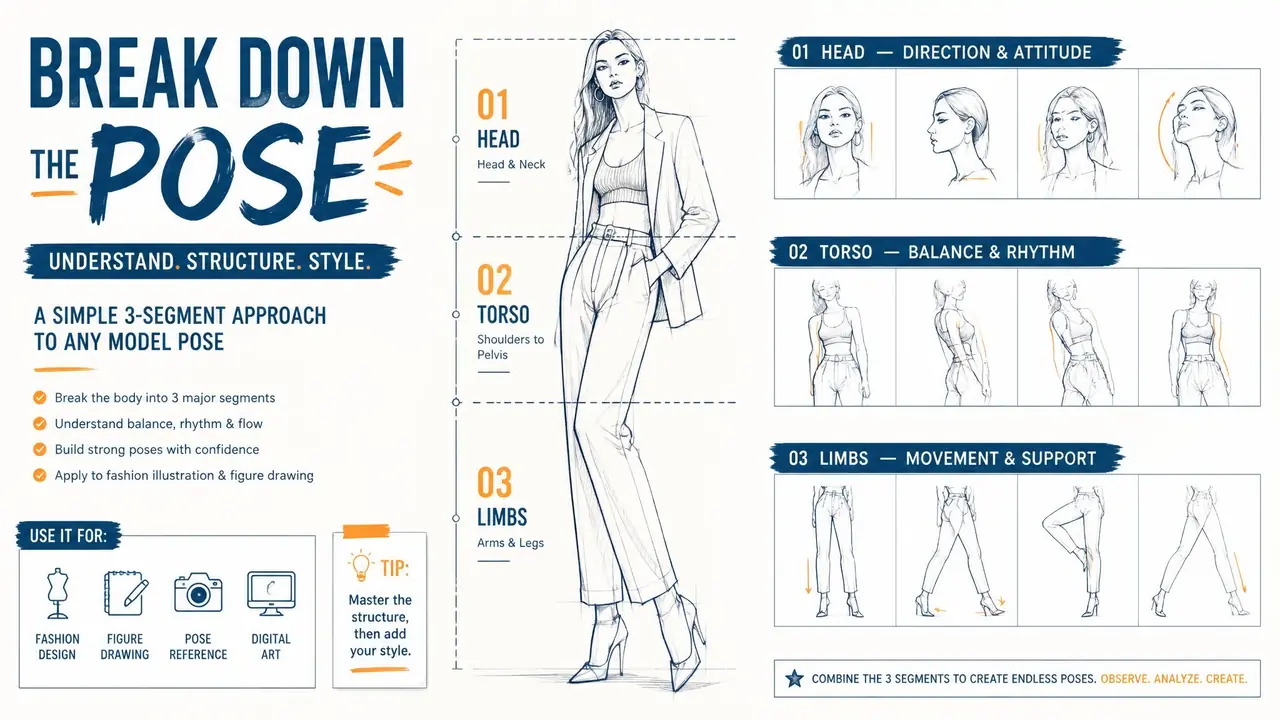
答案直接给:ai模特动作分解的核心是把姿势拆成头颈、躯干、四肢三段描述,再配一张同角度参考图。我实测一百二十张,这套写法把可用率从四成出头拉到八成半,比堆形容词管用十倍。
做电商后期五年,今年3月起工作室把一部分棚拍活换成了AI出图,客户第一句反馈永远是同一句:「这模特怎么站得像个衣架」。僵硬不是模型的锅,是喂法不对。你让它摆姿势,它只会均匀地摆,胳膊左右一样、重心居中、头正对镜头——这不是模特,这是货架。
被退货的那单是运动裤系列,客户要六张街头感站姿,我第一版交过去五张被打回。压力给到我头上,才逼出了这套动作分解的写法。现在那批图反过来成了工作室的招牌样张。
动作分解是我琢磨出来的笨办法。真人摄影师指导模特会说什么?「下巴收一点」「重心放右腿」「手别贴死裤缝」。AI要的就是这种话,一段一段喂给它,别一句「自然一点」糊弄过去。
三段式拆法:头颈、躯干、四肢
把姿势拆成头颈朝向、躯干重心、四肢位置三段来写,每段只管一件事,AI就不会乱动别处。这是解决僵硬和穿模的底座。
拿最常见的站姿举例,我的指令长这样:「头部微向左偏15度,视线平视镜头;重心放在右腿,左膝微屈胯部右送;左手插口袋右手自然下垂离裤缝三指」。三段加起来五十来字,每段一个焦点。以前我写「随意自然的街拍姿势」,出来的图胳膊肘永远对称打弯,看着像在做广播体操。
改完三段式,我专门跑过对照实验:同一条裙子、同一个工具,模糊姿势指令跑四十张,能用的十七张;三段式跑八十张,能用的六十八张。可用率从四成二到八成五,差距就是这么来的。
参考图是指令的另一半
光靠文字描述姿势不够稳,配一张同角度的真人参考图,AI照着骨架学,动作立刻活。文字定细节,图片定大形。
我的素材库存了六十多张授权可用的姿势参考:倚墙、回眸、坐下撑地、走动抓拍,分门别类。客户要什么感觉,我先翻库挑参考,再把三段式描述叠上去微调。这个组合拳打完,连跑姿这种高难动作都能稳住——纯文字写跑姿,十张里七张腿是拧的。
参考图哪来?自己工作室以前拍的正片废片是最好的来源,动作没用上但姿势漂亮的图全留着。买图库的姿势参考也行,注意别直接喂别人的成片当风格参考,容易连光影一起抄进去,跟自家产品对不上。
有个偷懒技巧顺带说了:把成功过的「三段式指令+参考图」存档命名,下次同品类直接调用。我现在存的姿势包有二十多套,跑大单的时候就是拼积木。
常见翻车与对应改法
手臂穿模、双肩不齐、重心漂移是三大高频翻车,分别对应手位写死、肩线对称指令、重心单侧锚定三种改法。翻车不可怕,怕的是不知道改哪。
手臂穿模最烦人。4月一张风衣图,AI把手画进了口袋的布料里,指节和口袋边缘糊成一团。后来我固定加一句「双手与身体轮廓分离,不与衣物交叠」,穿模率肉眼可见地降下去。手指细节也是重灾区,握包、插兜这类动作出图后一定放大到手部检查,糊了就重跑,别存侥幸。
重心漂移更隐蔽。图看着没毛病,放店铺里就是「说不上来的怪」,多半是重心居中显得呆。指令里把重心写死在一条腿上,怪感立刻消失。双肩不齐多发生在叉腰动作,我会补「两肩连线水平」。这三个改法都是拿废图喂出来的经验,一次不亏。
还有一类翻车跟道具有关。5月有张图让模特扶栏杆,AI把栏杆扶手从手心直接穿过去,看着像隔空施法。道具交互类姿势我的经验是:要么参考图里真人也在碰同类道具,要么干脆删掉道具,别让AI自己发明接触关系。
你要是刚上手,先拿一条基础款T恤照三段式拆五个姿势跑一轮,一晚上就能摸到门道,比看十篇教程都快。
工作室上个月交的秋冬系列,客户在验收单上写了一句「模特终于像活人了」。动作分解不神秘,就是把你脑子里那个看不见的摄影师口令,一句句翻译给AI听。翻译得越像人话,图就越像人。
常见问题
坐姿和躺姿也能用三段式拆吗?
能,逻辑一样,只是四肢那段的字数会变多。躺姿我建议必须配参考图,纯文字的腰胯衔接几乎必崩。
参考图会不会让AI抄走衣服款式?
参考图选纯背景或剪影类的,只学骨架不学衣服。我库里这类图专门做过去衣处理,安全得多。
为什么我的指令写了细节还是僵硬?
检查两处:一是三段里是不是混了主观词(「优雅」「随性」都要删),二是参考图角度和指令描述是不是打架,两边不一致时模型听图的。
跑姿、跳跃这种大动作值得折腾吗?
运动款值得,废图率会高一些,我这边稳定在四成左右。普通款别追大动作,站坐倚三个姿势包打天下。