ai生成模特口令怎么写?短视频直播场景的四段式拆法与实测记录
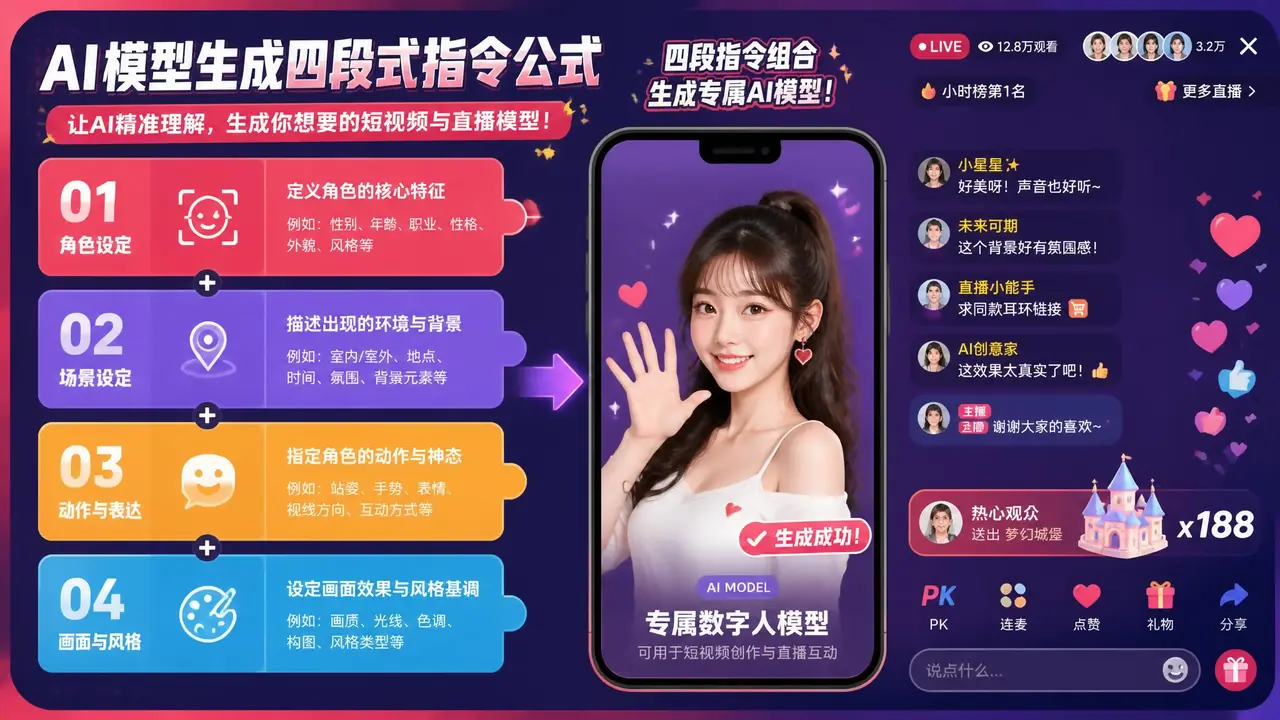
直接给结果:ai生成模特口令就是提示词,写成"人设、服装、动作、灯光"四段结构,出图可用率直接翻倍。我在2026年9月给一个女装直播间连出20张图,按这套写法挑出了8张能直接上架的,糙写的口令20张只出3张能看的。先按四段式改你手里那条口令,再谈别的。
ai生成模特口令,说白了就是你敲进输入框里那串指令。用户嘴里的口令、工具文档里的提示词,指向同一个东西:约束出图结果的文字。我的判断很直接——口令写得糙,图就废一半;按结构写,才谈得上挑图。2026年9月中旬我接了个活,给女装直播间做数字人模特图,这套写法就是在那个项目里磨出来的,下面全按真实场景讲。
口令、提示词、咒语:名字随便叫,写法就一种
ai生成模特口令就是提示词,都是敲进输入框约束出图结果的指令。电商圈叫口令,工具文档叫提示词,别被名字绕晕。
为什么叫口令?我猜是直播圈的老师傅带新人时嫌"提示词"三个字拗口,喊着喊着就传开了。你在剪映、可灵这类工具的输入框里敲的那串字,和用英文工具时写的prompt,功能完全一样:告诉模型画什么人、穿什么、干什么、站在哪。
短视频直播场景对口令有个额外要求——脸要能复用。数字人口播视频得固定一张脸换五套口播稿,挂车短视频要同一张脸出现在十条素材里。这就意味着口令不能想到哪写到哪,得像填表一样一段一段写死。这也是后面四段式写法的由来。
四段式写法:人设、服装、动作、灯光场景各管一段
把口令拆成四段来写:人设定年龄气质,服装定款式面料,动作定姿势机位,灯光场景定氛围。
四段的分工很明确。人设段管这张脸长什么样、多大年纪、什么气质;服装段管穿什么、什么面料、什么穿法;动作段管手在干嘛、镜头从哪个角度拍;灯光场景段管光从哪来、背景是什么色调。一段只管一件事,改哪段不牵连别段——这是省额度的关键,你改一个词全条重写,出来的图跟上次对不上号,排查都无从排起。
先看糙写和结构写的差别:
| 段落 | 该写的内容 | 糙口令的常见毛病 |
|---|---|---|
| 人设 | 年龄段、气质、发型发色、身材比例 | 只写"美女",出来全是千篇一律的网红脸(我吃过这亏) |
| 服装 | 款式、颜色、面料、穿法细节 | 只写"穿裙子",短裙长裙连衣裙全靠模型猜 |
| 动作 | 姿势、手持物、机位高低 | 不写动作,十张里九张双手抱胸站着 |
| 灯光场景 | 光线方向、背景、整体色调 | 只写"高清",背景随机乱飘,五张图五个影棚 |
拼起来就是一条完整口令,我实际用的一条长这样:"25岁女性,气质干净,黑长直发,身材匀称;米白色针织开衫,内搭浅蓝吊带,面料有轻微绒感;右手轻提裙摆,站姿微侧,镜头平视半身;左侧柔光,浅灰影棚背景,暖色调。"80来个字,四个逗号分四段。你照这个骨架换词就行。
有个细节要提醒:写全身动作时画幅和留白得跟上,不然脚总被切掉,这块我踩过坑,展开写在了全身ai绘画不断腿不切脚的画幅与提示词写法里,两篇可以对着用。
直播间项目实测:单张25秒,崩脸线在相似度0.6
2026年9月实测:连出20张单张约25秒,相似度过0.6脸就崩,3张手出错,能用的8张都来自固定种子。
9月15日到9月22日那一周,客户要求同一张脸换五套秋装,用于直播间立牌和挂车短视频。我的流程是先把人设段写死、种子固定在8842,然后每换一套衣服只动服装段。单张出图约25秒,一晚上连着出了20多张。
翻车记录也得摆出来。20张里3张手是错的,全是"手持口播提词卡"那张——卡的边角折进手指里了,模型画不明白这种握持。返工办法是把动作段的"手持提词卡"删掉,改成"双手自然下垂",提词卡后期贴上去,十分钟解决。还有一次,我把相似度从0.5拉到0.65想更贴近客户给的样片脸,结果连出五张,两张眼距变了、一张法令纹凭空多出来。崩脸线就在0.6附近,往后再也没碰过。
这工具确实猛,但也挑人。同样一条口令,我同事跑出来张张影棚风,我一问,他把灯光场景段删了——他嫌那段占字数。省那十几个字,多烧二十次额度,这笔账怎么算都不划算。
写崩了别急着重抽,按这个顺序排查
排查顺序固定四步:先删到只剩人设段重出一张,再逐段加回;然后查画幅比例,最后查相似度和种子。十分钟内基本能定位。
第一步砍词。把口令删到只剩人设段,重出一张看脸正不正。脸正,说明问题在后三段里,逐段加回,加到哪段崩就是哪段的词有问题。脸不正,先查是不是上次改过相似度。
第二步查比例。直播间立牌用9:16竖版,背景大屏用16:9,比例写错人物会被硬拉变形,看起来像"脸崩",其实是画幅的锅,白白冤枉相似度参数。
第三步查种子。固定了种子还每张不一样,八成是手滑开了随机模式,或者复制口令时把上一条的种子号带丢了(这种低级错我犯过两回)。
话说回来,排查这事的本质是控制变量。一次只动一个地方,你才说得清是谁的锅。
回到开篇那个判断:ai生成模特口令不是玄学,是结构。四段各管一摊,参数守着0.6这条线,种子钉死,出图就从抽卡变成流水线。短视频直播这行等不起慢慢试,口令写得越有章法,留给挑图和上播的时间就越多。这套方法我从9月用到现在,没再大改过。
常见问题
口令写多长才合适?
我一般控制在80到120字。超过150字,各段的描述会互相打架,比如人设段写"短发"、服装段又冒出"长发"这种自相矛盾。写长了先删形容词,删到每段只剩名词加一两个修饰为止。
可以拿别人的照片当参考去生成吗?
不行。请勿用他人照片冒充本人生成,这是底线问题,平台也会拦。要定制脸,用自己授权的形象照,或者干脆纯口令生成,写清五官特征就行,商用还省去肖像授权的麻烦。
给童装店写口令要注意什么?
只往电商童装拍图的正面场景写:年龄段、活泼气质、衣服的尺码感和面料细节,背景用教室、公园这类干净场地。比例词要写准,儿童的头身比和成人差很多,沿用成人口令会出来"缩小版大人",一看就假。
短视频数字人和静态模特图,口令要分开写吗?
要。静态图管住脸和姿势就够,数字人口播还得加口型幅度、头部微动这类描述,而且静态那套"站姿微侧"的词到了动态里会变成僵住的鬼畜帧。我的习惯是静态口令打底,动态另起一条只写运动段。