模特AI斗舞实测:两帧图拼出一段battle视频
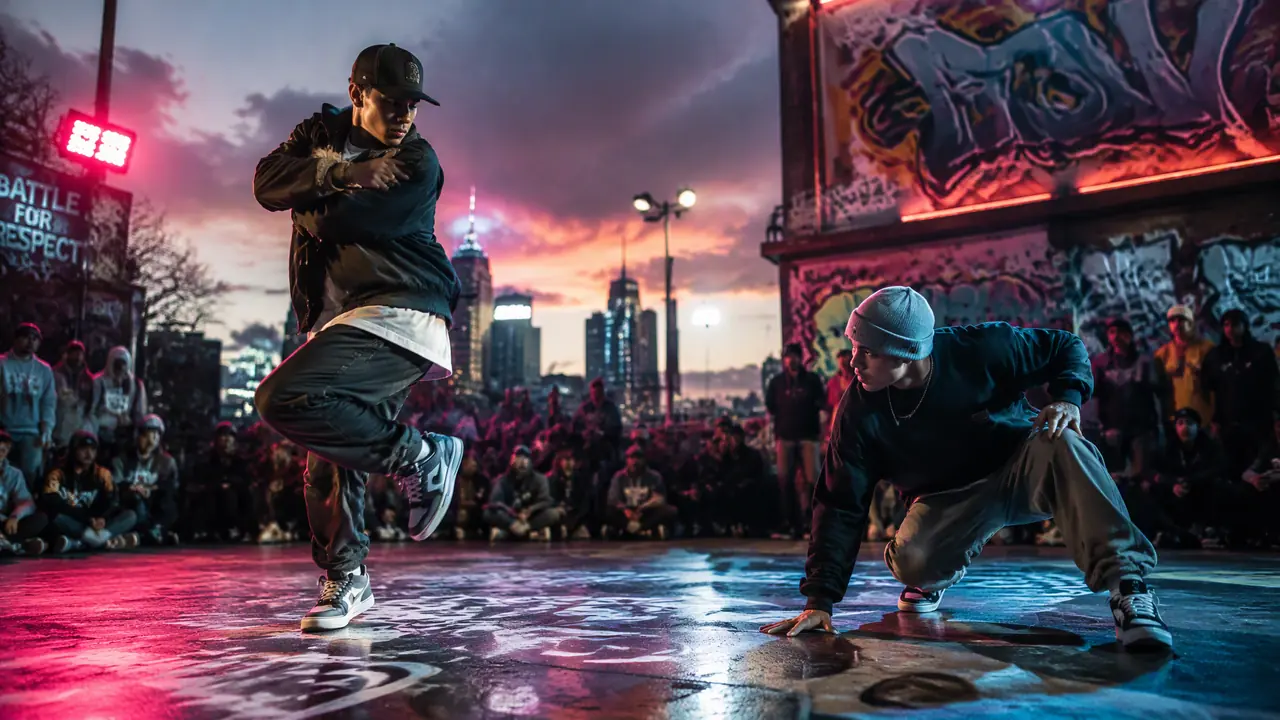
先给答案:模特AI斗舞视频,核心就两帧图——开场一帧、定格一帧,中间动作交给图生视频,单条五秒,两条拼一段,我两周跑了二十多条成了九条。
我运营一个穿搭类短视频账号,斗舞这批素材是账号数据最好的一波,完播率高出日常三分之一。
模特AI斗舞这个选题,我起初是抱着玩一玩的心态试的。账号做了大半年,穿搭展示类内容数据平平,有天刷到街舞battle的卡点视频,播放量都挺好,就想:能不能让AI模特来斗舞?真拍的话请两个会跳舞的模特一天四位数,AI方案的成本连零头都不到。试了三周,踩的坑和成片的路数都在这了。
斗舞视频为什么特别适合AI做
斗舞天然是回合制:一人一段、轮流出场、定格收尾,结构本身就是分段的,正好绕开AI长视频连贯性差的短板。内容形式跟工具脾气对上了。
AI视频最大的软肋是长时间保持动作连贯,超过八秒人物就容易飘。斗舞刚好不跟这个软肋硬碰——街舞battle本来就是你一段我一段,每人出场五秒,定格一个pose结束,下一个人接上。分段结构天然契合分段生成,这是我入坑之后才反应过来的:选对题材,工具的短板直接隐身。
穿搭账号还能蹭一层收益:斗舞动作大,衣服的垂坠感和版型在动态里展示得比静态图充分,评论里真有人问裙子链接。这是意外之喜,原本只冲着完播率去的。
两帧图的做法,参数全在这
先出开场帧和定格帧两张同人物同场景的图,动作描述写一个八拍以内的招式,单段五秒,成段率四成。两帧之间别留给模型自由发挥的空间。
具体流程:第一步出人物底图,两个人物要分开定,一个街舞风一个爵士风,脸型、发型、服装色系错开,观众才分得清谁是谁。第二步定场景,同一面涂鸦墙同一个机位,两张图的环境必须一致,光线色温差一点,拼起来就跳戏。
第三步做首尾帧。我的做法是底图生成后,用改图功能把人物姿势摆到位——开场帧站定蓄势,定格帧一个大招姿势。这里有个实测发现:直接让模型"从A姿势跳到B姿势",成功率不到两成;把动作描述压缩到"一个八拍内完成",比如"单手撑地旋转接定格",成段率能上到四成。二十六段里成了十段,九段能用。
拼接用剪映就够,两段中间加四帧白闪转场,卡上音乐重拍,观感直接上一个档次。视频类素材的批量出法,这篇ai帅哥模特视频实测:男装主图视频一晚产出,成本不到实拍零头里那套流水线,跟我斗舞这套流程是通的。
肢体崩坏怎么救,我的两板斧
肢体穿插和落点漂移是两大崩坏点,降动作幅度、定格帧衔接两头堵,废段能救回一半。宁可动作小,别要动作假。
第一大崩坏是肢体穿插——手臂穿过身体、双腿交叠分不开。我的数据里,动作描述带"跳跃""翻滚"这种腾空词的段落,八成崩在空中姿态上。后来我把大跳全换成地面动作,滑步、波浪、转身,崩坏率掉了一半还多。跟模型讲道理不如少给它出难题。
第二大是落点漂移:转完一圈人已经不在原位,下一场接不上了。救法是用定格帧做锚——每段结尾都落回同一个人位,拼起来位置就不会散。我有一条成片重做了三版:第一版人物越跳越靠右,第二版直接跳出了涂鸦墙,第三版靠定格锚点才稳住。现在每段生成前,我都会先看一眼上一段的结尾帧,把落点写进下一段的提示词里,十段能省掉四五次返工。
还有个细节,出人脸的AI视频一样有边界问题:别拿生成的脸冒充真舞者发"实拍挑战"类话题,账号简介里写明AI创作,粉丝反而觉得是创意。我那九条成片全部挂了AI标识,数据没受影响。
三周下来,账号多了九条斗舞片,完播率拉起来一截,成本加起来不到一顿火锅钱。模特AI斗舞给我的最大体会是:AI视频不是让你凭空造动作,是让你把"会分段的内容"高效拼出来。回合制的斗舞、有定格的舞蹈,天生适合这套打法。下一批我想试试三人轮流出招,就是怕崩坏率也跟着翻倍。
常见问题
不会跳舞也不懂街舞,能做出斗舞视频吗?
能,我不懂舞,动作描述都是从热门视频里拆的:滑步、转身、定格,一个八拍一个招式就够用。看得多自然知道哪几个动作出片。
两段视频拼起来跳戏怎么办?
三处对齐:场景一致、光线色温一致、结尾定格落回同一人位。再加四帧白闪转场盖住接缝,基本看不出来是拼的。
为什么生成的动作总是很假?
动作给大了。腾空、翻滚是崩坏重灾区,换成地面动作,幅度减半,假感立刻降。AI目前擅长的是有节奏的小幅动作。
这类AI斗舞视频发账号有风险吗?
主动挂AI创作声明,不冒充实拍,不模仿真实舞者的标志性动作编排,就没有大问题。我的九条全部带标识,没有一条被限流。