模特跳舞ai口令怎么写?让模特动起来的口令实测
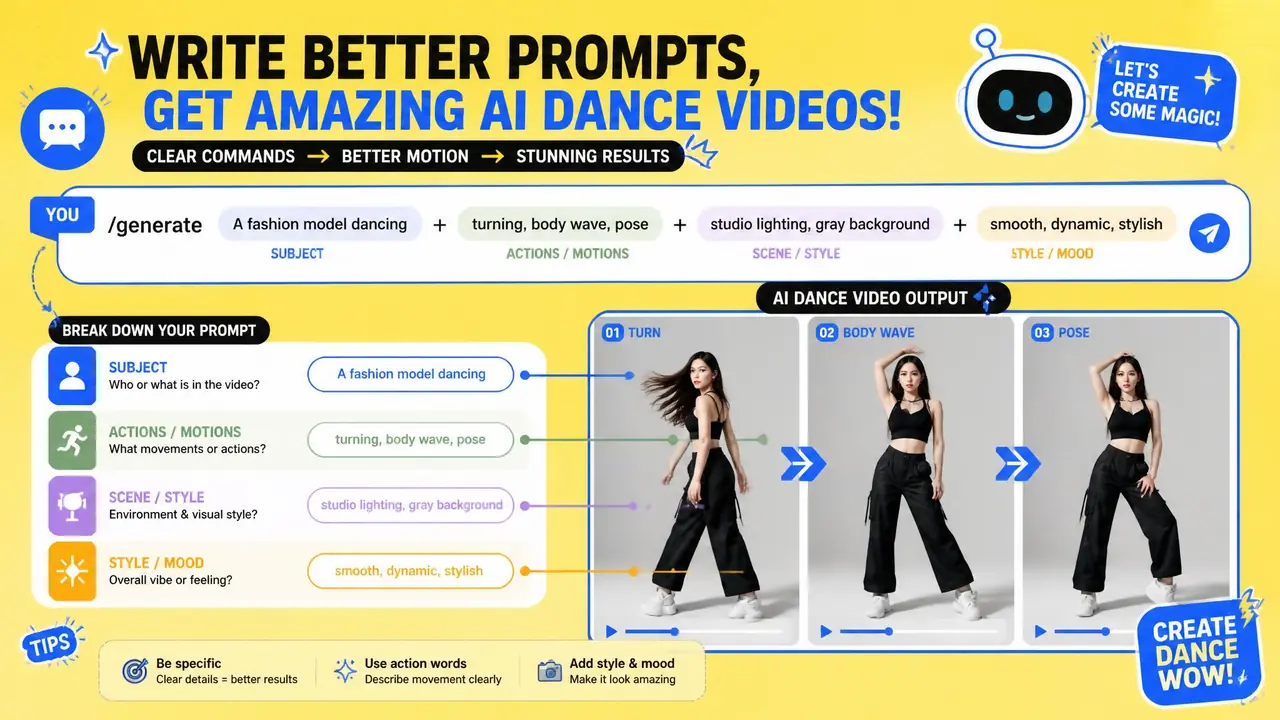
一句话版本:模特跳舞ai口令的黄金结构是四段式——主体、单个动作、速度、镜头,一次只让模特做一件事。我带新人时实测上百条口令,照这个句式写的成片率接近六成,随手写"跳舞"的不足两成。口令例子和分级都在这篇,抄走就能用。
模特跳舞ai口令怎么写,我是在给公司带新编导的时候被迫总结的。组里三个新人,同一个工具,同一个AI模特图,出来的视频天差地别。好的那条能直接发,差的那条模特手肘反向弯折,看得人头皮发麻。差别不在工具,在打进去的那行字。
我把新人踩过的坑和成片记录翻出来,整理了一套口令库。9月试了上百条,留下来的每一条都有成片撑腰。这篇就是那套口令库的浓缩版。
口令四段式:主体、动作、速度、镜头
稳定出片的口令结构是四段:谁、做一个什么动作、什么速度、什么镜头,多余的字都是变量。动作只写一个,写两个以上崩坏率翻倍。
拿一条我们实际在用的口令举例:"年轻女模特,缓慢向右转身,双手轻提裙摆,动作慢速流畅,固定中景镜头"。拆开看:主体是年轻女模特,动作只有一个转身加提裙摆,速度词是慢速流畅,镜头词是固定中景。四个格子填满,别的什么都不加。
新人最常见的错误是把口令写成心愿清单——"跳舞、旋转、跳跃、微笑、氛围感、大片感",十几个变量塞一行字,AI每个都想满足,结果每个都满足不了。我让新人做过一个对照实验,同一天同一张图,清单式口令出12段,能用1段;四段式口令出12段,能用7段。数据摆在那,不服不行。
速度词里"慢速"是万金油。AI对快动作的处理能力差得远,快三个等级,崩坏率翻三倍不止。想要节奏感,去剪辑软件里调,别在口令里逼AI快。
我常用的口令分级:哪些稳、哪些赌
口令按成片率分三档:摆pose和缓慢转身最稳,小幅律动可用,快节奏舞步纯赌运气。铺量用第一档,创意条用第二档,第三档别指望。
9月的记录归了类,做个表:
| 口令类型 | 示例 | 实测成片率 |
|---|---|---|
| 静止系 | 轻微摆pose、回眸、抬手抚发 | 八成以上 |
| 慢舞系 | 缓慢转身、轻移半步、裙摆轻摆 | 五到六成 |
| 节奏系 | 快速旋转、连续律动、跳跃 | 不足两成 |
静止系听着没劲,其实是组里产量主力,发圈发店铺氛围视频全靠它,几乎不废。慢舞系是氛围感的甜点区,动作小、有生命感,我们大部分货架视频用这档。节奏系我一般只在有闲工夫的时候赌几把,出一条能用的够我剪一条高光,但绝不在赶工的日子碰。
有两个词我在口令库里永久拉黑了:"优雅"和"性感"。前者AI理解不了,出来的动作没变化;后者容易触发内容审核,平台那关都过不去。具象的动作词永远比抽象的感受词好使。
口令之外,决定成败的两件事
底图的姿势和服装复杂度,比口令本身更影响成片:底图手部清晰、服装结构简单的,成片率高出一大截。出视频前先审一遍静图。
第一件是底图。AI视频是在静图上"接着动",静图里手就是糊的,动起来只会更糊。我们现在的流程是静图先过三关:手部清晰、衣服结构正常、没有奇怪的光影,过不了关的图不进视频环节。9月有批图赶工没审,视频环节废片率直接翻倍,怨不得口令。
第二件是服装。轻纱、大摆裙这类"布料多"的款,动作起来布料模拟容易穿模;贴身款、结构简单的款稳得多。给大摆裙写口令时我习惯加一句"裙摆自然下垂不粘连",能救回一些。皮衣西装几乎不挑口令,怎么动都行。
对了,还有个玄学发现。同一条口令连跑三次,结果常常不一样,运气成分真实存在。我们的规矩是重要条目一次生成三条口令各跑一段,三选一,别把宝押在一次渲染上。
口令库建了两个月,新人上手时间从一周缩到两天,我自己写口令也形成了肌肉记忆。说穿了没什么神秘:AI不读心,你写得像给实习生下需求,它就交得像实习生,清楚、具体、一次一件事。模特跳舞ai口令这门手艺,本质上是把"我想要什么"翻译成AI听得懂的人话。今晚把你最想出片的那条口令改成四段式,跑一遍,明早看结果。
常见问题
口令用中文还是英文效果好?
我用中文为主,个别工具对英文动作词响应更好,同一个动作中英各跑一遍对比着选,差异不大就固定中文,好维护。
口令越长越详细是不是越好?
不是。实测超过四个变量的口令,崩坏率明显上升。四段式之外要加,只加具体名词,比如"红色连衣裙",别加抽象形容词。
为什么同样的口令昨天能用今天崩?
生成模型有随机性,同口令多次结果不同是常态。重要素材一次跑多条口令各出一段,三选一比单押靠谱。
想让模特边走边跳怎么写?
拆开写两段视频:一段走路、一段原地律动,剪辑里拼接。复合动作塞进口令里,两头都做不好。