ai模特视频指令怎么写?走路转头微笑的动作描述模板,新手第一次上手就能抄
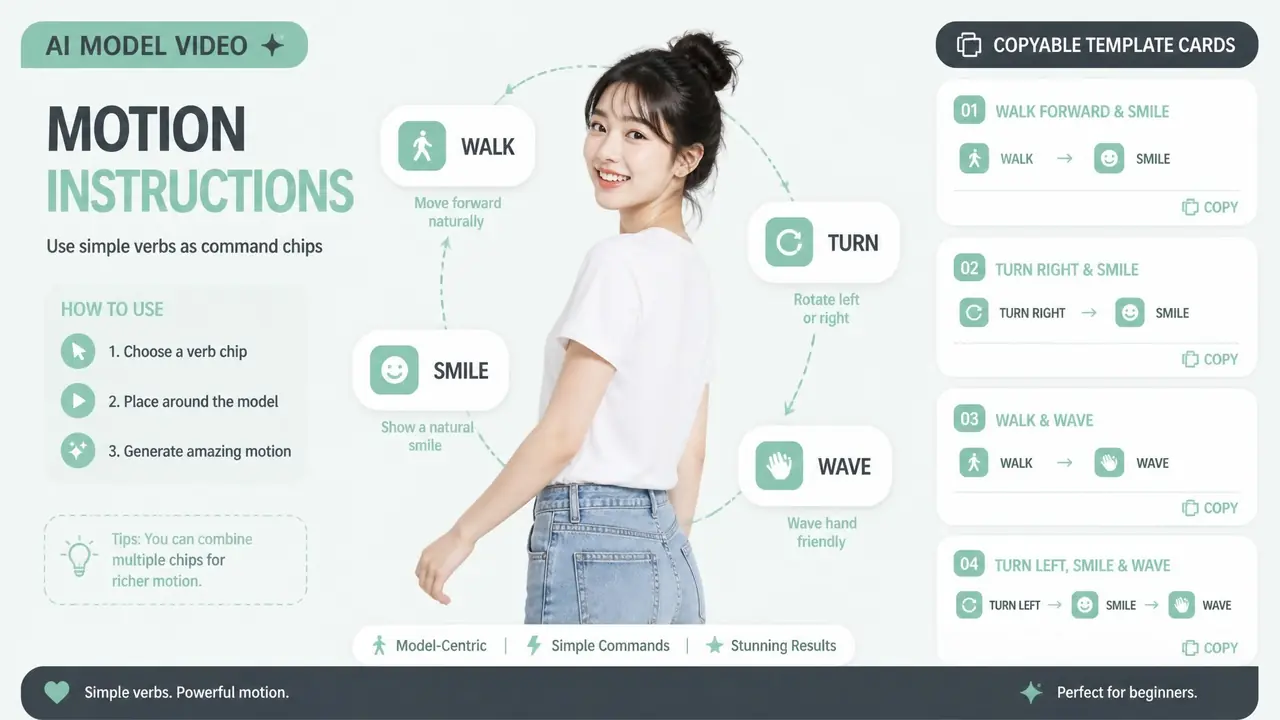
别绕弯子:AI模特视频的动态指令,核心就一句话——一个镜头只说一个主动作,幅度和速度给具体数,形容词全砍掉。这是我用三十多条废片换来的教训。你现在要做的,是把下面这套写法直接抄走,先出第一条能看的视频,再谈优化。
ai模特视频指令不是什么咒语,就是把"画面会怎么动"用大白话讲清楚:谁、做什么动作、动多大幅度、多快。新手第一次上手最容易翻车的点,往往不是工具不行,是指令里塞了五个动作,模型一个都做不好。我第一次给店里那条连衣裙生成视频,写了一段四十多字的"豪华版":自然行走,微笑,转头看镜头,手撩头发,风吹裙摆。出来的东西模特同手同脚,脸还糊成一片。后来只留"向镜头方向慢速走五步",一次就过。这个落差让我把写指令这件事从头想了一遍。
新手第一大坑:一个镜头塞了五个动作
一条视频指令只保留一个主动作,其余细节全部砍掉,成功率能从两成拉到八成上下,这是最省额度的一刀。
为什么要这么狠?因为视频生成和出图不一样。出图时模特姿势错了你能重抽,视频是一整段在动,动作一多,模型要在几秒里同时算清四肢、脸、发丝的连续变化,算不过来就糊给你看。我2026年9月中旬那批测试里,连出20条5秒视频:老写法(多动作堆一起)的10条废了7条,砍成单动作的10条只废2条。差距就在这一刀上。
有人说那细节不就没了?细节留给画面描述和后期。指令里的动作位,就是留给主动作的。你要是真想加第二个动作,别加在同一条里,分开生成两段再剪,比赌一次成功率划算得多。
走路指令拆三层:方向、步数、速度
走路别只写"自然行走",按"朝哪个方向+走几步+什么速度"三层来写,例如"向镜头方向慢速走五步,裙摆轻摆"。
方向是说和镜头的关系:朝镜头走、横向走位、还是背对镜头往外走,三种出来的构图完全不同。步数管长度感,"走两步"和"走五步"是两个节奏。速度别写"快"这种字,写"正常步速"或"稍慢"。我实测写"快步走",十次里三次步频抽搐,腿像踩了缝纫机;改成"正常步速,稍慢"就稳多了。
转弯是另一个大坑。"边走边转身180度"这种写法,我试了6条废了4条。想转身,就单独做一个转身镜头。还有个小发现:我们店那条毛呢外套,横向走位的版本比正面走好看——正面走五步,到第四步左右脸部清晰度就往下掉,横走位因为脸一直偏在画面一侧,反而撑得住全程。
转头和微笑:给角度和程度,不给形容词
转头写角度(转头约60度看向镜头),微笑写程度(嘴角上扬的浅笑),优雅、灵动这类模糊词一律删掉。
你猜怎么着,写"优雅地微笑",出来的全是抿嘴假笑,看着像憋着什么。写成"嘴角轻微上扬的浅笑",出片就自然。原因不难理解:模型认程度,不认情绪词,你给它的描述越像参数,它执行得越准。
转头同理,而且是硬数字说话的:转头超过90度(比如经典回眸),我试的10条里6条脸崩,五官在转动到一半时糊掉;压到60度以内,10条里只崩1条。眨眼、挑眉这种微动作,新手阶段先别碰,加上之后废片率肉眼可见地往上走,等你单动作全稳了再说。
顺便提醒一句和指令无关但同样重要的事:如果是拿真人照片当参考生成,请勿用他人照片冒充本人生成,只用自己的授权素材。
一条能直接抄的模板,加三组翻车对照
模板是:人物外观+单一主动作+幅度数字+速度+一个镜头运动。先跑慢速小幅度档,稳了再逐步加细节。
套进例子里就是:穿米色针织衫的女模特站在纯白背景前,向镜头方向正常步速走五步,转头约45度看向镜头,镜头轻微跟随。5秒视频,生成一次大概40秒。同一个模板换服装、换场景就能反复用,比每次从零写省事。
| 指令写法 | 实际效果 | 我的评价 |
|---|---|---|
| 自然行走,微笑,转头,风吹裙摆 | 同手同脚,脸糊 | 典型反面教材,动作全挤一起了 |
| 向镜头方向慢速走五步,裙摆轻摆 | 步态稳,裙摆有动感 | 现在的主力写法,能直接用 |
| 转头约90度回眸看镜头 | 转动中段五官糊掉 | 想法好,幅度太大,改成45度再试 |
还有个新手常懵的点:一模一样的指令,跑两次结果也不一样,这是生成自带的随机性。别盯着一条反复抽卡,改一个词重跑,比原地重试更可能出好片。
写到最后回头看,新手第一次上手真正要过的关就一个:忍住不堆词。开篇那条四十多字的"豪华指令",现在让我重写,就剩十几个字,可出片率翻了四倍。指令写得克制,视频才动得自然。先把第一条五秒的视频跑出来,你就知道我说的全是实话。
常见问题
动作幅度参数到底调多少合适?
从0.3到0.5这一档起步,先求稳再求好看。小幅度跑通了,再往0.7试,一上来就拉满,崩的概率非常高。幅度和速度是两个东西,别混在一个词里调。
模特手指总崩,是指令写得不对吗?
不全是。手指是视频生成的通病,指令能帮的有限。避开手部特写镜头、别写精细手部动作(撩头发、捻裙角),能躲掉大半。真崩了就重跑,比调指令管用。
中文指令和英文指令哪个好?
主流工具对中文的支持已经够用,两者出片差异不大。描述完不完整比用什么语言重要得多,写清楚动作、幅度、速度,比换成英文更见效。
为什么一模一样的指令,两次生成结果不一样?
生成过程带随机性,同指令重跑会有差异,这是正常现象。想要更多变化就改措辞,想要接近的结果就多跑几次挑最好的那条,别指望百分百复刻。
5秒视频够用吗,能拉长吗?
电商详情页和短视频信息流里,5到8秒完全够用。拉到10秒以上,动作稳定性会往下掉,中后段糊的概率明显变高。需要长视频,分段生成再剪接更靠谱。
延伸阅读
- 全身ai绘画不断腿不切脚?画幅比例、留白与提示词写法——视频的起帧构图同样吃这一套,全身景别先在图里定稳
- ai绘画扣钱为什么对不上账?重复扣费、失败计费与省额度排查——视频烧额度比出图快,扣费疑云可以照这篇排查