陌生模特ai生成怎么避免撞脸真人?我的排查全流程
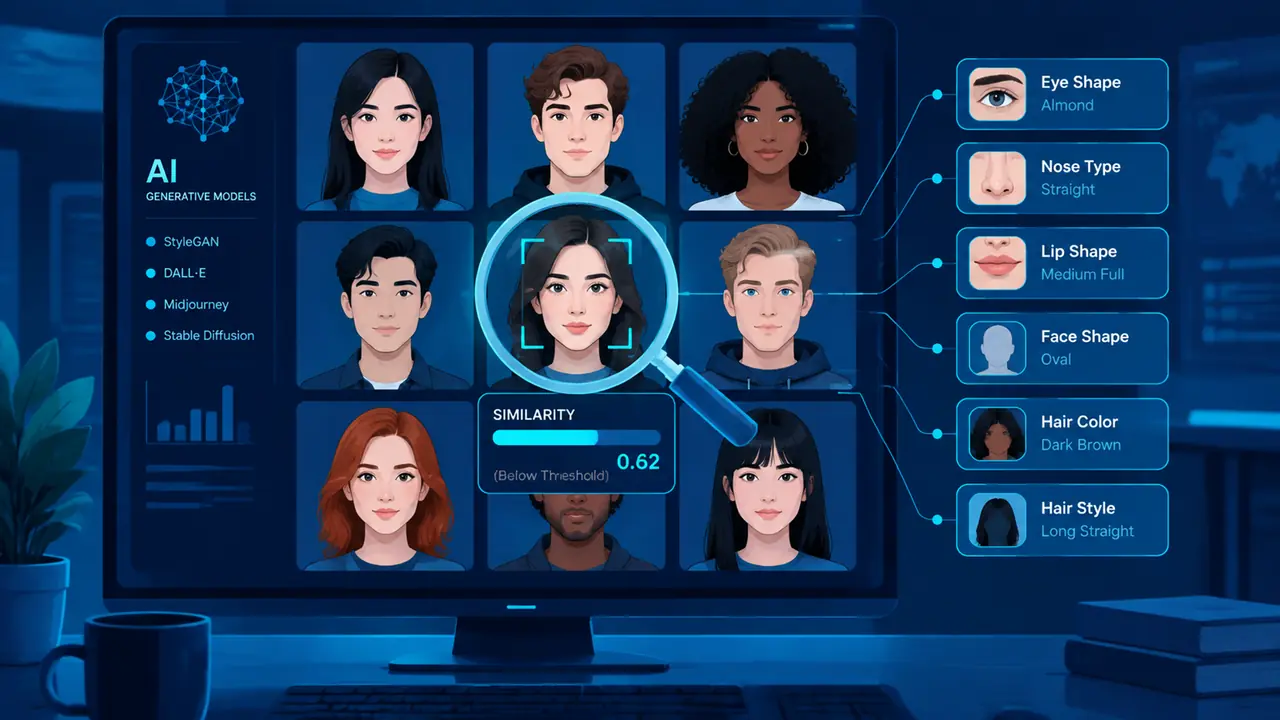
我的判断是:陌生模特ai生成的难点不在生成,在排查。提示词里不出现任何人名,纯靠特征词出脸,再用比对工具把相似度卡在阈值以下,这套流程走完,撞脸风险基本可控。
陌生模特ai生成这件事,我一开始也当玄学,直到出过一批图被客户指认"这像某歌手",才把它当成正经流程来管。结论先给:脸可以凭空生成,但每一张都得过排查,靠眼睛看不算数。
那批图客户一句"像谁"没多追究,我后背发凉——真发出去,肖像权纠纷比这批图的货值贵得多。从那以后我建了一套排查流程,用了大半年,废图记录记了两页,下面从头写。
陌生脸从哪来:只写特征,不写人名
提示词只描述五官特征与气质,绝不出现人名和明星类比词,用随机种子批量出脸再人工初筛。种子必须存档。
提示词层面我的写法是"圆脸、眉峰平、鼻头圆润、笑起来有卧蚕"这类特征组合,外加气质词"邻家感"。翻过车的地方在类比词:有次我顺手写了"像某女星的长相",十张里六张往那个方向长,删都删不干净。人名和"像某某"这类词,一概不进提示词。特征词怎么拆得细,我之前拆古风角色的五官衣料时练过一阵,思路相通,文末挂了链接。
种子要记。每张留下的脸我都存种子号和完整提示词,进一个表格,这张脸以后换装、换场景全靠它复现。没记种子的脸就是一次性的,这个亏我吃过——一张特别合适的脸复现不出来,气得想砸键盘。
还有个偷懒的办法别用:直接垫网红照片生成"不像一点"的版本。改出来的脸骨子里带着原图特征,比对工具照样报警,白忙一场。
排查全流程:眼睛之外还得有工具
正脸侧脸都放大看,再过一遍人脸比对,相似度卡在0.6以下,过线的图直接删,宁可错杀。顺序不能乱。
具体顺序是:先放大到200%看五官结构,对称性和牙齿过一遍;再切侧脸看轮廓,辨识度特征一半藏在侧脸里,下颌线和鼻梁这几处最容易眼熟;最后丢进比对工具,跟库里存的公众人物参考图比相似度,0.6是我定的线,过线就删。上一批五十张里删了三张,相似度全卡在0.62到0.65之间,看着不像,工具说像,我听工具的。
有个发现挺有意思:正面越普通的脸越安全,漂亮到扎眼的脸反而容易往名人特征上收敛,因为训练数据里精美脸的来源高度集中。现在我出图会刻意加"普通感"的词,客户接受度没掉,废片率倒是降了。
隔天复查这一步别省。我删掉的那三张,全是隔天再看才起疑的,当天眼被新鲜感糊住,隔天眼毒。
侧脸比正脸危险这个事,我有组数据:同一批生成的脸,正脸比对全在0.5以下,转到侧脸,三张飙过0.6。从那以后我库里每张脸都存一张侧脸基准图,换装复现时侧脸也重新比对一遍,不是只查正脸就签字放行。
建自己的陌生模特库:复用的边界在哪
排查过的脸垫权重0.5做参考复用换装,同一张脸累计出图超过五轮就重生成,防止细节漂移又变新人。库要有人口进出的规矩。
留下的脸我存进自家模特库,换装时垫这张脸当参考,权重0.5,服装垫图0.45叠上去。复用不是无限度的:一张脸我最多复用五轮,第六轮开始眉间距会悄悄变,等于换了个陌生人,之前的排查作废,得重新走一遍流程。
入库还有个仪式感的步骤:给每张脸起代号、记出身——种子号、生成日期、用过的类目,一样不能少。出过一次乌龙,两张脸的种子记串了,A脸的图用B脸的种子重生成,查了半天才对上账。现在表格里多了一列校验位,每次生成前先对一遍。
库的好处除了风格统一,还有个实际用途:多店铺矩阵各自用不同的脸,互不撞车,买家看不出是一家。提醒一句,生成的人脸再陌生,也请勿用于冒充他人身份,用途范围和授权模特一样要管住,这条我写进了团队交接文档。
回到开头那批差点出事的图——问题从来不是ai画不出陌生脸,是生成的人懒得排查。特征词代替人名、比对卡0.6、复用不超五轮,三件事做到位,这条路才算走得安心。图便宜,麻烦贵,账要算在前头。
常见问题
AI生成的脸有版权吗?
各平台口径不一,我按最保守的方式处理:留好生成记录和参数,合同里跟客户约定使用权归属,风险别压在自己一个人身上。
没有比对工具怎么办?
至少做到两件事:提示词彻底不带人名和类比词,出图后隔一天再复查。我删掉的那三张就是隔天抓出来的。
一张陌生脸可以用多久?
我按轮算不按时间算,五轮复用就换。量大的店铺一个月就到顶,量小的店铺一张脸能用一个季度。
自家的授权模特脸和陌生脸能混着用吗?
能,但分库存放,出图模板分开。混用最容易出的事故是拿错垫图,把授权脸垫进陌生脸的流程里,授权范围就乱了。