ai模特口令模板怎么搭?我的五件套结构
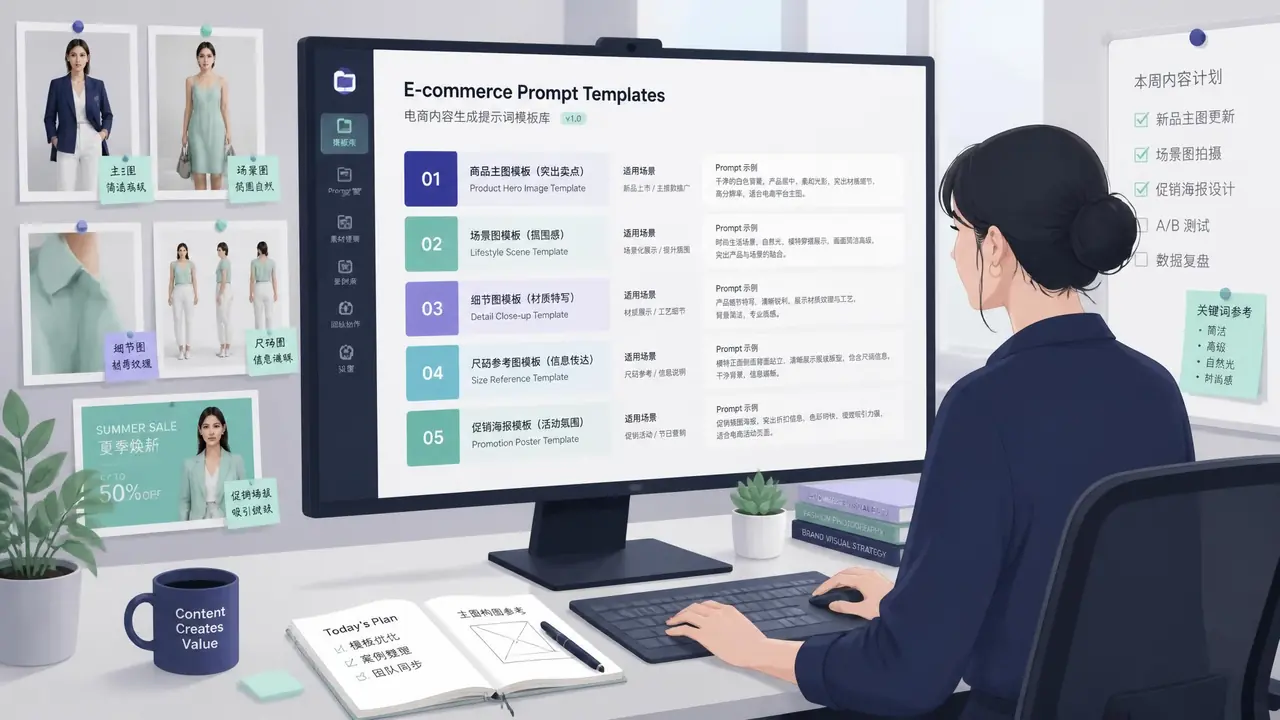
我的看法写在前面:口令模板的价值不在多,在结构。我把店里的口令整理成五件套——主体、服装、场景、光线、负向词,新人照结构填空,第一天就能出八成可用率的图。完整结构加两组套用示例在这篇里,出图返工多的人先看负向词那一段。
ai模特口令模板这个话题,群文件里躺着几十份"万能口令大全",我下过七份,能用上的不到一成。问题不在口令写得差,在你不知道它为什么好——没有结构,抄来就是一堆咒语。
我带一个五人内容小组,去年十月起把组里所有出图口令推倒重来,搭了五件套结构。三个月后,新人出图的可用率从五成五涨到八成二,改口令的争吵也少了,因为每一句都有它的位置。
背景交代下:我们是做女装加家居服的电商公司,每天出图量四百张上下。这个体量下,口令不是个人技巧,是公共资产,乱不得。
五件套:每件管一件事
口令五件套:主体(模特特征)、服装(款式面料)、场景(地点时段)、光线(光源方向质感)、负向词(禁止项)。五件各司其职,顺序建议就按这个来。
主体管"这个人是谁":年龄感、发型、表情、姿态。服装管"穿什么":款式、面料、合身度。场景管"在哪":室内外、时段、距离。光线管"什么光":方向、软硬、色温。负向词管"别画什么":崩手、多余的人、logo。
为什么顺序重要?我对比过同一组词的两种排法:结构乱的口令,AI会把光线词安到服装上,出图像蒙太奇。按五件套排,模型对每段的意图抓得准,同样的词,可用率差出一成五。这不是玄学,是模型解析长句时的注意力分配问题。
两组可以直接套的示例
示例一(日常女装):年轻女性、黑长直、自然微笑/米色针织连衣裙、垂坠面料/咖啡馆落地窗旁、午后/柔和侧逆光、暖调/负向:多余的人、变形手部。照这个骨架换成你的商品就能跑。
示例一完整版:"22岁左右亚洲女性,黑长直,自然微笑,站姿放松;米色针织连衣裙,垂坠面料,合身不紧绷;街角咖啡馆落地窗旁,午后;柔和侧逆光,暖色调,浅景深;避免:多余路人,手部变形,面部扭曲"。这条我们组跑针织品类,可用率八成五。
示例二换风格(运动品类):"25岁左右女性,高马尾,皮肤有光泽感;浅灰运动套装,速干面料,微宽松;城市步道,清晨;顺光偏侧,通透冷调;避免:复杂背景,logo变形,肢体扭曲"。运动品类的关键在面料词——"速干""有光泽感"决定衣服看起来是不是那回事。
填空时的三个高频错误说给你:一是负向词写"不要XXX",负向词区直接写名词就行,"不要"两个字反而引入干扰;二是场景写太长,超过二十个字模型就开始自由发挥;三是忘写合身度,"合身""微宽松"不写,AI默认给你画修身,退货理由就多一条"跟图不符"。
模板库的土管理办法
模板库三栏就够:品类、完整口令、可用率备注。每月复盘一次,砍掉可用率低于六成的条目,库越薄越好用。
我们的模板库是一张共享表格:品类、场景、完整口令、谁在用、上周可用率。每周五下午十五分钟复盘,连续两周可用率低于六成的口令直接砍。去年我们的库有二百多条,砍到现在八十六条,出图效率反而最高——选项少,人才不犹豫。
版本管理就一个土办法:改口令必须改名字,编号加日期,比如"A-03-0925"。改了不重命名的下场我们都尝过:组里跑着跑着发现两个人用的是"同一条"口令的不同版本,对了一下午的图对不上原因。
再补一条组规:任何人发现某条口令的崩点,当场把负向词补进表格再走,别攒着开周会说。负向词库就是这么一点一点喂肥的,等开会的功夫,同样的废图能再废二十张。
口令这东西说穿了像调味:五件套是锅底的骨架,你的商品是主料,负向词是撇浮沫。别追求一条口令打天下,按品类养一小锅自己的底料,比囤一百份"大全"实在。我们组现在的状态是,新人来了先背五件套,第二天就能干活。
常见问题
口令写英文好还是中文好?
国内主流出图工具中文已经很稳,我组里全用中文口令,可用率八成以上。个别工具对英文响应更细,建议先用中文跑通结构,真有瓶颈再换英文对比。
负向词应该写哪些?
按品类积累,通用款先放:多余路人、手部变形、面部扭曲、乱入文字。出废图时把崩点翻译成名词加进去,负向词区就是这么长出来的。
为什么照抄别人的口令出图还是差?
因为缺负向词和合身度这些"暗件",而且场景词对你拍摄的商品不一定适用。抄结构,别抄整句,这是用模板库的基本原则。
模板库多少条合适?
八九十条以内,砍到每个品类十来条最好。我们的经验是库越大越没人看,可用率低于六成的条目定期清理。
延伸阅读
- 衣服模特模板ai这样搭:八套模板跑完全店两百个款,从模板到产线的组织方式,跟这篇的结构可以拼成一套完整打法。