修图ai模型拆开看:你点的每个按钮背后是四类模型
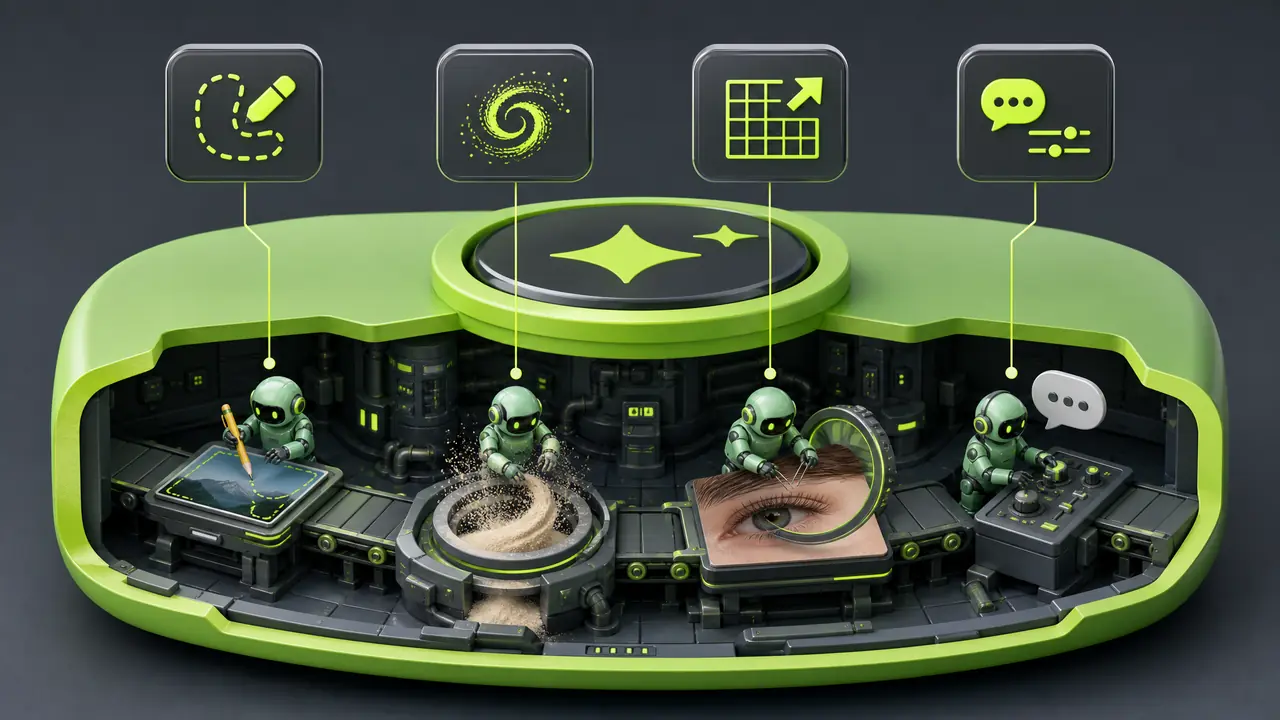
不夸张地说,修图工具的按钮换来换去,背后干活的就是四类模型:分割、重绘、超分、指令编辑。搞懂它们各自擅长什么,你就知道哪个按钮值得信、哪个按钮出活要手动收。一篇讲透,不堆术语。
修图ai模型的门道,就藏在你每天点的那些按钮里。祛瑕疵、智能抠图、变清晰、一键换背景,名字一个比一个花,底层翻来覆去就四类模型在轮班。我花了两周把常用功能的出图过程扒了一遍,做了些小实验,用大白话把每类模型干什么、什么时候掉链子讲清楚。看懂这篇,你选工具、用按钮就不是碰运气了。
分割模型:先认图,再动图
分割模型负责把图切成「天空、人、物体」这样的块,你用的自动抠图、自动选区,都是它在认图。它不改图,只标图。
打个比方,它像一只先用铅笔把画面里每样东西描一遍边的手。描完边,后面的工序才知道在哪动手。它的短板集中在半透明的东西上:婚纱、玻璃杯、发丝,描边描不准,所以白边总是出现在这几类地方,这不是巧合,是它原理上的坎。
知道这一点,手动收边的功夫就知道往哪花了。遇到毛边,别抱怨AI,直接切回手动图层擦,两三分钟的事。
我做过一个小实验:同一张纱裙照,自动抠图跑了三次,三次的白边位置一模一样。它的错是稳定的错,这不算坏事——错得稳定,手动补救的方案就能固定下来,做成动作存着,下次一键补救。
重绘换内容,超分补密度
扩散重绘模型负责「重画一块」,超分模型负责「凭理解补细节」,一个动内容,一个动密度。分工别搞混。
扩散重绘的工作方式,像从一团噪点沙子里一步一步把沙扫掉、把内容露出来,你框的选区就是它的工地。工地框得越小,它越守规矩;框得一大,它就开始自由发挥。我把一张图框了半边重绘,椅子凭空多出一条腿,就是给它发挥空间太大的下场。
超分模型是另一路:它见过海量图片,知道头发丝、砖缝大概长什么样,往小图上「脑补」出纹理。脑补就有猜的成分。我有次把老照片放大四倍,墙上的乱砌砖纹被它编成整齐的横条,好看,但那是编的。所以放大后的细节要当「合理推测」看待,涉及事实信息(招牌文字、纹样)必须回原图核对。
判断细节是「补的」还是「编的」,有个土办法:放大到百分之百看逻辑。砖缝该对齐的对没对齐,窗户的格子数前后一不一样。补出来的细节大体合理,编出来的细节经不起数数。
指令模型为什么偶尔不听话
指令编辑模型把你的话翻译成改动,翻译走样就出鬼图,指令写具体数字比写形容词管用。原因在语言那头。
它靠训练时的图文配对来理解语言,「把天空调亮一点」里的「一点」,在它那儿没有刻度,全凭猜。我把指令换成「天空亮度提高20%」之后,听话率高了一大截。形容词是给人听的,数字才是给模型听的。
写指令的门道,跟之前那篇ai修图提示词写法里讲的语法是一回事,会说话,模型才好干活。
还有个翻车点值得记:同一句指令连发五次,我拿到过五种结果,最好的一次和最差的一次差距像两个工具。随机性就藏在这,重要的图别只生成一次就收货,多跑两轮挑最好的。
四类模型放一张表里看
认图、改内容、补细节、听指令,四类模型各管一段,对应的按钮和短板都在表里。选工具前先对号。
| 模型类型 | 干什么 | 对应按钮 | 常见短板 |
|---|---|---|---|
| 分割蒙版类 | 认图切块 | 智能抠图、自动选区 | 半透明边缘出白边 |
| 扩散重绘类 | 重画局部 | 祛瑕疵、局部重绘、扩图 | 选区一大就自由发挥 |
| 超分类 | 补细节密度 | 变清晰、图片放大 | 细节是猜的,可能编造 |
| 指令编辑类 | 听话改图 | 一键换天、指令修图 | 模糊指令出随机结果 |
工具会倒闭,按钮会改名,这四类分工短期不会变。你以后看到任何新功能,先问一句它是哪类、短板在哪,用起来就稳了。
表里「常见短板」那一列是我吃亏吃出来的:白边、自由发挥、编细节、随机结果,四个词背后各有一堆废图。买工具之前拿这张表对照功能列表,销售话术就糊弄不了你。
搞懂这四类,再看修图软件的功能列表,就像提前看了后厨的岗位表:谁是老实人、谁爱自由发挥、谁的话要听一半,心里都有数。修图ai模型不神秘,神秘的是你不知道按钮背后派了谁。派活的人懂工人的脾气,活就不会差,修图这件事到现在还是这个理。
常见问题
模型越大,修图效果越好吗?
不一定,分工比块头要紧。小而专的分割模型干抠图,常常比大而全的通用模型还利索,选对类型比追参数表有用。
本地跑模型和云端修图差别在哪?
本地看显卡显存,速度和隐私占优;云端省硬件、模型更新快。修图量小直接云端,量大且在意原图隐私的,再考虑本地。
同一张图两次重绘,结果为什么不一样?
扩散模型带随机性,每次扫噪点的路径不同。想复现就把随机种子固定下来,种子一样,结果基本一致。
模型是怎么分清胡茬和皮肤脏点的?
训练时见过海量同类图,学的是统计规律。规律之内它很准,遇到罕见特征就容易误判,所以重要的图永远要人工过一遍。