AI训练修图模型喂什么图?数据标注员的半年实操
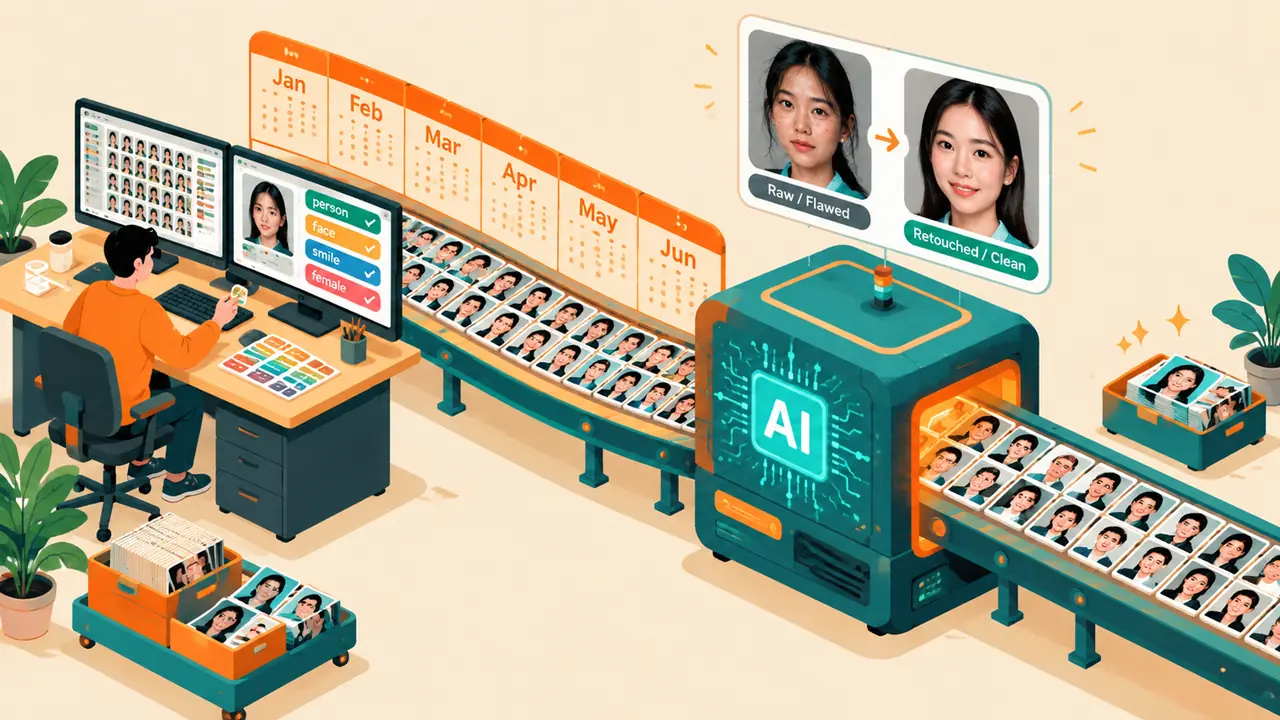
喂图有讲究:修图模型学得好不好,七分看喂进去的训练图,三分才是调参和算法。一批脏数据混进训练集,模型就能把人脸修成塑料壳。动手训练之前,先照文里的标准把你那批图筛一遍。
ai训练修图模型学得好不好,多半在你喂图那天就定了。我在一个做修图模型的团队干数据标注,从今年3月到现在,经手大概九万张人脸和静物图。我的判断很直接:模型修图一翻车,十有八九能追到数据这一层,算法背锅的日子该结束了。
修图模型每天吃进去的图,长什么样
修图模型吃的训练图,是成千上万组修图前和修图后的配对图,配对干不干净直接决定模型学得对不对。我们把这叫"一条链":原片一个文件夹,修图师修完的成片一个文件夹,文件名对得上就成对,模型学的是中间那一步手艺。
原片那边要求不算低。长边低于1000像素的直接进回收站,糊图也剔——我用脚本跑拉普拉斯方差初筛,低于100的标记出来人工复看一遍。修图师修完的成片才是重头,一个熟练修图师一天精修40到60张,量就这么大,急不来。
我的活卡在中间。要给人脸拉多边形框,痘印、斑点、法令纹、油光、碎发,一张脸平均6到9个框;再给整张图打场景分类,人像、静物、风景。状态好的时候我一天能过900张分类图,配对图复核一天500张封顶,再多错率就往上蹿。整个训练集的配比大概是这么摊的:人像七成,静物两成,风景一成,谁多谁少都是试出来的。
话说回来,刚入职那两周我以为这就是个体力活,拉框谁不会。后来发现自己太天真,框贴多紧、瑕疵算不算瑕疵,全是要跟算法组吵的事。
为什么同一批图,模型有的学好了有的直接学歪
模型不认对错只认规律,标签打歪它就把歪的当对的学,脏数据一多修图结果自然离谱。你喂什么它信什么,没有半点怀疑精神,这是它勤奋的地方,也是它吓人的地方。
今年5月那次翻车我记一辈子。那批图的主题是"自然皮肤质感",图库里混进了一批十年前的过度磨皮老图,标注那边把它们也归进了"自然皮肤"。两周之后测试集跑出来,模型把所有脸都磨成了塑料壳,毛孔一根不剩。客户在验收会上的原话是:"这个人像被抛光了。"我们回头一查,那批老图占了皮肤类别的14%,剔掉重训才缓过来。这类修图翻车的片子,逐张复盘过一遍比看十篇方法论都有用,有兴趣可以看这篇AI修图翻车片逐张复盘(/ai-art/ai-xiutu-41c8f7.html)。
口径不统一是另一个隐形杀手。"油光"和"高光"就差一线,我第一周跟同事互相抽检,两人打标一致率只有82%。82%什么概念?一万张图里有一千八百张两人说法不一样,模型全吞下去。后来组里定了标注手册,油光必须是T区和鼻翼、高光必须连着结构走,抽检一致率才拉到95%以上。
像教小孩认菜:你把香菜全标成葱花,他这辈子端上来一碗粉都分不清,还理直气壮。
半年实操攒下来的三条筛图标准
筛图先卡三关:原图分辨率、成片流程统一、标签口径一致,三关都过再谈量够不够。顺序不能反,量补不了质,一吨含沙的水照样没法喝。
第一关,原片质量。长边2048起步,有RAW更好。手机直出的图不是不能用,是噪点一多,模型连噪点一起学,修出来的皮肤会带一层奇怪的颗粒。
第二关,成片必须出自同一套流程。我们踩过这个坑:三个修图师,一个用Capture One,一个用PS加磨皮插件,一个手机App修完直接交,模型学成了四不像,输出一会儿冷调一会儿暖调。8月底我们把修图流程收成一份SOP,出片风格才稳住。
第三关,冷门类别要喂够。"眼镜反光"这种标签在训练集里只占2%,模型基本当没看见;我们给它过了采样,提到8%才有点反应。经验值是每个类别至少5000张才撑得起来,"白发转黑发"那个类我们凑了整整三周。
说实话,这套配比到今天我也不敢说是最优解,只能说是拿翻车换来的下限。你要是刚起步,先照下限来,跑通一轮再看误差落在哪,比一次想完美靠谱。
回到开头那句话:模型修图的水平,上限是算法定的,下限是你喂的图定的。我标的九万张图里,真正让模型变强的不是哪次调参,是5月剔掉那批磨皮老图的晚上。图库不脏,模型不歪,这半年我就信这一句。
常见问题
个人想微调一个修图模型,最少得准备多少张训练图?
几百张能跑通流程,看得到个大概方向,但输出不稳定。想拿去实际用,同类场景至少攒5000到10000张,其中配对图的质量比总数更要紧。预算紧张可以拿开源底模加少量自有数据做微调,重点把自有数据洗干净。
手上没有修图师,用现成滤镜批量生成配对图行不行?
行,但只能当补充。滤镜风格单一,模型学到的就是那几个参数的映射,学不会审美,遇到滤镜覆盖不到的图就露怯。我的建议是滤镜生成的图不超过两成,核心配对还是找真人修图师出,哪怕贵点。
标注用什么工具,个人有没有免费的选择?
有。labelme和Label Studio都是开源的,拉多边形框、打分类标签都够用,本地部署不吃配置。效率上有个窍门:先用一个大模型做预标注,人工只做修正和抽检,我这边的实测能省三到四成时间,抽检环节千万别省。